IntReal: датасет и набор метрик для генерации текста вместе с картинками
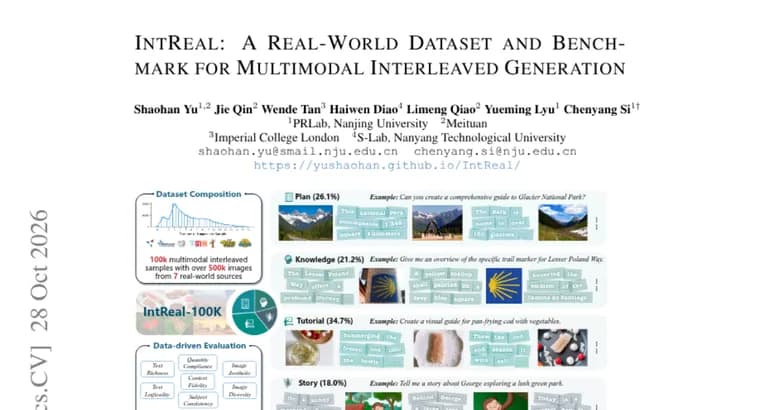
Люди обычно воспринимают мультимодальный контент, где текст и изображения естественно чередуются. Единые мультимодальные модели (Unified Multimodal Models, UMM) умеют генерировать и текст, и картинки, однако генерация такого чередующегося (interleaved) контента, по словам авторов, остаётся изученной слабо. Они называют две причины: нет чётко определённых задач и обучающих данных для такой генерации, и нет детальных протоколов оценки, которые позволяли бы надёжно диагностировать модель по разным направлениям.
В ответ авторы предлагают IntReal, который состоит из двух частей. Первая часть, IntReal-100K, представляет собой датасет реальных мультимодальных примеров с чередованием текста и изображений; он охватывает четыре крупные категории. Вторая часть, IntReal Evaluation Suite (набор оценок), измеряет качество моделей по семи взаимодополняющим измерениям с помощью специализированных экспертных моделей и позволяет проводить диагностику от грубой к тонкой.
Набор оценок авторы проверяют несколькими способами. Метрики слабо избыточны друг относительно друга: максимальная попарная абсолютная корреляция Спирмена не превышает 0,42. Согласие с человеческими оценками составляет 83,3% (в виде accuracy). Согласованность между разными экспертными оценщиками высокая: корреляция Спирмена выше 0,9. Из этого авторы делают вывод о взаимодополняемости и надёжности метрик.
Авторы протестировали четыре семейства UMM и утверждают, что набор оценок выявляет разные сильные и слабые стороны моделей. Эксперименты с дообучением показывают пользу IntReal-100K для улучшения чередующейся генерации. Кроме того, оказалось, что обучение генерации в одной модальности тоже помогает чередующейся генерации. Отсюда вывод: такая генерация может выигрывать от оптимизации под отдельную модальность и не требует совместного обучения на тексте и картинках на каждом этапе.
Ключевые факты
- IntReal состоит из датасета IntReal-100K (реальные примеры с чередованием текста и изображений, четыре крупные категории) и набора оценок IntReal Evaluation Suite.
- Набор оценок измеряет модели по семи взаимодополняющим измерениям с помощью специализированных экспертных моделей.
- Проверка набора: максимальная попарная абсолютная корреляция Спирмена между метриками не выше 0,42, согласие с людьми 83,3% (accuracy), согласованность между экспертными оценщиками выше 0,9 по Спирмену.
- Протестированы четыре семейства единых мультимодальных моделей; набор оценок показывает их разные сильные и слабые стороны.
- Дообучение на IntReal-100K улучшает чередующуюся генерацию, а обучение генерации в одной модальности тоже ей помогает.
Почему это важно
Единые мультимодальные модели умеют выдавать текст и изображения вместе, но, как отмечают авторы, чередующаяся генерация остаётся изученной слабо: не хватает чётко поставленных задач, обучающих данных и детальной оценки. IntReal пытается закрыть эти пробелы датасетом и набором метрик. Отдельный вывод работы: такая генерация может выигрывать от оптимизации под отдельную модальность, а не только от совместного обучения текста и картинок на каждом этапе.
Кому это важно
Исследователям и разработчикам единых мультимодальных моделей, которым нужны данные и метрики для генерации чередующегося текста и изображений. Также тем, кто строит бенчмарки и занимается диагностикой сильных и слабых сторон моделей.
Как это применить
Из текста источника следует, что IntReal-100K можно использовать для дообучения моделей на чередующейся генерации, а IntReal Evaluation Suite, для оценки по семи измерениям. Публичный ли релиз датасета и кода и на каких условиях, в источнике не сказано, поэтому проверяйте это на странице самой работы.
Можно ли доверять
Это препринт, и все утверждения принадлежат самим авторам. Заявленные показатели валидации набора (корреляция не выше 0,42, согласие с людьми 83,3%, согласованность оценщиков выше 0,9) взяты из аннотации; как именно измерено согласие с людьми и на скольких примерах, в источнике не сказано. Также не названы четыре протестированные семейства моделей и не приведены оценки по ним, поэтому проверить выводы о сильных и слабых сторонах по этому тексту нельзя.
Риски и подводные камни
Авторы лишь предполагают, что чередующаяся генерация выигрывает от оптимизации под отдельную модальность; это не доказанный факт. Размер улучшения после дообучения в источнике не указан. Четыре категории датасета и семь измерений оценки не названы, так что оценить охват и полноту набора по пересказу трудно. Метрики опираются на специализированные экспертные модели, и их согласованность проверена авторами самостоятельно.