Hugging Face выпустила TRL v1.14: обучение LoRA-адаптеров без NCCL
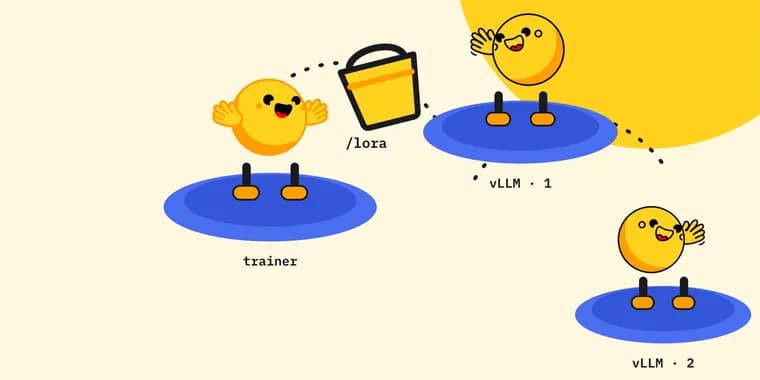
В библиотеке TRL от Hugging Face тренер AsyncGRPOTrainer научился обучать LoRA-адаптер и синхронизировать с vLLM только его, а не веса модели целиком: поддержка добавлена в PR #7017 и с этого момента входит в TRL v1.14. AsyncGRPOTrainer и раньше разносил обучение и генерацию по разным процессам, это было просто, когда оба процесса работают на одном узле или в кластере с общей файловой системой либо возможностью собрать группу NCCL. Пост описывает реальный проект поверх новой возможности, где тренировка и вывод вообще не делят машину между собой.
Обоснование того, что для RL хватает LoRA, авторы поста берут из блога Thinking Machines «LoRA Without Regret»: там показано, что LoRA не уступает полному дообучению в RL-методах, основанных на градиенте политики (policy-gradient), даже при ранге 1. Причина в том, что функция преимущества даёт всего около O(1) бита информации на эпизод: учиться на каждом шаге почти нечему, и ёмкости адаптера ранга 1 для этого достаточно. Отсюда и системное следствие: адаптер ранга 1 для модели на 1,5 млрд параметров весит несколько мегабайт, тогда как сама модель, около 3 ГБ. После каждого обновления инференс-воркерам можно рассылать только адаптер, а не всю политику целиком; vLLM при этом умеет держать сразу несколько адаптеров загруженными одновременно, так что уже начатые генерации завершаются на той версии политики, с которой стартовали, а новые сразу берут актуальную.
Дальше начинается инфраструктурная часть. Hugging Face Jobs устроены так, что один Job, это один контейнер на одной виртуальной машине; сейчас Job не может занять сразу несколько узлов, а лимит, 8×H200 на узел. AsyncGRPOTrainer же рассчитан на масштаб, где тренеру и целому флоту серверов vLLM одного узла может не хватать, отсюда и вопрос: как далеко можно уехать, если тренер и инференс-серверы в принципе не делят узел? При полной синхронизации весов ответ был бы «недалеко»: каждое обновление гоняло бы между машинами гигабайты, а именно для этого в плотном кластере и нужен NCCL, но отдельные задачи Jobs друг с другом по сети не связаны, общего локального диска нет, общего localhost тоже. С LoRA синхронизация, это несколько мегабайт, и для файловой части Hugging Face Jobs дают тома на основе объектного хранилища (Storage Bucket): такой бакет можно смонтировать как FUSE-файловую систему в каждой задаче и получить общую ФС между узлами вообще без сетевого пути между самими задачами.
Итоговая схема, три задачи Hugging Face Jobs: тренировочная задача с AsyncGRPOTrainer, LoRA и FSDP; две задачи с репликами vLLM, каждая на своём GPU, отдающие базовую модель плюс тот адаптер, который последним опубликовал тренер; один и тот же бакет, смонтированный во все три задачи по одинаковому пути, через него адаптер и попадает от тренера к серверам; и прокси-сервер. Каждые 4 шага оптимизатора (параметр weight_sync_steps=4) тренер сохраняет адаптер в версионированный путь вида <output_dir>/.vllm_lora/trl-policy-v{N}, публикует его атомарным переименованием и отправляет этот путь в эндпойнт /v1/load_lora_adapter у vLLM; vLLM читает файлы с диска, и после этого воркер генерации может запросить модель trl-policy-v{N}. Это тот же механизм рантайм-загрузки адаптеров, который в vLLM уже существовал, просто вместо сетевой ФС общий путь обеспечивает смонтированный бакет, и в самих TRL и vLLM менять для этого ничего не пришлось. Чекпоинты тренер сохраняет туда же каждые 50 шагов (save_steps=50), и финальный адаптер тоже всегда остаётся в бакете: задачи в Hugging Face Jobs недолговечны и могут быть прерваны, но благодаря этому прерванный тренер может возобновить обучение без потерь.
Адаптеры версионируют по имени намеренно, а не публикуют раз за разом под одним и тем же именем: vLLM кэширует свои KV-блоки по имени адаптера, и при одном фиксированном имени уже посчитанные блоки с предыдущей версии весов молча совпали бы с новой, генерация могла бы получить префилл от одной версии политики, а декодирование, от следующей, и тренер не смог бы это отследить, разве что заметил бы, что отношение (ratio) в его метриках уходит от 1. Версионированные имена закрывают это полностью: одно имя всегда означает один и тот же набор весов, и закешированный префикс никогда не совпадёт с более новой версией.
Число слотов под адаптеры на репликах vLLM считают от max_staleness, сколько версий политики может отстать сэмпл генерации, прежде чем тренер его отбросит. При max_staleness=4 сэмпл, сгенерированный под trl-policy-v3, всё ещё идёт в обучение, когда тренер уже на v7, а генерация, начатая под v3, обязана и закончиться под v3. Значит, в любой момент vLLM обязан обслуживать текущую политику и четыре предыдущие: тренер держит зарегистрированными max_staleness+1 версий адаптера и выгружает всё, что старше, а поскольку каждая синхронизация сначала загружает новую версию и только потом выгружает самую старую, на время этой подмены нужен ещё один слот, отсюда --max-loras 6. С пятью слотами вместо шести vLLM на каждой синхронизации молча вытеснял бы политику, под которой ещё шли незавершённые генерации. Каждая реплика vLLM, это один GPU и стоковый образ vllm/vllm-openai, закреплённый на версии v0.27.1: именно в ней нужные флаги и рантайм-эндпойнты LoRA ведут себя так, как описано в посте, поэтому версию vLLM авторы прямо называют частью самого рецепта. Реплики поднимают модель Qwen2.5-Math-1.5B с --max-model-len 4096, --enable-lora, --max-lora-rank 1 и --max-loras 6, а переменными окружения включают рантайм-загрузку адаптеров и эндпойнты /pause, /resume, /server_info, которые нужны TRL. На старте TRL опрашивает /server_info, и если там находится конфигурация LoRA, включает адаптерную синхронизацию (в логе должна появиться строка «Adapter-only vLLM sync enabled»); конфигурации, которые vLLM не умеет обслуживать напрямую, DoRA, modules_to_save или ранг выше --max-lora-rank, откатываются на синхронизацию полных весов с предупреждением.
Прокси нужен по двум причинам. Первая, обращение к портам задачи в Hugging Face Jobs требует заголовка Authorization: Bearer с токеном HF на каждый запрос, и именно прокси добавляет этот заголовок, так что сам TRL про него не знает. Вторая, TRL отказывается от адаптерной синхронизации, если у vLLM включён --data-parallel-size больше 1: запрос к /v1/load_lora_adapter в этом режиме доходит только до того DP-ранга, который на него ответил, а остальные ранги молча продолжают отдавать базовую модель под именем новой политики. На отдельных задачах Jobs такой проблемы нет в принципе, потому что каждая реплика, своя машина, и параллелизм по данным пришлось поднять на уровень выше, туда, где он разводит загрузку адаптера сразу на все реплики. Сам прокси-сервер запускается на 127.0.0.1:8000 прямо в тренировочной задаче, а TRL обращается к нему как к единственному серверу vLLM. Помимо заголовка, прокси делает две вещи: направляет каждый запрос генерации на ту реплику, где с наибольшей вероятностью уже закеширован нужный префикс (восемь параллельных генераций одного промпта должны попасть туда, где этот префикс уже посчитан), и рассылает на все реплики любые запросы, меняющие состояние, загрузку адаптера, паузу, возобновление, чтобы имя политики означало одно и то же на каждой реплике. Сама маршрутизация устроена так: если у реплики уже загружены блоки этого промпта и она отстаёт по числу запросов в работе от наименее загруженной не больше чем на 8, запрос уходит именно туда, это affinity hit; при большем отставании кеш не используют и отправляют запрос на наименее загруженную реплику, это spill, и туда же, сразу, уходит и совершенно новый промпт, для которого кешированных блоков нет ни у одной реплики.
Всю связку проверяли на датасете sail/Sanity-Test-R1D-1.5B, из статьи «Defeating the Training-Inference Mismatch via FP16» (Qi et al., 2025), код воспроизведения выложен как sail-sg/Precision-RL. Авторы этой статьи сгенерировали по 40 ответов на каждую задачу MATH моделью DeepSeek-R1-Distill-Qwen-1.5B и оставили только те, где успешность решения, от 20% до 80%: получилось 1460 вопросов. Такой набор хорош для проверки RL именно потому, что задачи в нём ни уже решены, ни совсем безнадёжны для модели, есть на чём получить ранний сигнал обучения, а пройти весь датасет целиком можно меньше чем за два часа. Это же делает его удобным сквозным тестом самой инфраструктуры: если одна из реплик vLLM молча начнёт отдавать базовую модель под именем адаптера, это будет видно на кривой обучения уже за несколько десятков шагов. Гиперпараметры взяли из LoRA-скриптов той же статьи: модель Qwen2.5-Math-1.5B, ранг LoRA 1 с alpha 2, скорость обучения 4e-5, 8 сэмплов на промпт, 128 генераций за шаг, до 3000 сгенерированных токенов и контекст на 4096 токенов. По метрикам AsyncGRPO видно, как те же 500 шагов ускорялись от прогона к прогону: первый прогон (r1-dp2) занял 3 ч 27 мин, а после упаковки микробатча (token_budget=16384), отключения gradient checkpointing, добавления третьей реплики и лимита в 384 одновременных запроса пятый прогон (r1-dp3-inflight384) уложился в 53 минуты при практически той же итоговой награде, почти в 3,9 раза быстрее; именно эти метрики, по словам авторов, и показывают, где в связке находится узкое место.
Ключевые факты
- TRL добавил в AsyncGRPOTrainer обучение LoRA-адаптера с синхронизацией только адаптера в vLLM вместо всех весов (PR #7017, TRL v1.14): адаптер ранга 1 для модели на 1,5 млрд параметров весит несколько мегабайт против около 3 ГБ у полной модели.
- Тренировочная задача и две реплики vLLM (по одному GPU, модель Qwen2.5-Math-1.5B) работают как три отдельные задачи Hugging Face Jobs на разных машинах без NCCL, адаптер передаётся через объектное хранилище (Storage Bucket), смонтированное как общая FUSE-файловая система во всех трёх задачах.
- Прокси на тренировочной задаче добавляет обязательный заголовок авторизации, направляет каждую генерацию на реплику с уже закешированным KV-префиксом промпта и рассылает загрузку новой версии адаптера сразу на все реплики vLLM.
- Адаптеры публикуются под версионированными именами (trl-policy-v{N}), потому что vLLM кэширует KV-префиксы по имени адаптера, общее имя незаметно смешало бы генерации от разных версий политики; при max_staleness=4 нужно --max-loras 6 (пять версий плюс один слот на подмену).
- На датасете из 1460 задач MATH с успешностью 20, 80% (из статьи Qi et al., 2025) по метрикам AsyncGRPO виден рост скорости того же рецепта на 500 шагов от прогона к прогону: с 3 ч 27 мин у первого прогона до 53 мин у пятого, после упаковки микробатча, отключения gradient checkpointing, добавления третьей реплики и лимита одновременных запросов, при практически той же награде, то есть почти в 3,9 раза быстрее.
Почему это важно
До этого совместная тренировка и генерация в TRL были просты только тогда, когда оба процесса делят один узел или могут собрать общую NCCL-группу, а полная синхронизация весов между отдельными машинами означает гонять между ними гигабайты на каждое обновление, для чего NCCL и нужен в плотном кластере. LoRA снимает это ограничение: адаптер ранга 1 весит несколько мегабайт против около 3 ГБ у полной модели на 1,5 млрд параметров, и его можно переносить между произвольными отдельными машинами через обычное объектное хранилище, а не через выделенную сеть кластера. Это открывает асинхронную GRPO-тренировку на инфраструктуре вроде Hugging Face Jobs, где один Job, это один контейнер на одной машине и объединить несколько машин в одну NCCL-группу нельзя: тренер и серверы вывода перестают быть частями одного кластера и становятся независимыми задачами, которые обмениваются только небольшим файлом через бакет.
Кому это важно
Тем, кто дообучает модели RL-методами (GRPO и другими алгоритмами на основе градиента политики) через TRL и запускает это на Hugging Face Jobs или похожей инфраструктуре без выделенной кластерной сети, теперь не нужен собственный NCCL-кластер, чтобы развести тренировку и генерацию по разным машинам. Инженерам, которые строят собственные пайплайны асинхронного RL и обслуживания LLM: описанный паттерн прокси, маршрутизация по закешированному KV-префиксу плюс рассылка изменений состояния на все реплики, переносим и за пределы связки TRL и vLLM, на любой сервинг с несколькими репликами на разных узлах. И тем, кто выбирает между полной синхронизацией весов и LoRA для своих RL-экспериментов: пост даёт конкретные цифры по размеру адаптера, числу слотов и версии vLLM, которые можно взять как отправную точку.
Как это применить
Из поста можно скопировать конкретный рецепт. Образ vllm/vllm-openai закреплён на версии v0.27.1, именно в ней нужные флаги (--enable-lora, --max-lora-rank, --max-loras) и рантайм-эндпойнты (/v1/load_lora_adapter, /pause, /resume, /server_info) работают так, как описано, поэтому версию vLLM стоит фиксировать как часть рецепта, а не брать последнюю. Число слотов под адаптеры считается по формуле max_staleness + 2 (в примере поста max_staleness=4 даёт --max-loras 6): пять версий политики нужно держать одновременно, а шестой слот нужен на время, пока новая версия уже загружена, а самая старая ещё не выгружена. Публиковать адаптер стоит под версионированным именем на каждую синхронизацию, а не перезаписывать одно и то же имя, иначе кэш префиксов vLLM может отдать генерацию, у которой начало и продолжение посчитаны на разных весах. А для инфраструктуры без общей сети между узлами (как отдельные Hugging Face Jobs) LoRA-синхронизацию можно возить через бакет объектного хранилища, смонтированный в каждый узел, вместо сетевой файловой системы, самим TRL и vLLM для этого менять ничего не пришлось, рантайм-загрузка адаптеров в vLLM уже существовала.
Можно ли доверять
Материал, официальный технический блог Hugging Face о собственном продукте (TRL и Hugging Face Jobs), а не независимая проверка со стороны; у поста указан авторский коллектив, Amine Dirhoussi, Quentin Gallouédec, Kashif Rasul, Sergio Paniego, и это стоит учитывать как источник. Ключевая техническая часть при этом проверяема напрямую: код добавлен открытым PR #7017 и вошёл в TRL v1.14, оба факта можно посмотреть в открытом репозитории. Результат по времени, ускорение с 3 ч 27 мин до 53 мин на тех же 500 шагов за пять последовательных прогонов с доработками рецепта, взят из собственных метрик AsyncGRPO. Качество итоговой политики пост тоже показывает: средняя награда растёт с 0,145 за первые 20 шагов до 0,438 за последние (0,416 в пятом прогоне), а ratio весь прогон держится в пределах 0,9993, 1,0004; нет только сравнения с точностью решений или внешними бенчмарками. Пост опубликован 10 сентября 2026 года.
Риски и подводные камни
Вся схема завязана на конкретную версию vLLM (v0.27.1), сами авторы предупреждают, что vLLM меняется быстро и нужные флаги с эндпойнтами относятся именно к этой версии, так что на других сборках рецепт может потребовать переделки. Поддерживается только конфигурация, которую vLLM способен обслужить напрямую: DoRA, modules_to_save или ранг LoRA выше --max-lora-rank откатывают синхронизацию на полные веса с предупреждением в логе, и всё преимущество схемы по объёму трафика при этом теряется. Проверено это на модели в 1,5 млрд параметров: две реплики vLLM были только в стартовой схеме и первых трёх из пяти прогонов, а два последних прогона шли уже с тремя репликами, и лучший результат, 53 минуты на 500 шагов, получен именно на трёх; переносится ли рецепт на модели покрупнее, пост не говорит. Стоимость самой инфраструктуры пост называет: тренировочная задача берёт h200x2, каждая из двух реплик vLLM, по одному h200, и все три задачи вместе обходятся примерно в 20 долларов в час; сравнения с тем, во что обошёлся бы единый кластер, пост не даёт.