Harness-S: ИИ-агентов обучают на сбоях через «братские» обвязки
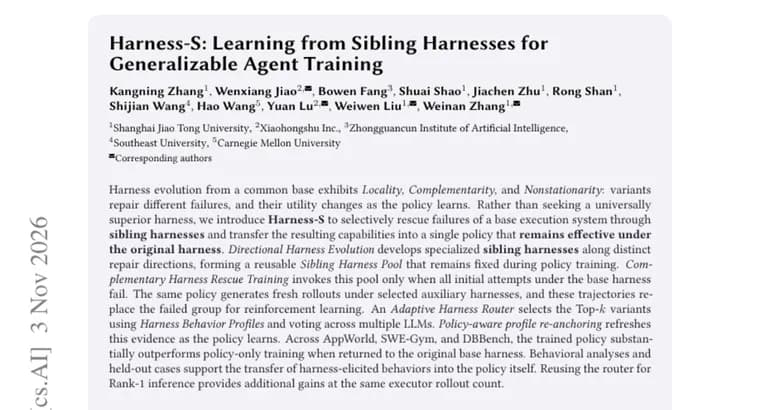
В статье, опубликованной в разделе Hugging Face Papers, описан метод Harness-S для обучения ИИ-агентов с подкреплением. Исходное наблюдение такое: если развивать обвязку (harness, то есть исполняющую систему вокруг модели) из общей базы, получаются варианты с тремя свойствами. Они локальны (Locality), взаимодополняют друг друга (Complementarity) и нестационарны (Nonstationarity): разные варианты чинят разные сбои, а их полезность меняется по мере того, как учится политика.
Поэтому авторы статьи не ищут одну универсально лучшую обвязку. Harness-S выборочно «спасает» провалы базовой исполняющей системы с помощью «братских» обвязок (sibling harnesses) и переносит получившиеся умения в единую политику, которая остаётся эффективной при возврате к исходной обвязке.
Метод состоит из нескольких частей. Directional Harness Evolution (направленная эволюция обвязок) развивает специализированные «братские» варианты по разным направлениям исправления и собирает из них многоразовый пул (Sibling Harness Pool), который остаётся неизменным во время обучения политики. Complementary Harness Rescue Training обращается к этому пулу только тогда, когда провалились все первоначальные попытки в базовой обвязке. Тогда та же самая политика заново проходит задачу в выбранных вспомогательных обвязках, и эти траектории заменяют провалившуюся группу при обучении с подкреплением.
Выбор вспомогательных вариантов делает Adaptive Harness Router: он отбирает Top-k вариантов по профилям поведения обвязок (Harness Behavior Profiles) и голосованию нескольких больших языковых моделей. По мере обучения политики эти данные обновляются механизмом policy-aware profile re-anchoring.
Результат, по заявлению авторов: на AppWorld, SWE-Gym и DBBench обученная политика, возвращённая в исходную базовую обвязку, существенно превосходит политику, обученную только собственными силами (policy-only training). Анализ поведения и отложенные примеры, как утверждается, подтверждают, что поведение, вызванное обвязками, действительно перешло в саму политику. Кроме того, повторное использование роутера для инференса Rank-1 даёт дополнительный выигрыш при том же числе прогонов исполнителя.
Ключевые факты
- Harness-S использует «братские» обвязки, чтобы спасать провалы агента в базовой обвязке во время обучения с подкреплением, и переносит навыки в единую политику.
- Пул «братских» обвязок создаётся направленной эволюцией и остаётся неизменным при обучении; к нему обращаются только если все первые попытки в базовой обвязке провалились.
- Адаптивный роутер выбирает Top-k вариантов по профилям поведения обвязок и голосованию нескольких моделей, а профили обновляются по мере обучения политики.
- На AppWorld, SWE-Gym и DBBench обученная политика в исходной обвязке существенно превосходит обучение только политики; роутер на инференсе Rank-1 даёт ещё прирост при том же числе прогонов исполнителя.
Почему это важно
Качество ИИ-агента зависит не только от модели, но и от обвязки вокруг неё, а разные варианты обвязки исправляют разные ошибки. Harness-S предлагает не искать одну лучшую обвязку, а использовать несколько вариантов как «страховку» во время обучения, чтобы в итоге получить одну политику, работающую в обычной обвязке без помощников.
Кому это важно
Исследователям и инженерам, которые обучают агентов с подкреплением на задачах вроде работы с приложениями (AppWorld), исправления кода (SWE-Gym) и баз данных (DBBench), и тем, кто сравнивает разные обвязки для агентов.
Как это применить
Прямой инструкции по внедрению в тексте нет. Идея для практиков: создать набор вариантов обвязки по разным направлениям исправления, фиксировать его на время обучения, подключать только при полном провале попыток в базовой обвязке, а выбор вариантов поручать роутеру с профилями поведения. Детали реализации стоит искать в полной версии статьи.
Можно ли доверять
Это препринт, и все утверждения принадлежат его авторам. Приведённый текст говорит лишь о том, что результат «существенно» лучше, без процентов и баллов, поэтому размер выигрыша оценить нельзя. Авторы и организации в тексте не указаны, как и то, какая базовая модель обучалась и какие модели голосуют в роутере.
Риски и подводные камни
Размер улучшения не раскрыт количественно, так что практическая ценность метода неочевидна. Не указаны затраты на вычисления, время обучения, размер пула «братских» обвязок и значение k в Top-k. Метод опирается на роутер с голосованием нескольких моделей, что может усложнять обучение. О публикации кода или моделей в тексте не говорится.