GSTAR сжимает токены изображений в 32 раза и ускоряет генерацию в 20 раз
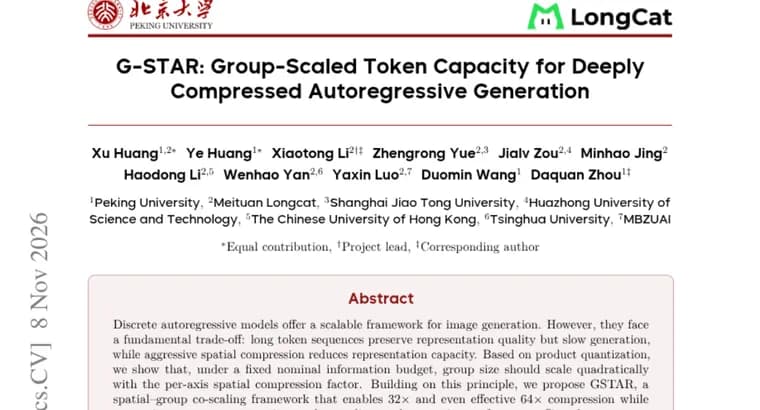
Дискретные авторегрессионные модели считаются масштабируемым подходом к генерации изображений, но у них есть фундаментальный компромисс. Длинные последовательности токенов сохраняют качество представления, но замедляют генерацию, а агрессивное пространственное сжатие снижает ёмкость представления.
Авторы статьи опираются на продуктовое квантование (product quantization) и показывают: при фиксированном номинальном информационном бюджете размер группы должен расти квадратично относительно степени пространственного сжатия по каждой оси. На этом принципе они строят GSTAR, фреймворк совместного масштабирования пространства и групп (spatial, group co-scaling). Он позволяет сжимать токены в 32 раза и даже, как сказано в аннотации, в «эффективные» 64 раза, сохраняя, по словам авторов, сильные результаты в реконструкции, понимании и генерации.
Более крупные группы создают зависимости внутри группы, которые нужно моделировать эффективно. Поэтому авторы анализируют их влияние на задержку вывода и качество генерации и вводят полуавторегрессионный декодер: он сочетает параллельное вычисление признаков с лёгким причинным (каузальным) моделированием.
Итог, по заявлению авторов: сильно сжатые модели конкурентоспособны с ведущими моделями на пяти показательных бенчмарках генерации изображений по тексту, GenEval, DPG-Bench, PRISM, LongText-Bench и Qwen-Image-Bench. При разрешении 1024×1024 модель даёт ускорение в 20 раз по сравнению с предыдущими дискретными авторегрессионными моделями и генерирует каждое изображение за 2,5 секунды на одной NVIDIA H200. Вывод авторов: сильно сжатые дискретные представления способны обеспечить качественную авторегрессионную генерацию с низкой задержкой.
Ключевые факты
- GSTAR, фреймворк совместного масштабирования пространства и групп для дискретной авторегрессионной генерации изображений; он даёт сжатие токенов в 32 раза и «эффективно» в 64 раза.
- Теоретический принцип на основе продуктового квантования: при фиксированном номинальном информационном бюджете размер группы должен расти квадратично относительно сжатия по каждой оси.
- Для зависимостей внутри крупных групп введён полуавторегрессионный декодер: параллельное вычисление признаков плюс лёгкое причинное моделирование.
- Заявлено ускорение в 20 раз относительно прежних дискретных авторегрессионных моделей: изображение 1024×1024 за 2,5 секунды на одной NVIDIA H200.
- По словам авторов, качество конкурентоспособно с ведущими моделями на пяти бенчмарках: GenEval, DPG-Bench, PRISM, LongText-Bench, Qwen-Image-Bench.
Почему это важно
Скорость генерации, одно из главных ограничений авторегрессионных моделей изображений: чем больше токенов, тем дольше ждать результат. GSTAR предлагает не просто сильнее сжимать картинку, а одновременно увеличивать размер группы по понятному правилу (квадратичный рост относительно сжатия по оси), чтобы не терять ёмкость представления. Если заявленные цифры подтвердятся, это довод в пользу того, что дискретные авторегрессионные модели могут давать качественные изображения с низкой задержкой: 2,5 секунды на 1024×1024 на одной H200.
Кому это важно
Исследователям генерации изображений и токенизаторов, особенно тем, кто работает с дискретными авторегрессионными моделями и продуктовым квантованием. Также будет интересно командам, которых волнует задержка при выводе изображений. Для рядовых пользователей это пока теоретическая работа: в аннотации речь идёт о методе и результатах на бенчмарках, а не о готовом продукте.
Как это применить
Практически применить результат пока можно лишь как идею: связывать размер группы в квантовании с пространственным сжатием (рост группы пропорционально квадрату сжатия по оси) и добавлять полуавторегрессионный декодер для внутригрупповых зависимостей. Для воспроизведения нужно изучить полный текст статьи; в аннотации нет деталей реализации.
Можно ли доверять
Это препринт на странице Hugging Face Papers, и все цифры в нём, заявления самих авторов. Аннотация говорит лишь о «конкурентоспособности с ведущими моделями» на пяти бенчмарках, конкретных баллов не приводит. База для сравнения «20 раз», «прежние дискретные авторегрессионные модели» без уточнения, какие именно. Независимой проверки в материале нет.
Риски и подводные камни
Ускорение в 20 раз и время 2,5 секунды относятся к конкретному разрешению (1024×1024) и конкретному железу (одна NVIDIA H200); на другом оборудовании результат может отличаться. Сжатие в 64 раза названо «эффективным», и из аннотации неясно, для какой настройки измерена скорость. Фраза «конкурентоспособно» не равна «лучше»: без таблиц оценить, чем платит качество за скорость, нельзя. Сравнение стоит делать по полному тексту статьи.
«Вместе эти результаты показывают, что сильно сжатые дискретные представления могут обеспечить высококачественную авторегрессионную генерацию с низкой задержкой.»
— из аннотации статьи о GSTAR