Google представила ToolGrad, метод генерации данных для обучения ИИ работе с инструментами
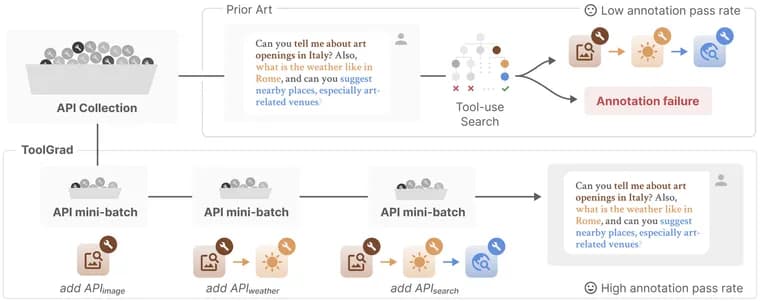
Google Research 10 сентября 2026 опубликовала пост о ToolGrad, методе из статьи, представленной на конференции ACL 2026. Пост подписан научным сотрудником Чжунъи Чжоу (работу он вёл в статусе приглашённого исследователя в Google) и Жофэй Ду, руководителем направления «интерактивное восприятие и графика» в Google XR. Метод меняет порядок генерации обучающих данных для языковых моделей, которым нужно научиться пользоваться внешними инструментами, поиском, файлами, запуском кода.
Чтобы обучить модель этому, нужны пары «запрос пользователя, цепочка вызовов инструментов». Ручная разметка, которую авторы использовали в своём более раннем проекте InstructPipe, не масштабируется. Автоматические методы вроде ToolBench и ToolACE сначала придумывают гипотетический запрос пользователя, а затем ищут для него решение поиском в глубину (DFS), по словам авторов, это по сути дорогая попытка выделить удачные траектории из сложного перебора агента.
ToolGrad переворачивает порядок: сначала строит проверенную цепочку вызовов API, а уже под неё языковая модель формулирует подходящий запрос пользователя. Превратить готовое решение в вопрос, по словам авторов, куда проще и требует всего одного шага модели, тогда как поиск решения под произвольный запрос требует полноценного перебора. Идею авторы называют «текстовыми градиентами», по аналогии с методом TextGrad, который раньше применял похожий принцип (текстовый отзыв LLM-критика вместо числового градиента) для улучшения текста запроса к модели; ToolGrad использует такую же обратную связь, но для итеративной сборки цепочек вызовов из большой библиотеки инструментов. Внутри фреймворка четыре модуля, предложение, выполнение, отбор и обновление, которые повторяются по кругу и на выходе дают тройку: запрос пользователя, проверенная цепочка вызовов API и итоговый ответ модели.
Авторы проверили подход на базе ToolBench, где собраны данные о свыше 16 тысячах реальных API: по их данным, ToolGrad генерирует более сложные цепочки вызовов с более высокой долей успеха и дешевле, чем исходный подход с DFS-поиском на той же базе. На полученном наборе ToolGrad-500 дообучили модели Gemma-3 на 1, 4 и 12 миллиардов параметров, получились ToolGrad-1B, ToolGrad-4B и ToolGrad-12B. Их проверили на бенчмарке BFCL (Berkeley Function Calling Leaderboard) с набором инструментов, отличным от обучающего у ToolBench, то есть на инструментах, которых модель не видела при дообучении. Сравнение шло с тремя группами: с исходными версиями тех же моделей без дообучения, с проприетарными моделями уровня Gemini, GPT и Claude и со специализированными на работе с инструментами моделями ToolACE и Hammer-2.1-7B. Числовых результатов сравнения в самом посте нет: авторы пишут лишь, что модели, дообученные на данных ToolGrad, превосходят модели, обученные на данных прежних методов, и сравниваются по качеству с проприетарными моделями на этих незнакомых инструментах, а компактные дообученные модели («ученики») в отдельных случаях превосходят модели, которые пост называет их «учителями», какие конкретно модели имеются в виду, не указано.
По итогам авторы заявляют почти стопроцентную долю успешных генераций данных и делают вывод, что относительно компактные модели способны показывать высокое качество работы с инструментами, если их обучить на данных, построенных в обратном порядке. Дальше они планируют расширить подход на более динамичные и обширные наборы API и добавить возможность непрерывного обучения «на ходу» для персонализации агентов со временем, авторы связывают это с ростом числа агентных сценариев в бизнесе и повседневных задачах. В посте не сказано, что означает цифра «500» в названии набора ToolGrad-500, и не уточняется, будут ли опубликованы код, сам набор данных или веса дообученных моделей Gemma-3.
Ключевые факты
- Google Research 10 сентября 2026 представила ToolGrad, метод из статьи на ACL 2026, который сначала строит проверенную цепочку вызовов API, а потом придумывает под неё запрос пользователя, в обратном порядке к ToolBench и ToolACE.
- Прежний подход сначала выдумывает гипотетический запрос и ищет решение поиском в глубину (DFS); по словам авторов, превратить готовое решение в запрос куда дешевле, нужен всего один шаг модели.
- Фреймворк состоит из четырёх модулей, предложение, выполнение, отбор, обновление, и заимствует идею «текстовых градиентов» у метода TextGrad; проверен на базе ToolBench из свыше 16 тысяч реальных API.
- На данных ToolGrad (набор ToolGrad-500) дообучили Gemma-3 на 1, 4 и 12 млрд параметров; на бенчмарке BFCL с непривычным набором инструментов эти модели, по данным авторов, превосходят модели, обученные на данных прежних методов, и сравниваются по качеству с проприетарными моделями уровня Gemini, GPT и Claude, точных цифр пост не приводит.
- Авторы заявляют почти стопроцентную долю успешных генераций данных; неизвестно, будут ли опубликованы код, сам набор данных ToolGrad-500 или веса дообученных моделей.
Почему это важно
Чтобы научить языковую модель пользоваться инструментами, поиском, файлами, запуском кода, нужно много пар «запрос, решение». Ручная разметка не масштабируется, а старые автоматические методы (ToolBench, ToolACE) дороги: они сначала выдумывают запрос, а потом ищут под него решение поиском. ToolGrad меняет порядок, сперва строит проверенное решение, потом формулирует запрос под него, и это, по словам авторов, требует всего одного шага модели вместо полноценного перебора. Сам пост связывает это с ростом числа агентных сценариев в бизнесе и повседневных задачах.
Кому это важно
Командам, которые дообучают модели вызывать функции и работать с внешними инструментами, и разработчикам компактных открытых моделей, в примере это Gemma-3 на 1, 12 млрд параметров, которым важно приблизиться по качеству к крупным проприетарным моделям без их размера и цены. Также релевантно исследователям синтетических данных для агентов и авторам методов, с которыми пост сравнивает подход, ToolBench, ToolACE, InstructPipe. Пост подписан научным сотрудником Google Research Чжунъи Чжоу и руководителем направления «интерактивное восприятие и графика» в Google XR Жофэй Ду.
Как это применить
Внутри ToolGrad, четыре модуля (предложение, выполнение, отбор, обновление), которые повторяются по кругу и на выходе дают тройку «запрос, проверенная цепочка вызовов API, итоговый ответ». Авторы прогнали метод на базе ToolBench (свыше 16 тысяч реальных API), собрали набор ToolGrad-500 и дообучили на нём Gemma-3 трёх размеров, 1, 4 и 12 млрд параметров. Результат проверяли на бенчмарке BFCL с набором инструментов, которого не было в обучении, то есть в условиях, близких к работе с незнакомыми API. В посте нет ни кода, ни готового набора данных, ни весов моделей, и не сказано, планируют ли их открыть, так что повторить эксперимент по одному этому материалу нельзя.
Можно ли доверять
Источник, официальный блог Google Research, то есть рассказ авторов о собственной статье, представленной на профильной конференции по обработке естественного языка ACL 2026 (рецензируемая площадка). При этом сам пост не приводит числовых оценок сравнения моделей, модели превосходят те, что обучены на данных прежних методов, и сравниваются с проприетарными моделями, это качественные утверждения авторов без таблиц и цифр в тексте; единственное число в посте, заявленная авторами почти стопроцентная доля успешных генераций данных, и не указано, какие именно модели пост называет «учителями», которых превосходят дообученные «ученики». Проверить цифры можно только по самой статье ACL 2026, а не по блог-посту.
Риски и подводные камни
Все сравнения, от самих авторов метода, независимой проверки в посте нет. Метод протестирован на инструментах из одной базы (ToolBench), а способность обобщаться на другие API за её пределами подтверждена только качественно, без цифр из BFCL. Значение «500» в названии набора ToolGrad-500 в посте не раскрыто, как и то, будут ли открыты код, сам набор данных или веса дообученных моделей Gemma-3, без этого независимо воспроизвести результат не получится. Качество получаемых данных также зависит от самой модели, которая выступает «критиком» и формирует текстовые градиенты, её собственные ограничения в посте не разбираются.