GLIE сжимает эмбеддинги для поиска по документам и сохраняет почти 80% точности
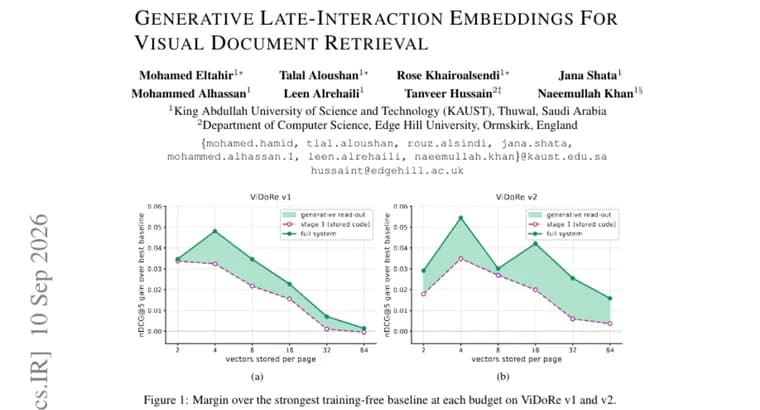
Поиск с поздним взаимодействием (late interaction), лучший на сегодня подход к поиску по визуальным документам, но за точность он платит хранилищем: на каждую страницу приходится держать около тысячи векторов. Существующие методы сжатия оставляют подмножество этих векторов или их локальное усреднение, но при жёстких лимитах хранилища резко теряют точность, а альтернативы требуют переобучения кодировщика.
Изучив эту деградацию на трёх кодировщиках, авторы обнаружили два устойчивых геометрических свойства: векторы страницы лежат точно на единичной сфере и концентрируются вблизи многообразия с внутренней размерностью пять-шесть.
Из этой геометрии следуют два вывода. Первый: стандартные центроиды k-means оказываются внутри сферы, а не на её поверхности, из-за чего систематически занижаются оценки MaxSim; нормализация центроидов на поверхность сферы, бесплатная поправка, дающая прирост до +0,093 nDCG@5 по сравнению с исходными центроидами. Второй: поскольку у многообразия страницы мало степеней свободы, весь набор векторов можно восстановить всего по нескольким из них.
На этой основе авторы представили Generative Late-Interaction Embeddings (GLIE): k векторов на страницу (k много меньше N), обученных на нормализованных центроидах и служащих одновременно компактным индексом и базой для восстановления полного набора эмбеддингов страницы. При поиске запрос сопоставляется только с этими k векторами, а декодер разворачивает обратно в полный набор из N векторов лишь топ-кандидатов, для точного пересчёта оценки.
На бенчмарке ViDoRe v1 при четырёх векторах на страницу GLIE сохраняет почти 80% nDCG@5 несжатой системы, против 70% у лучшего из прежних методов посткомпрессии. При этом сеть декодера содержит всего 415 тысяч параметров и обучается меньше чем за три GPU-минуты на тысяче страниц. При равном бюджете обучения дообучение кодировщика не дотягивает даже до результата GLIE без обучения декодера вовсе, а полная система GLIE превосходит дообучение кодировщика на любом бюджете. Эти закономерности подтвердились и на втором кодировщике, и на бенчмарке ViDoRe v2.
Ключевые факты
- GLIE сжимает около тысячи векторов на страницу до горстки (k), сохраняя возможность восстановить полный набор через декодер.
- Геометрическое открытие: векторы страницы лежат точно на единичной сфере и концентрируются у многообразия размерности пять-шесть.
- Нормализация центроидов k-means на поверхность сферы, бесплатная поправка с приростом до +0,093 nDCG@5.
- При четырёх векторах на страницу на ViDoRe v1 GLIE сохраняет почти 80% точности (nDCG@5) против 70% у лучшего прежнего метода.
- Сеть декодера, 415 тысяч параметров, обучение занимает меньше трёх GPU-минут на тысяче страниц.
Почему это важно
Поиск с поздним взаимодействием (late interaction) точнее конкурентов, но хранит порядка тысячи векторов на страницу, это дорого в масштабе. GLIE показывает, что резкую деградацию при агрессивном сжатии можно обойти не эвристикой отбора векторов, а геометрическим фактом: набор векторов страницы имеет всего пять-шесть степеней свободы, а значит его можно почти полностью восстановить из горстки обученных представителей вместо хранения всех тысячи.
Кому это важно
Разработчикам систем поиска по визуальным документам, сканам, PDF, скриншотам страниц, которым нужно снижать затраты на хранение индекса без переобучения основного кодировщика. Полезно и исследователям, изучающим сжатие эмбеддингов: работа переносит задачу компрессии в русло геометрии представлений, а не отбора или усреднения векторов.
Как это применить
Часть выигрыша достаётся бесплатно и без обучения: нормализация центроидов k-means на поверхность единичной сферы уже даёт прирост до +0,093 nDCG@5 над исходными центроидами. Полный выигрыш требует обучить декодер GLIE, сеть на 415 тысяч параметров, которая в описанном эксперименте обучилась меньше чем за три GPU-минуты на тысяче страниц, то есть заметно дешевле, чем дообучение самого кодировщика.
Можно ли доверять
Источник, аннотация статьи, не сама публикация целиком; имена авторов и институтов, а также названия использованных кодировщиков в аннотации не указаны. Результаты воспроизведены на трёх кодировщиках при изучении деградации и подтверждены на втором кодировщике и на втором бенчмарке (ViDoRe v2), что говорит в пользу устойчивости эффекта, но независимой проверки за пределами самой статьи пока нет.
Риски и подводные камни
Аннотация называет долю сохранённой точности «почти 80%» без точной цифры, так что реальный результат может быть немного ниже. Не сказано, выложены ли код или веса GLIE и планируется ли это, судить о доступности метода для практического внедрения пока нельзя. Схема также добавляет декодер как отдельный шаг на этапе поиска: он разворачивает векторы только для топ-кандидатов, но это дополнительное вычисление и источник новых ошибок по сравнению с прямым хранением полного набора векторов.