Гибридная модель HDM сама решает, когда ей нужно думать, а когда отвечать сразу
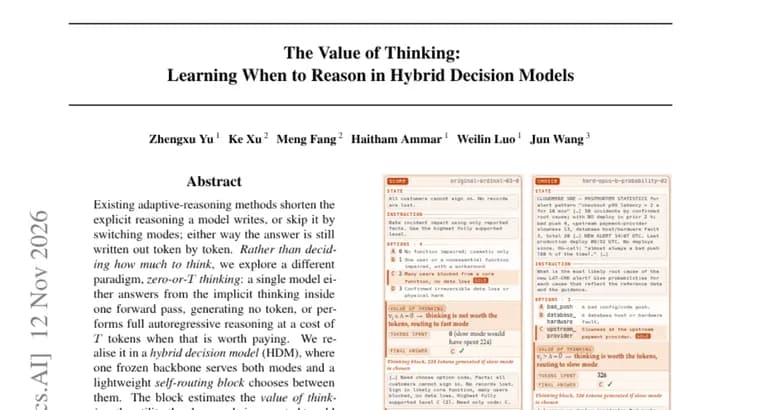
Существующие методы адаптивного рассуждения либо сокращают письменное рассуждение модели, либо пропускают его, переключая режимы. Но в любом случае ответ всё равно записывается токен за токеном. Авторы статьи предлагают другой подход, который называют «zero-or-T thinking» («ноль или T»): одна модель либо отвечает на основе неявного обдумывания внутри одного прямого прохода, не генерируя ни одного токена, либо выполняет полное авторегрессионное рассуждение ценой T токенов, когда это стоит затрат.
Этот подход реализован в гибридной модели принятия решений (hybrid decision model, HDM). В ней одна замороженная базовая модель (backbone) обслуживает оба режима, а между ними выбирает лёгкий блок самомаршрутизации. Он оценивает ценность размышления, то есть пользу, которую медленный режим, как ожидается, добавит по сравнению с быстрым. Оценка строится на том, что неявное обдумывание уже выдало. Медленный режим включается только там, где эта ценность превышает цену λ, задаваемую отдельно для каждого запроса.
Для задач, где нет метки на каждое отдельное решение (например, эпизодические агентные задачи), авторы вводят Calibrated Decision Policy Optimisation (CDPO). Это рецепт обучения с подкреплением, который тренирует блок маршрутизации по возвратам за весь эпизод.
HDM оценивали на шести наборах: MMLU-Pro, AGIEval, GPQA-Diamond, JevBench, BANKING77 и MiniWoB. Из результатов в аннотации приведены два. На JevBench модель HDM-4B набирает 0,857 против 0,851 у Jev (+0,7%), при этом медианное время составляет 0,179 с против 0,652 (-72,5%). На агентном наборе MiniWoB модель HDM-27B сокращает расход токенов на 80,1%.
Ключевые факты
- Подход «zero-or-T»: модель либо отвечает за один прямой проход, не генерируя токенов, либо рассуждает полностью ценой T токенов.
- В HDM одна замороженная базовая модель обслуживает оба режима, а лёгкий блок самомаршрутизации выбирает режим. Медленный режим включается, только если оценённая ценность размышления выше цены λ, заданной для запроса.
- Для агентных задач без меток на каждое решение предложен метод обучения с подкреплением CDPO: блок учится по возвратам за весь эпизод.
- На JevBench HDM-4B набрал 0,857 против 0,851 у Jev (+0,7%) при медианном времени 0,179 с против 0,652 (-72,5%).
- На MiniWoB модель HDM-27B сократила расход токенов на 80,1%.
Почему это важно
Обычно адаптивное рассуждение отвечает на вопрос «сколько думать» и всё равно пишет ответ токен за токеном. Авторы ставят другой вопрос: нужно ли генерировать токены вообще. Если простые запросы удаётся закрывать одним прямым проходом, а дорогое рассуждение запускать только там, где оно оправдано, это напрямую влияет на задержку и расход токенов. По заявленным результатам, на JevBench медианное время падает на 72,5% без потери в оценке, а на MiniWoB расход токенов снижается на 80,1%.
Кому это важно
Исследователям адаптивного рассуждения и эффективного вывода, а также командам, которые строят агентов и платят за токены и задержку. Интересен и сам механизм: цена λ задаётся отдельно для каждого запроса, то есть баланс между качеством и стоимостью можно настраивать.
Как это применить
Готового инструмента в источнике нет: есть только аннотация статьи. Идею можно взять как схему: быстрый режим на неявном обдумывании, медленный режим с полным рассуждением и небольшой блок, который сравнивает ожидаемую пользу с ценой. Для агентных задач авторы предлагают обучать этот блок методом CDPO по возвратам за эпизод.
Можно ли доверять
Это только аннотация статьи, источник не называет авторов и организации, а результаты приведены выборочно. Для JevBench в тексте не сказано, что такое Jev и по какой метрике сравниваются 0,857 и 0,851. Для MiniWoB не указано, с чем именно сравнивается снижение токенов на 80,1%. Результатов по MMLU-Pro, AGIEval, GPQA-Diamond и BANKING77 нет. Прирост +0,7% на JevBench очень небольшой, а основная выгода заявлена в скорости.
Риски и подводные камни
Неизвестны значение T, размер и устройство замороженной базовой модели, а также типичные значения λ, поэтому оценить практическую стоимость трудно. В аннотации нет упоминаний о коде, выпуске моделей, стоимости обучения и ограничениях подхода. Качество решения зависит от того, насколько точно блок оценивает ценность размышления по неявному обдумыванию, и из аннотации этого не проверить.