Фреймворк HEELO собирает агента из примитивов: Terminal-Bench 4.0, 55,5% вместо 37,3%
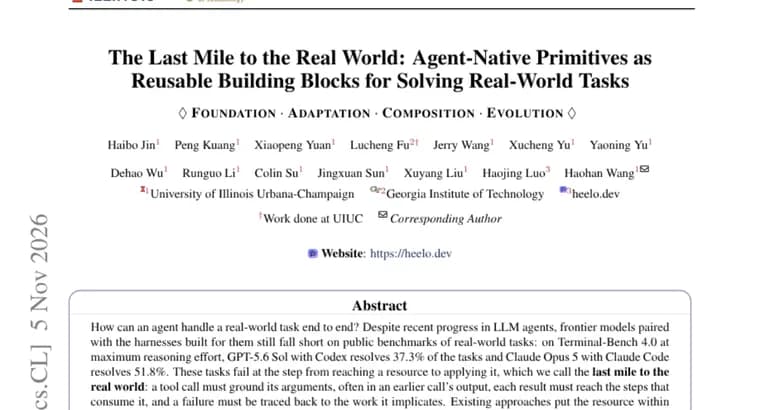
В препринте на Hugging Face Papers авторы исходят из того, что передовые модели даже со своими каркасами (harness, обвязка, в которой агент работает) всё ещё не справляются с реальными задачами. На Terminal-Bench 4.0 связка GPT-5.6 Sol с Codex решает 37,3% задач, а Claude Opus 5 с Claude Code, 51,8%. Задачи, по мнению авторов, проваливаются на шаге от «добраться до ресурса» до «применить его»; этот шаг они называют «последней милей до реального мира». Существующие подходы делают ресурс доступным, но умение его применять оставляют вызывающей стороне, поэтому каждый каркас заново строит эту компетенцию.
Решение, агентные примитивы (agent-native primitives): переиспользуемые блоки, которые снабжают ресурс «резидентной» языковой моделью. Она применяет ресурс в контексте задачи и обменивается сообщениями с другими примитивами. Поверх них построен HEELO (Harness Engineering around Evolving Agent-Native Primitives for the Last Mile to Real-WOrld Tasks), фреймворк, который собирает каркас под каждую задачу из библиотеки примитивов. HEELO компонует нужные примитивы в граф под задачу, проверяет результат по свидетельствам из среды, переделывает примитивы, замешанные в сбое, и принимает новые или улучшенные примитивы в библиотеку только после валидации.
Авторы реализовали HEELO в восьми семействах примитивов, каждое под свой тип задач, и проверили их более чем на двадцати бенчмарках. Из семейств в аннотации названы четыре. Dev-Primitives подняли долю решённых задач Terminal-Bench 4.0 с 37,3% под Codex до 55,5% на той же базовой модели. Harness Primitives, собираемые под каждую задачу, повысили Pass@1 на Terminal-Bench 2.0 с 60,0% у исходного каркаса до 72,2%. Tool Primitives подняли долю успешных прогонов на ToolBench с 55,8% до 75,1%, а Navigation Primitives, точность на GAIA-Text-103 с 45,6% до 58,3%.
Отдельная проверка, 46 реальных задач на платформе авторов heelo.dev. Claude Opus 5.5 с Claude Code и GPT-6.1 Sol с Codex в одиночку выполняют по 9 задач, а при подключении к HEELO через MCP-сервер, 39 и 35 (в порядке перечисления моделей). При этом, как сообщают авторы, на выполненную задачу уходит в 1,9 и 2,3 раза меньше времени и в 1,55 раза меньше денег. Все цифры приведены самими авторами.
Ключевые факты
- Dev-Primitives подняли долю решённых задач Terminal-Bench 4.0 с 37,3% (Codex) до 55,5% на той же базовой модели; у Claude Opus 5 с Claude Code базовый результат, 51,8%.
- Harness Primitives, собранные под задачу, повысили Pass@1 на Terminal-Bench 2.0 с 60,0% до 72,2%; Tool Primitives подняли ToolBench с 55,8% до 75,1%; Navigation Primitives, GAIA-Text-103 с 45,6% до 58,3%.
- На 46 реальных задачах платформы heelo.dev Claude Opus 5.5 с Claude Code и GPT-6.1 Sol с Codex в одиночку решают по 9, а через MCP-сервер HEELO, 39 и 35.
- Идея: примитив, это ресурс плюс встроенная языковая модель, умеющая его применять; HEELO собирает из примитивов граф под задачу, проверяет по данным среды, переделывает сбойные примитивы и принимает новые после валидации.
- Фреймворк реализован в восьми семействах примитивов и проверен более чем на двадцати бенчмарках; цифры приведены самими авторами.
Почему это важно
Работа бьёт в практическую проблему: даже сильные модели с фирменными каркасами решают лишь 37,3% и 51,8% задач Terminal-Bench 4.0. Авторы предлагают не улучшать модель, а выносить умение применять ресурс в переиспользуемый блок, чтобы каждый каркас не изобретал его заново. Если заявленные приросты подтвердятся, это аргумент в пользу сборки каркаса из проверяемых компонентов под конкретную задачу.
Кому это важно
Разработчикам агентных систем и каркасов вокруг моделей, командам, которые подключают к агентам инструменты и внешние сервисы, а также исследователям бенчмарков для агентов (Terminal-Bench, ToolBench, GAIA). Интересна и тем, кто использует Claude Code или Codex и думает, как расширить их возможности внешним слоем.
Как это применить
В аннотации сказано, что на платформе heelo.dev модели подключаются к HEELO через MCP-сервер, то есть идея проверяется с готовыми агентами Claude Code и Codex. Практически стоит взять из работы принцип: у каждого ресурса, свой «знающий» помощник, а результат сверяется с данными среды, и сбойные части переделываются. Сведений о коде, наборах данных или лицензии, кроме самой платформы и MCP-сервера, в тексте нет.
Можно ли доверять
Это препринт; все результаты приведены самими авторами, независимого подтверждения в тексте нет. Часть сравнений неполна: Dev-Primitives сопоставлены с Codex «на той же базовой модели», но какая это модель, не названо. Для сокращения времени в 1,9 и 2,3 раза и стоимости в 1,55 раза не указано, относительно какого базового варианта они посчитаны и какой коэффициент у какой модели. Проверка на 46 задачах идёт на платформе самих авторов.
Риски и подводные камни
Высокие цифры на собственной платформе из 46 задач могут не переноситься на другие среды. Подход добавляет в каркас дополнительные языковые модели внутри примитивов, а значит, сложность и потенциальные точки отказа; аннотация не обсуждает ограничения и разбор сбоев. Список восьми семейств примитивов в ней не приведён, поэтому оценить охват можно только по полному тексту работы.