Фреймворк ACCRUE сокращает обучение роботов на 31-68,5%
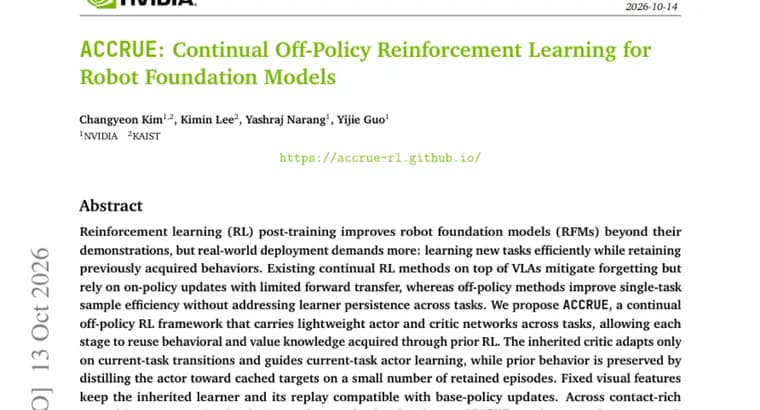
В препринте на Hugging Face Papers описан ACCRUE, фреймворк непрерывного внеполитического (off-policy) обучения с подкреплением для фундаментальных моделей роботов. Исходная проблема, как её формулируют авторы: дообучение с подкреплением (RL post-training) улучшает такие модели сверх демонстраций, но на практике роботу нужно не только эффективно осваивать новые задачи, но и сохранять уже выученное поведение.
Существующие методы непрерывного RL поверх VLA-моделей (vision-language-action, «зрение, язык, действие») снижают забывание, но опираются на обновления on-policy и дают ограниченный перенос знаний на следующие задачи. Внеполитические методы, напротив, повышают эффективность по данным на одной задаче, но не решают, как сохранять обучаемый модуль между задачами.
ACCRUE переносит между задачами облегчённые сети актора и критика, так что каждый следующий этап использует поведенческие знания и оценки ценности, полученные в предыдущем RL. Унаследованный критик дообучается только на переходах текущей задачи и направляет обучение актора на ней. Прежнее поведение сохраняется за счёт дистилляции актора к заранее сохранённым целевым значениям на небольшом числе удержанных эпизодов. Фиксированные визуальные признаки делают унаследованный обучаемый модуль и его буфер воспроизведения (replay) совместимыми с обновлениями базовой политики.
По заявлению авторов, на последовательностях контактных сборочных задач в симуляции и на реальном роботе ACCRUE ускоряет освоение последующих задач при почти нулевом забывании и значительно, на 31,0-68,5%, сокращает время обучения на реальном роботе.
Ключевые факты
- ACCRUE, фреймворк непрерывного внеполитического RL для фундаментальных моделей роботов: между задачами переносятся облегчённые сети актора и критика.
- Унаследованный критик адаптируется только на переходах текущей задачи; прежнее поведение сохраняется дистилляцией актора на небольшом числе удержанных эпизодов.
- Фиксированные визуальные признаки сохраняют совместимость унаследованного модуля и его буфера воспроизведения с обновлениями базовой политики.
- Проверка велась на контактных сборочных последовательностях в симуляции и на реальном роботе; авторы заявляют почти нулевое забывание.
- Заявленное сокращение времени обучения на реальном роботе, от 31,0% до 68,5%.
Почему это важно
Роботу в реальной эксплуатации приходится осваивать задачи одну за другой, и обучение на физическом оборудовании дорого по времени. Авторы указывают на пробел между двумя группами методов: непрерывный RL поверх VLA-моделей борется с забыванием, но опирается на on-policy обновления и слабо переносит знания вперёд, а внеполитические методы экономят данные лишь на одной задаче. ACCRUE пытается объединить оба свойства: сохранять старое и быстрее учить новое.
Кому это важно
Прежде всего исследователям робототехники и обучения с подкреплением, работающим с фундаментальными моделями роботов и VLA. Косвенно, командам, которые занимаются контактными сборочными операциями и у которых время работы реального робота на обучение является узким местом.
Как это применить
Из аннотации видно лишь общее устройство метода: переносить между задачами облегчённые актор и критик, дообучать критика на данных текущей задачи, сохранять старое поведение дистилляцией на небольшом числе удержанных эпизодов и держать визуальные признаки фиксированными. Для практического воспроизведения нужен полный текст статьи; конкретные модели, платформы и настройки в аннотации не названы, а о выпуске кода или данных в ней не сказано.
Можно ли доверять
Все утверждения, самооценка авторов из аннотации препринта. В аннотации не названы авторы и организации, не указана базовая линия, относительно которой посчитано сокращение времени на 31,0-68,5%, и не сказано, как этот диапазон распределяется по задачам и аппаратным платформам. Численное значение для «почти нулевого забывания» не приведено. Независимой проверки результатов в источнике нет.
Риски и подводные камни
Диапазон 31,0-68,5%, относительное сокращение времени обучения на реальном роботе; без указания базовой линии и числа задач оценить его практический смысл трудно. Не сообщается, сколько задач входит в последовательности и сколько эпизодов удерживается, поэтому масштабируемость метода по аннотации оценить нельзя. Цифры по времени обучения даны только для реального робота, для симуляции аналогичных значений нет. Опора на фиксированные визуальные признаки, осознанное проектное решение метода, и его влияние на более разнообразные сценарии в аннотации не разбирается.