FLAT объединил генерацию и поиск по тексту и изображениям в одной модели
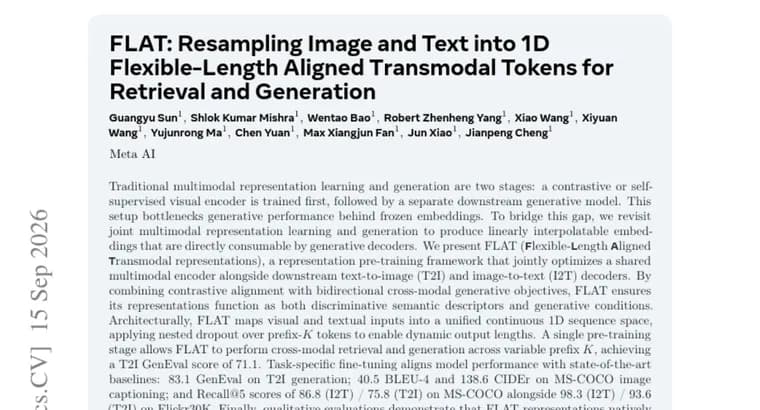
Авторы описывают проблему традиционного подхода к мультимодальным представлениям: сначала отдельно обучают визуальный кодировщик (контрастным или самоконтролируемым методом), а затем поверх него, отдельную генеративную модель. Из-за этого генеративная часть работает с уже замороженными эмбеддингами и упирается в их качество как в потолок.
Чтобы убрать это ограничение, авторы предлагают FLAT (Flexible-Length Aligned Transmodal representations), фреймворк предобучения, в котором общий мультимодальный кодировщик обучается совместно с декодерами для генерации изображения по тексту (T2I) и текста по изображению (I2T) в одном этапе. Обучение сочетает контрастное выравнивание представлений с двунаправленными генеративными задачами между модальностями, поэтому одни и те же представления одновременно служат и различающими семантическими описаниями (для поиска), и условиями для генерации.
Архитектурно FLAT переводит визуальные и текстовые входы в единое непрерывное одномерное пространство последовательностей. Поверх первых K токенов применяется вложенный дропаут (nested dropout), что позволяет модели работать с представлениями переменной длины и динамически задавать длину выхода.
По заявленным результатам, уже после единственного этапа предобучения (без дообучения под конкретную задачу) FLAT показывает GenEval 71.1 на генерации изображений по тексту при разной длине префикса K. После дообучения под конкретные задачи показатели выходят на уровень современных специализированных моделей: GenEval 83.1 на генерации изображения по тексту; на подписывании изображений на MS-COCO, BLEU-4 40.5 и CIDEr 138.6; по метрике Recall@5, 86.8 (текст→изображение по смыслу картинки, I2T) и 75.8 (изображение→текст, T2I) на MS-COCO, а также 98.3 (I2T) и 93.6 (T2I) на Flickr30K. Отдельно авторы приводят качественные примеры: представления FLAT допускают линейную интерполяцию между эмбеддингами, арифметику в латентном пространстве и поиск без дообучения по составным запросам (zero-shot composed retrieval).
В тексте не названы ни авторы, ни организация, ни дата и место публикации работы; не раскрыто, какие именно «современные специализированные модели» взяты как база для сравнения после дообучения, и не приведены сведения об обучающих данных, вычислительных затратах или размере модели.
Ключевые факты
- FLAT совмещает обучение общего мультимодального кодировщика с декодерами генерации изображения по тексту (T2I) и текста по изображению (I2T) в одном этапе предобучения
- Представления живут в едином непрерывном одномерном пространстве переменной длины: вложенный дропаут над первыми K токенами задаёт гибкую длину выхода
- После одного этапа предобучения, GenEval 71.1 на T2I; после дообучения, GenEval 83.1 на T2I, BLEU-4 40.5 и CIDEr 138.6 на подписывании изображений MS-COCO
- Recall@5 после дообучения: 86.8 (I2T) / 75.8 (T2I) на MS-COCO и 98.3 (I2T) / 93.6 (T2I) на Flickr30K
- Представления FLAT поддерживают линейную интерполяцию, арифметику в латентном пространстве и поиск по составным запросам без дополнительного обучения
Почему это важно
Стандартная схема мультимодальных моделей, сначала отдельно обучить визуальный кодировщик, потом поверх него отдельную генеративную модель, упирается в качество уже замороженных эмбеддингов: генеративная часть не может стать лучше базовых представлений, на которых она построена. FLAT предлагает альтернативу, обучать кодировщик и генеративные декодеры совместно, в один этап, так что одни и те же представления одновременно годятся и для различения (поиска), и для генерации в обе стороны, из текста в изображение и обратно.
Кому это важно
Работа адресована исследователям и инженерам, которые строят мультимодальные системы поиска и генерации, там, где сейчас приходится держать отдельные модели для эмбеддингов, для генерации изображений по тексту и для описания изображений текстом. Единое представление переменной длины, которое одновременно решает обе задачи, может упростить такие пайплайны.
Как это применить
В основе, единый кодировщик, переводящий текст и изображения в общее одномерное пространство переменной длины, поверх которого дообучаются декодеры под конкретную задачу (генерация изображения, подписывание изображения, поиск). В тексте не приведены сведения о выпуске кода, лицензии, размере модели или требуемых вычислительных ресурсах, поэтому судить о готовности решения к практическому внедрению по имеющимся данным нельзя.
Можно ли доверять
Это материал уровня научной публикации (страница на Hugging Face Papers), а не анонс продукта: ни авторы, ни организация, ни дата и площадка публикации в тексте не названы. Приведённые метрики, самостоятельные измерения авторов на стандартных бенчмарках (GenEval, MS-COCO, Flickr30K), но какие именно «современные специализированные модели» использованы для сравнения после дообучения, не раскрыто, что затрудняет независимую проверку заявленного превосходства.
Риски и подводные камни
Работа не называет авторов и организацию, не приводит данные об обучающей выборке, вычислительных затратах и размере модели, это ограничивает воспроизводимость и оценку практических затрат на такую систему. Идентичность базовых моделей для сравнения после дообучения также не указана, поэтому насколько прирост в бенчмарках отражает реальное преимущество архитектуры, а не выбор точки сравнения, по тексту не проверить.