FlashMask-3: ядро внимания с масками для GPU Hopper и распределённого обучения
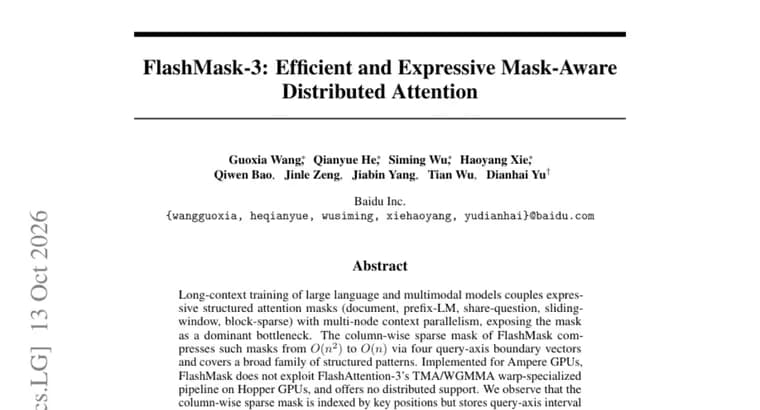
Авторы статьи (она размещена на Hugging Face Papers) исходят из того, что при обучении больших языковых и мультимодальных моделей на длинном контексте структурные маски внимания (документные, prefix-LM, share-question, скользящее окно, блочно-разреженные) в сочетании с многоузловым контекстным параллелизмом (context parallelism) превращают маску в одно из главных узких мест.
Предшественник, FlashMask, хранит маску в виде столбцового разреженного представления: вместо матрицы O(n^2) используются четыре вектора границ по оси запросов, то есть память сжимается до O(n). Этого хватает для широкого класса структурных масок, но FlashMask реализован для GPU Ampere: он не использует конвейер FlashAttention-3 с TMA/WGMMA и warp-специализацией на Hopper и не поддерживает распределённый режим.
FlashMask-3 добавляет две вещи. Первая, ядро для Hopper с тремя ролями warp-специализации поверх конвейера TMA/WGMMA из FlashAttention-3. Вторая, распределённое расширение с учётом масок: локализация маски без обмена данными, балансировщик нагрузки с учётом разреженности (HCC-IPO) и перекрытие вычислений с коммуникацией, в котором лишние передачи отсекаются по маске, а прямой all-gather идёт по иерархическому маршруту с учётом топологии. Ключевая идея локализации: маска индексируется позициями ключей, но хранит границы интервалов по оси запросов; при любом назначении нескольких фрагментов контекста на ранги локализация маски на ранге сводится к операции clip, shift, max над векторами границ. Авторы утверждают, что это доказуемо не требует коммуникации и совместимо с одно-GPU ядром.
Результаты. На одной H100 по 12 маскам при контексте 4K, 128K достигнутые TFLOPs выше, чем у FlashMask, FlexAttention и MagiAttention, на 45-141%, 34-71% и 2-44% соответственно. При степенях контекстного параллелизма 4-32 и 8K последовательности на устройство эффективность перекрытия вычислений и коммуникации составляет 31-75%, а пропускная способность выше, чем у Megatron-Core CP ring, Megatron-Core CP all-gather и MagiAttention, в 1,80-3,71, 1,71-2,92 и 1,09-1,46 раза. В сквозном обучении MoE-модели 118B-A14B на контексте 128K на 128 GPU H100 пропускная способность выше на 7,3-11,0% относительно базового варианта Dual Chunk all-gather, при этом прямой и обратный проход внимания быстрее на 24,5-44,9%.
Ключевые факты
- FlashMask-3, ядро внимания с масками для GPU Hopper на базе конвейера TMA/WGMMA из FlashAttention-3, с тремя ролями warp-специализации; прежний FlashMask был реализован только для Ampere и без распределённого режима.
- Распределённое расширение: локализация маски без коммуникации (clip, shift, max над векторами границ), балансировщик нагрузки HCC-IPO и перекрытие вычислений с коммуникацией с отсечением лишних передач по маске.
- На одной H100 (12 масок, контекст 4K, 128K) выигрыш в достигнутых TFLOPs: 45-141% над FlashMask, 34-71% над FlexAttention, 2-44% над MagiAttention.
- При контекстном параллелизме 4-32 пропускная способность выше в 1,80-3,71 раза, чем у Megatron-Core CP ring, в 1,71-2,92 раза, чем у CP all-gather, и в 1,09-1,46 раза, чем у MagiAttention.
- Обучение MoE-модели 118B-A14B на 128K и 128 H100: пропускная способность выше на 7,3-11,0% относительно Dual Chunk all-gather, внимание (прямой и обратный проход) быстрее на 24,5-44,9%.
Почему это важно
На длинном контексте внимание становится дорогой частью обучения, а структурные маски (документные границы, скользящее окно, prefix-LM и т. п.) при многоузловом параллелизме усложняют и вычисление, и обмен данными. Работа переносит подход FlashMask на архитектуру Hopper и добавляет к нему распределённый режим с учётом масок. В сквозном обучении эффект скромнее: 7,3-11,0% прироста пропускной способности на большой MoE-модели, меньше, чем выигрыши на уровне отдельного ядра.
Кому это важно
Командам, которые обучают большие языковые и мультимодальные модели на длинном контексте на кластерах H100 и используют структурные маски. Также разработчикам библиотек внимания и контекстного параллелизма, сравнивающим подходы FlexAttention, MagiAttention и Megatron-Core CP.
Как это применить
Из текста аннотации не следует готового способа использования: сведений о выпуске кода или открытой доступности нет. Практически работа полезна как ориентир по архитектуре решения: три роли warp-специализации на Hopper, локализация маски через clip, shift, max и отсечение коммуникации по маске. Применимость ограничена GPU Hopper; результаты приведены только для H100.
Можно ли доверять
Все цифры взяты из аннотации статьи и представляют собой заявления самих авторов. Сведений о рецензировании нет. Приведены только относительные улучшения, абсолютные значения TFLOPs и пропускной способности не названы, не сказано, на каких из 12 масок выигрыш наименьший, а на каких наибольший. Широкие диапазоны (например, 2-44% над MagiAttention) означают, что выигрыш сильно зависит от маски и длины контекста.
Риски и подводные камни
Сравнения идут с разными базовыми вариантами в разных сценариях: над MagiAttention выигрыш наименьший (2-44% на одной GPU, в 1,09-1,46 раза в распределённом режиме), а заметные цифры получены против более слабых точек сравнения. В сквозном обучении база, Dual Chunk all-gather, а не те же Megatron-Core CP и MagiAttention, поэтому прямо сопоставлять цифры из разных тестов нельзя. Эффективность перекрытия вычислений и коммуникации (31-75%) показывает, что значительная часть коммуникации остаётся не скрытой. Стоимость, энергопотребление и время обучения для прогона на 118B-A14B не приведены.