FinDendro: GPT-5 знает больше, чем о себе говорит, бэктесты под вопросом
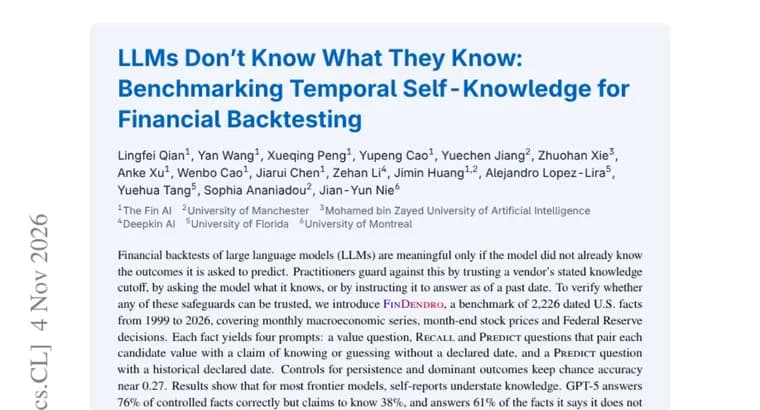
Бэктест финансовой модели на основе большой языковой модели (LLM) имеет смысл, только если модель заранее не знала исходов, которые её просят предсказать. На практике от такой утечки защищаются тремя способами: доверяют заявленной разработчиком дате отсечки знаний, спрашивают у самой модели, что она знает, или просят отвечать «по состоянию на» прошлую дату. Авторы статьи проверили, можно ли доверять хотя бы одной из этих защит.
Для этого они создали бенчмарк FinDendro: 2226 датированных фактов о США за период с 1999 по 2026 год. Факты охватывают месячные макроэкономические ряды, цены акций на конец месяца и решения Федеральной резервной системы. Из каждого факта получается четыре запроса: вопрос о значении; вопросы Recall и Predict, где каждое возможное значение сочетается с утверждением «знаю» или «угадываю» без заданной даты; и вопрос Predict с историческим заданным сроком. Контроли на инерцию рядов и доминирующие исходы удерживают случайную точность около 0,27.
Результаты: у большинства передовых моделей самоотчёты занижают знания. GPT-5 правильно отвечает на 76% контролируемых фактов, но заявляет, что знает лишь 38%, а из фактов, про которые говорит «не знаю», отвечает верно на 61%. Заявления о знании могут сохраняться за пределами измеренной границы знаний, до семи кварталов. Заданная дата снимает большую часть заявлений о прежнем знании, но точность при этом не меняется.
Вывод авторов: бэктесты внутри обучающего окна модели нельзя признать свободными от утечки на основании самоотчёта, инструкции или заявленной даты отсечки. Они предлагают измерять временные границы знаний по поведению модели, а FinDendro даёт бенчмарк и процедуру для выбора периодов бэктеста по продемонстрированным фактическим знаниям.
Ключевые факты
- FinDendro, бенчмарк из 2226 датированных фактов о США за 1999-2026 годы: макроэкономические ряды, цены акций на конец месяца, решения ФРС; из каждого факта получается четыре запроса.
- У большинства передовых моделей самоотчёты занижают знания: GPT-5 верно отвечает на 76% контролируемых фактов, но заявляет, что знает 38%, и верно отвечает на 61% фактов, про которые говорит «не знаю».
- Заявления о знании могут сохраняться за измеренной границей знаний, до семи кварталов.
- Заданная дата убирает большую часть заявлений о прежнем знании, а точность не меняется.
- Бэктесты внутри обучающего окна модели нельзя подтвердить как чистые от утечки ни самоотчётом, ни инструкцией, ни заявленной датой отсечки.
Почему это важно
Если нейросеть уже «видела» исходы, которые её просят предсказать, бэктест показывает память, а не способность прогнозировать. Авторы показывают, что привычные способы защиты, заявленная дата отсечки, вопрос «что ты знаешь» и просьба отвечать на определённую дату, ненадёжны. Модель может знать намного больше, чем о себе заявляет: GPT-5 отвечает верно на 76% контролируемых фактов, хотя заявляет знание лишь о 38%.
Кому это важно
Тем, кто тестирует финансовые стратегии и прогнозы на больших языковых моделях: количественным аналитикам и исследователям, которые строят бэктесты с участием LLM. Также исследователям, которые оценивают, что нейросети знают о конкретных периодах времени.
Как это применить
Авторы предлагают не полагаться на самоотчёт и заявленную дату отсечки, а измерять временные границы знаний по поведению модели. FinDendro задуман как бенчмарк и процедура для выбора периодов бэктеста по продемонстрированным фактическим знаниям. Ссылки на код или данные в аннотации нет.
Можно ли доверять
Это научная статья, и все выводы принадлежат её авторам; в аннотации не названы ни авторы, ни организации. По имени там упомянута только GPT-5, цифры по остальным «передовым моделям» не приведены, а какие модели составляют исключение из формулировки «большинство», не сказано. Цифры 76% и 38% относятся к «контролируемым фактам»; относится ли к этому же подмножеству 61%, аннотация не уточняет. Реальных результатов бэктестов в аннотации нет.
Риски и подводные камни
Бенчмарк охватывает только факты о США (макроряды, цены акций на конец месяца, решения ФРС), поэтому перенос выводов на другие рынки и типы данных в аннотации не обосновывается. Главное следствие для практики: бэктест внутри обучающего окна модели нельзя считать чистым от утечки только потому, что модель говорит «не знаю», ей задана дата или у неё указана дата отсечки. Заданная дата снимает заявления о знании, но не меняет точность.