ESRL поднял точность Qwen3-30B-A3B на 3,2 п.п. по Pass@1 и на 4,5, по Pass@8
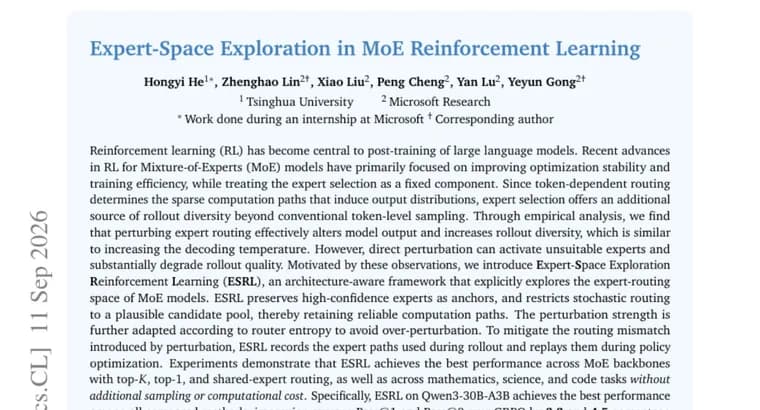
Обучение с подкреплением (RL) стало основным способом дообучения больших языковых моделей после предобучения. В последних работах по RL для моделей на архитектуре MoE (Mixture-of-Experts, «смесь экспертов») основное внимание уделяли стабильности оптимизации и эффективности обучения, а выбор экспертов, маршрутизацию, оставляли неизменным, фиксированным компонентом. Между тем именно маршрутизация определяет, какие разреженные вычислительные пути использует модель, а значит, и то, каким получается распределение её ответов; иными словами, выбор экспертов, это ещё один источник разнообразия для траекторий, которые модель генерирует в процессе обучения (rollout).
Эмпирически авторы показали: если варьировать (возмущать) маршрутизацию экспертов, это заметно меняет выход модели и увеличивает разнообразие таких траекторий, эффект похож на повышение температуры генерации. Но прямое, ничем не ограниченное возмущение маршрутизации может активировать неподходящие для задачи эксперты и сильно ухудшить качество получаемых траекторий.
Опираясь на это наблюдение, авторы предлагают ESRL (Expert-Space Exploration Reinforcement Learning, «обучение с подкреплением через исследование пространства экспертов»), учитывающий архитектуру MoE фреймворк, который прицельно исследует пространство маршрутизации экспертов. Метод сохраняет в роли «якорей» экспертов, которых модель выбирает с наибольшей уверенностью, и ограничивает случайный выбор правдоподобным пулом кандидатов, так сохраняются надёжные вычислительные пути. Сила возмущения при этом адаптируется по энтропии роутера, чтобы избежать избыточного возмущения. Отдельно ESRL устраняет рассогласование между маршрутами: фреймворк запоминает, какие именно пути экспертов были задействованы во время генерации (rollout), и воспроизводит их на этапе оптимизации политики.
В экспериментах ESRL показал лучший результат среди сравненных подходов на MoE-архитектурах с разными схемами маршрутизации, top-K, top-1 и shared-expert (с общим экспертом), а также на задачах по математике, естественным наукам и коду, причём без дополнительного сэмплирования и без роста вычислительных затрат. Отдельно для модели Qwen3-30B-A3B ESRL обошёл базовый алгоритм GRPO: средний Pass@1 вырос на 3,2 процентного пункта, средний Pass@8, на 4,5 процентного пункта. Абсолютные значения Pass@1 и Pass@8 ни для ESRL, ни для GRPO в тексте не приводятся, указан только размер прироста.
Дополнительный анализ использования экспертов и динамики обучения, по словам авторов, даёт представление о том, почему использование специфичной для MoE структуры маршрутизации приносит пользу RL-обучению; подробности этого анализа в самой аннотации не раскрываются.
Ключевые факты
- ESRL (Expert-Space Exploration Reinforcement Learning), фреймворк RL-обучения MoE-моделей, который вместо фиксированной маршрутизации исследует само пространство выбора экспертов как источник разнообразия обучающих траекторий, по аналогии с повышением температуры генерации.
- Прямое, ничем не ограниченное изменение маршрутизации ухудшает качество: может активировать неподходящие эксперты. ESRL сохраняет уверенно выбираемых экспертов в роли «якорей», ограничивает случайный выбор пулом правдоподобных кандидатов и адаптирует силу возмущения по энтропии роутера.
- Чтобы устранить рассогласование между маршрутами на этапе генерации и на этапе оптимизации, ESRL запоминает, какие пути экспертов были использованы во время генерации (rollout), и воспроизводит их при оптимизации политики.
- Метод показал лучший результат среди сравненных подходов на MoE-архитектурах с разными схемами маршрутизации (top-K, top-1, shared-expert) и на задачах по математике, науке и коду, без дополнительного сэмплирования и без роста вычислительных затрат.
- На модели Qwen3-30B-A3B ESRL обошёл базовый алгоритм GRPO: средний Pass@1 вырос на 3,2 процентного пункта, средний Pass@8, на 4,5 процентного пункта; абсолютные значения Pass@1 и Pass@8 в тексте не приводятся.
Почему это важно
До сих пор в RL-обучении MoE-моделей маршрутизацию экспертов держали неизменной и работали только над стабильностью и эффективностью самой оптимизации. ESRL показывает, что маршрутизация, это отдельный, ранее не использованный рычаг: контролируемо варьируя выбор экспертов, можно увеличить разнообразие обучающих траекторий так же, как это делает повышение температуры генерации, но без порчи качества, которую даёт неограниченное возмущение. Показательно и то, что прирост получен без дополнительного сэмплирования и без роста вычислительных затрат, а сам метод лучший среди сравненных сразу на нескольких схемах маршрутизации MoE (top-K, top-1, shared-expert) и на трёх разных типах задач, математике, науке и коде, то есть не выглядит узкой подгонкой под одну архитектуру или одну область.
Кому это важно
В первую очередь, исследователям и инженерам, которые занимаются RL-обучением MoE-моделей: ESRL даёт конкретную архитектурную схему, эксперты-«якоря», ограниченный пул кандидатов, адаптация силы возмущения по энтропии роутера, воспроизведение маршрутов на этапе оптимизации, которую можно проверять и переносить на другие MoE-архитектуры. Важно это и командам, которые работают с открытыми MoE-моделями семейства Qwen3 (в статье использована Qwen3-30B-A3B) и с задачами по математике, коду и науке, где качество RL-обучения особенно заметно на бенчмарках. Метод заявлен как совместимый сразу с несколькими схемами маршрутизации, top-K, top-1 и shared-expert, поэтому потенциально применим шире, чем к одной конкретной архитектуре.
Как это применить
Публикация на Hugging Face Papers описывает метод и результаты эксперимента, а не готовый к использованию релиз: в тексте аннотации не сказано, выложены ли код или веса, использованные в экспериментах, и на каких условиях лицензии, судить об этом по самой аннотации нельзя. Переносимая часть, сама идея: явно выделить маршрутизацию экспертов как параметр, которым можно управлять при RL-обучении, сохранять надёжных экспертов в роли «якорей», ограничивать случайный выбор правдоподобным пулом кандидатов, адаптировать силу возмущения по энтропии роутера и воспроизводить фактически использованные при генерации маршруты на этапе оптимизации политики. Тем, кому нужны сами код или веса, а не только идея метода, стоит проверять страницу препринта отдельно, этот пересказ её не покрывает.
Можно ли доверять
Все цифры, из собственной аннотации авторов, независимой проверки или воспроизведения в тексте не упомянуто. Аннотация не называет ни отдельных авторов, ни организацию, стоящую за работой, поэтому связать результат с конкретной командой или лабораторией по этому тексту нельзя. Прирост дан только в процентных пунктах относительно алгоритма GRPO, абсолютные значения Pass@1 и Pass@8 ни для ESRL, ни для GRPO в тексте не приводятся, поэтому оценить, насколько сильна сама база для сравнения (близка ли GRPO к потолку качества или далека от него), по аннотации невозможно. Не названы конкретные бенчмарки или наборы данных по математике, науке и коду, на которых считались Pass@1 и Pass@8, известны только сами категории задач; не приведены и объём вычислений или другие детали обучения, по которым можно было бы оценить затратность и воспроизводимость эксперимента.
Риски и подводные камни
Главный риск для читателя, самоотчёт без независимой проверки: ни конкретные тестовые наборы, ни точные абсолютные показатели Pass@1 и Pass@8 в аннотации не названы, поэтому повторить измерение по одному этому тексту нельзя. Аннотация называет ESRL лучшим среди сравненных методов, но по имени и с цифрами указан только один, базовый алгоритм GRPO; насколько ESRL выигрывает или проигрывает другим методам RL-обучения MoE-моделей, из аннотации не следует. Сам метод вводит несколько дополнительных механизмов, каких экспертов считать «якорями», какого размера брать пул кандидатов, как именно адаптировать силу возмущения по энтропии роутера, но точные настройки (гиперпараметры), использованные в экспериментах, в аннотации не раскрываются, что осложняет воспроизведение результата по одному этому тексту.