EgoX: предобучение на данных людей и роботов подняло результат с 0,63 до 0,80
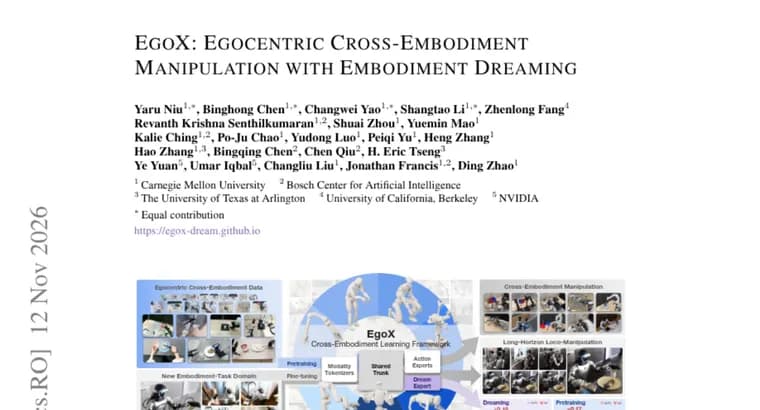
Авторы препринта исходят из того, что универсальные модели управления манипуляциями (хватание, перекладывание и подобные действия руками или манипуляторами) могут выиграть от разного опыта: людей, реальных роботов и симулированных агентов. Мешает то, что у них отличаются строение тела (морфология), датчики и интерфейсы управления, поэтому учиться на их совместных демонстрациях непросто.
Для решения этой проблемы предложен EgoX, фреймворк «эгоцентричного» (от первого лица) обучения сразу для разных воплощений (embodiment, то есть разных типов «тел»). Он упорядочивает разнородные демонстрации через семантически соответствующие друг другу модальности наблюдений и действий. На такой смеси данных предобучается модель MXT+ (Modularized Cross-Embodiment Transformer with Embodiment Dreaming), а затем её дообучают на демонстрациях для целевого воплощения.
Устройство MXT+: внутри каждого воплощения для каждой модальности наблюдений есть отдельный токенизатор, а для каждой модальности действий, отдельный «эксперт». Основная часть трансформера (ствол, trunk) общая для всех воплощений. Дополнительно используется цель «воплощённых грёз» (embodiment dreaming), которая применяется только при обучении: модель предсказывает латентные представления будущих визуальных и проприоцептивных состояний (то есть данных о положении собственного тела). Это побуждает общий ствол моделировать динамику каждого воплощения.
Оценка проведена на 13 парах «задача, воплощение»: пять задач и шесть воплощений, из них пять физических роботов и один симулированный гуманоид. Предобучение на смеси данных подняло средний нормализованный прогресс выполнения задач у MXT+ с 0,63 (обучение с нуля) до 0,80. Особенно заметен выигрыш в условиях вне обучающего распределения (out-of-distribution): там средний прогресс вырос с 0,53 до 0,77. Абляции, по заявлению авторов, показывают пользу более широкой смеси данных для предобучения, модульных интерфейсов и «воплощённых грёз»; последние делают латентную геометрию у разных воплощений более похожей. Страница проекта: egox-dream.github.io.
Ключевые факты
- EgoX объединяет демонстрации людей, реальных роботов и симулированных агентов для предобучения одной модели MXT+, которую затем дообучают на данных целевого воплощения.
- В MXT+ у каждой модальности наблюдений свой токенизатор, у каждой модальности действий, свой эксперт, а трансформерный ствол общий для всех воплощений.
- Цель embodiment dreaming работает только при обучении: она предсказывает латентные представления будущих визуальных и проприоцептивных состояний.
- Средний нормализованный прогресс по задачам по 13 парам «задача, воплощение» вырос с 0,63 (с нуля) до 0,80 после кросс-воплощённого предобучения.
- В условиях вне обучающего распределения прогресс вырос с 0,53 до 0,77.
Почему это важно
Данные для обучения роботов дороги и разрознены: у людей, реальных роботов и симуляторов разные тела, датчики и способы управления. EgoX предлагает способ свести такие демонстрации в одну модель. По описанию авторов, это даёт заметный прирост: с 0,63 до 0,80 по среднему нормализованному прогрессу на 13 парах «задача, воплощение», а в условиях вне обучающего распределения, с 0,53 до 0,77. Это абсолютные значения шкалы, а не проценты.
Кому это важно
Исследователям робототехники и обучения с подражанием, которые работают с несколькими типами роботов и хотят переиспользовать чужие демонстрации, включая видео людей и симуляцию. Результат также интересен тем, кто строит универсальные модели управления манипуляциями.
Как это применить
Это академический препринт, а не готовый продукт. Идеи, которые можно взять на вооружение: отдельные токенизаторы и эксперты для каждой модальности при общем трансформерном стволе, и вспомогательная цель предсказания будущих латентных состояний, которая применяется только при обучении. Подробности, на странице проекта egox-dream.github.io; в аннотации называется только эта страница, а о выпуске кода и моделей там не сказано.
Можно ли доверять
Все цифры взяты из аннотации самой работы и не перепроверены независимо. Результаты приведены только для MXT+, сравнения с другими опубликованными методами в аннотации нет. Не указаны объёмы данных каждого типа, пять конкретных задач и модели роботов, не объяснено, как считается нормализованный прогресс, и не даны числа по отдельным абляциям. В источнике не названы авторы и организации.
Риски и подводные камни
Выборка скромная: пять задач и шесть воплощений, среди которых пять физических роботов и один симулированный гуманоид, поэтому перенос выводов на другие задачи и роботов не гарантирован. Без деталей о метрике и составе данных трудно оценить, насколько прирост 0,63 → 0,80 зависит от конкретной смеси демонстраций. Утверждение о более похожей латентной геометрии у разных воплощений при использовании «воплощённых грёз» в аннотации не подкреплено числами.