Для Qwen3-0.6B предложили считать на 4 битах и повышать до 8 при неуверенности
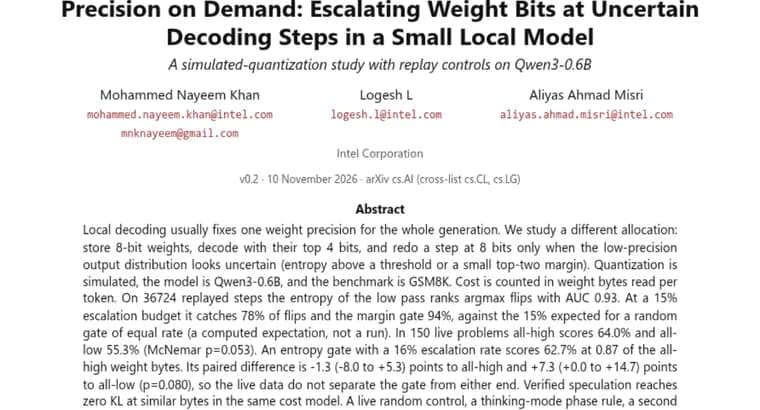
Препринт (Hugging Face Papers, 2611.14418) касается локального декодирования небольших моделей. Обычно для всей генерации задают одну точность весов. Авторы изучают другое распределение: веса хранятся в 8 битах, декодирование идёт по их старшим 4 битам, а конкретный шаг пересчитывается в 8 битах только тогда, когда распределение на выходе низкоточного прохода выглядит неуверенным. Неуверенность определяют двумя способами: энтропия выше порога либо малый разрыв между двумя самыми вероятными вариантами (top-two margin).
Условия эксперимента: квантизация симулируется, модель, Qwen3-0.6B, бенчмарк, GSM8K. Стоимость считают в байтах весов, прочитанных на токен. Реальных замеров скорости, задержки или энергопотребления нет: используется только эта модель стоимости.
Офлайн-анализ на 36 724 воспроизведённых шагах: энтропия низкоточного прохода ранжирует случаи, когда argmax (самый вероятный токен) меняется при переходе к 8 битам, с AUC 0,93. При бюджете повышения точности в 15% шагов энтропийный критерий ловит 78% таких смен, критерий по разрыву между двумя лучшими вариантами, 94%. Для случайного критерия с той же долей ожидается 15%, это расчётная величина, а не запуск.
Живой тест на 150 задачах: режим «всё в высокой точности» даёт 64,0%, «всё в низкой», 55,3% (McNemar p=0,053). Энтропийный критерий с долей повышений 16% даёт 62,7% при 0,87 от байтов весов режима «всё в высокой точности». Парная разница: −1,3 п.п. (интервал от −8,0 до +5,3) к высокой точности и +7,3 п.п. (от +0,0 до +14,7; p=0,080) к низкой. Вывод авторов: живые данные не отделяют критерий ни от одного из крайних режимов.
Для сравнения авторы отмечают, что верифицированное спекулятивное декодирование достигает нулевой KL-дивергенции при сопоставимом числе байтов в той же модели стоимости. Не запускались: живой случайный контроль, правило по фазе режима рассуждения (thinking mode), вторая модель и живая KL-дивергенция.
Ключевые факты
- Идея: хранить веса в 8 битах, декодировать по старшим 4 битам и повторять шаг в 8 битах только при неуверенном выходе (энтропия выше порога или малый разрыв между двумя лучшими токенами).
- На 36 724 воспроизведённых шагах энтропия низкоточного прохода предсказывает смену argmax с AUC 0,93; при бюджете 15% критерий по энтропии ловит 78% смен, по разрыву, 94% (случайный, 15% по расчёту).
- В живом тесте на 150 задачах GSM8K с Qwen3-0.6B: 64,0% при высокой точности, 55,3% при низкой, 62,7% у энтропийного критерия при 16% повышений и 0,87 от байтов весов.
- Разница критерия с обоими крайними режимами статистически не подтверждена (−1,3 п.п. к высокой, интервал −8,0…+5,3; +7,3 п.п. к низкой, p=0,080).
- Квантизация симулируется, стоимость, только байты весов на токен; вторая модель, случайный контроль вживую и живая KL не запускались.
Почему это важно
Для локального запуска небольших моделей узкое место, объём весов, читаемых на каждый токен, поэтому идея брать более грубую точность там, где модель уверена, и дорогую только на сомнительных шагах выглядит естественной. Работа показывает, что неуверенность низкоточного прохода хорошо предсказывает, где грубая точность изменит выбор токена (AUC 0,93 на воспроизведённых шагах). Но главный практический вопрос, сохраняется ли качество, на живом тесте остался без ответа: разница с обоими режимами не подтверждена.
Кому это важно
Тем, кто занимается квантизацией и эффективным запуском небольших моделей на локальном оборудовании, а также исследователям адаптивного распределения вычислений по шагам декодирования. Для обычных пользователей это пока лабораторный результат на модели с 0,6 млрд параметров, без реальных замеров скорости.
Как это применить
Готового инструмента из текста не следует: квантизация симулируется, а выигрыш измерен лишь в байтах весов на токен (0,87 от режима «всё в высокой точности» при 16% повышений). Значения порогов энтропии и разрыва в источнике не указаны. Практически это идея для проверки на реальных низкобитных ядрах и на своих моделях, а не рецепт для внедрения.
Можно ли доверять
Это препринт на Hugging Face Papers, и сами авторы честно пишут, что живые данные не разделяют критерий и крайние режимы. Сильные цифры (78% и 94%) получены на воспроизведённых шагах, а не в живом прогоне; 15% для случайного критерия, расчётное ожидание. Живой тест, всего 150 задач, одна модель, один бенчмарк. Имена авторов и организаций в доступном тексте не названы, кода или даты публикации в нём нет.
Риски и подводные камни
Симулированная квантизация не равна реальному исполнению на оборудовании: повторный пересчёт шага в 8 битах может иметь свои накладные расходы, которые стоимостная модель в байтах не отражает, а реальных замеров скорости, задержки и энергии нет. Результат получен на Qwen3-0.6B и GSM8K; не проверены вторая модель, живой случайный контроль и правило для режима рассуждения. Кроме того, верифицированная спекуляция в той же модели стоимости достигает нулевой KL при сопоставимых байтах, то есть альтернатива, по оценке авторов, не хуже по этому показателю.