DiffusionART: метод RL-дообучения диффузионных моделей, примерно в 12 раз меньше GPU-часов
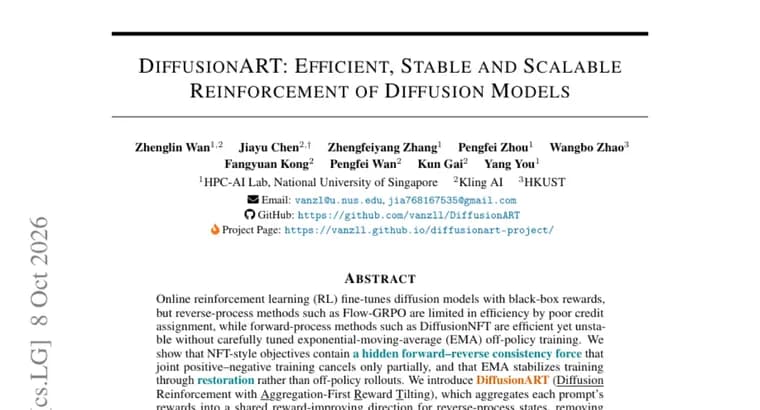
В статье из списка Hugging Face Papers представлен DiffusionART (Diffusion Reinforcement with Aggregation-First Reward Tilting), метод онлайн-обучения с подкреплением (RL) для дообучения диффузионных моделей с вознаграждениями типа «чёрный ящик».
Авторы исходят из того, что у существующих подходов есть слабое место. Методы обратного процесса (reverse-process), такие как Flow-GRPO, ограничены в эффективности из-за плохого распределения вклада (credit assignment). Методы прямого процесса (forward-process), такие как DiffusionNFT, эффективны, но нестабильны без тщательно настроенного off-policy-обучения с экспоненциальным скользящим средним (EMA).
Авторы показывают, что цели в стиле NFT содержат скрытую «силу согласованности» прямого и обратного процессов, которую совместное обучение на положительных и отрицательных примерах гасит лишь частично. Кроме того, по их выводу, EMA стабилизирует обучение за счёт «восстановления» (restoration), а не благодаря off-policy-прогонам.
DiffusionART устроен так: награды каждого промпта агрегируются в общее направление улучшения награды для состояний обратного процесса, и эта сила согласованности устраняется по построению. Дополнительно метод делает второй шаг обновления с маской доверительной области (trust region), это даёт восстановление, адаптивное к дрейфу, без настройки EMA. Метод не требует дифференцируемой модели награды, остаётся эффективным при меньшем числе сэмплов на промпт и поддерживает парные модели награды (вариант DiffusionART-Pairwise).
По заявлению авторов, в генерации изображений и видео DiffusionART обучается эффективно и стабильно без настройки под отдельные задачи. Главный пример, HunyuanVideo-13B с равновесно взвешенными наградами за визуальное качество и качество движения: метод достигает поздних уровней средней награды DiffusionNFT и Flow-GRPO-Fast с числом GPU-часов, меньшим в 12,02 и 11,72 раза соответственно, а средняя обучающая награда при этом выше на 28,8% и 53,0%.
Ключевые факты
- DiffusionART, метод онлайн-RL для дообучения диффузионных моделей, который агрегирует награды каждого промпта в общее направление улучшения и добавляет второй шаг обновления с маской доверительной области.
- Метод призван сохранить эффективность DiffusionNFT, но убрать его нестабильность и необходимость тщательной настройки EMA.
- На HunyuanVideo-13B (равные веса наград за визуальное качество и движение) уровень DiffusionNFT и Flow-GRPO-Fast достигается с числом GPU-часов, меньшим в 12,02 и 11,72 раза.
- Средняя обучающая награда выше на 28,8% относительно DiffusionNFT и на 53,0% относительно Flow-GRPO-Fast.
- Не нужна дифференцируемая модель награды; метод работает при меньшем числе сэмплов на промпт и поддерживает парные модели награды (DiffusionART-Pairwise).
Почему это важно
Дообучение диффузионных моделей по наградам упирается в компромисс, который описывают авторы: методы обратного процесса вроде Flow-GRPO неэффективны из-за плохого распределения вклада, а методы прямого процесса вроде DiffusionNFT быстры, но нестабильны без аккуратной настройки EMA. DiffusionART заявлен как способ получить эффективность без этой нестабильности. Заявленная экономия, примерно в 12 раз меньше GPU-часов на HunyuanVideo-13B для достижения тех же поздних уровней средней награды, для 13-миллиардной видеомодели означает заметное сокращение вычислений.
Кому это важно
Исследователям и командам, которые дообучают диффузионные модели изображений и видео с помощью RL и сравнивают подходы Flow-GRPO и DiffusionNFT. Отдельно любопытно тем, у кого награда недифференцируема или есть только парные оценки: метод не требует дифференцируемой модели награды и поддерживает парные модели награды.
Как это применить
В источнике (аннотации статьи) приведено описание метода и результаты, но не упомянуты ни код, ни модели, ни лицензия, поэтому готового инструмента для запуска из него не следует. Практически значимы свойства, которые заявляют авторы: не нужно настраивать EMA, метод остаётся эффективным при меньшем числе сэмплов на промпт и не требует настройки под отдельные задачи. Для оценки применимости стоит дождаться полного текста статьи и, при наличии, реализации.
Можно ли доверять
Все цифры взяты из аннотации статьи и принадлежат её авторам; в источнике не указаны независимое воспроизведение и статус рецензирования. Числа 28,8% и 53,0% относятся к средней награде во время обучения, а не к итоговым оценкам качества и не к предпочтениям людей. Модели и задачи для экспериментов с изображениями в аннотации не названы, абсолютные значения наград и общее число GPU-часов тоже не приведены.
Риски и подводные камни
Главный заявленный результат получен на одной конфигурации, HunyuanVideo-13B с равными весами наград за визуальное качество и движение; перенос на другие модели и награды в источнике подтверждён лишь общим утверждением об изображениях и видео. Выигрыш в GPU-часах измеряется как время достижения поздних уровней средней награды базовых методов, а не как выигрыш в итоговом качестве генерации. Рост средней обучающей награды сам по себе не доказывает улучшения качества для зрителя: метрики наград могут расходиться с реальным восприятием.
«В генерации изображений и видео DiffusionART обучается эффективно и стабильно без настройки под отдельные задачи.»
— из аннотации статьи