Cartesia заявила: H-Net без токенизатора даёт до 3-5x экономии вычислений
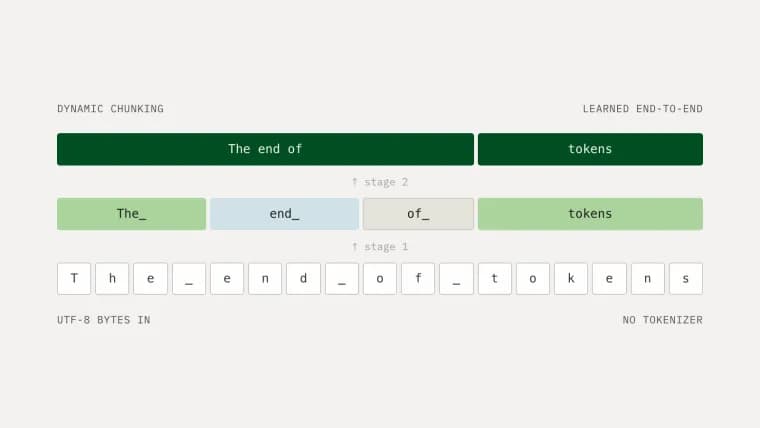
Cartesia опубликовала первую из двух статей в блоге о масштабировании иерархических сетей (H-Nets). Это архитектура, которая работает напрямую с байтами и заменяет фиксированную токенизацию текста обучаемым разбиением на фрагменты внутри самой модели. Концепцию H-Net авторы (в тексте они пишут о себе «мы») разработали в 2025 году, с тех пор, по их словам, существенно её улучшили и собираются выпустить улучшенную версию. Все результаты в статье получены на ней и приведены самими авторами.
Исходная мысль опирается на «горький урок» Ричарда Саттона (эссе 2019 года): общие методы, которые учатся на масштабе и содержат как можно меньше придуманных людьми допущений, выигрывают. Языковые модели во многом следуют этому принципу, но всё ещё зависят от ручных шагов кодирования, прежде всего токенизаторов. Авторы считают, что байтовые языковые модели, основа дальнейшего прогресса ИИ и проверка для общих методов обучения: «если мы не можем выучить язык из символов и байтов, на что мы вправе рассчитывать дальше».
Как устроен H-Net. Обычная модель получает на вход токены, заранее заданные фрагменты байтов, например из словаря BPE (Byte Pair Encoding, объединение частых пар) размером 128 тысяч, как у Llama-3. На данных авторов один BPE-токен покрывает около 4,57 байта. H-Net вместо этого получает сырые байты и сам, внутри модели и сквозным образом, укрупняет их: символы в слова, слова во фразы, фразы в понятия. Структура состоит из кодировщика, основной сети и декодировщика; кодировщик и декодировщик вместе называют внешними сетями, основную, внутренней. H-Net можно вкладывать друг в друга, получая несколько ступеней абстракции, и в принципе применять к данным любого типа, в том числе непрерывным.
Заявленные результаты первой статьи: , Авторы построили стандартную «лестницу» масштабирования для Transformer с BPE-токенизатором и показали, что тщательно контролируемые 1-ступенчатые H-Net дают выигрыш в вычислительной эффективности до 3-5x только за счёт обучаемой токенизации. , Более гибкая 2-ступенчатая H-Net, по их данным, превосходит сопоставимую модель с открытым кодом при 10x меньших вычислениях и данных. Какая именно это модель, в доступном тексте не названо. , Сети осваивают новые для языковых моделей поведения, например токенизацию в контексте. , Исследования на биологических данных и в компьютерном зрении ещё идут и пока лишь показывают перспективность H-Net как универсальной архитектуры.
Как проводили сравнение. Базовая модель, BPE Transformer, построенный по современным практикам масштабирования (в духе рецептов Kimi и MAI): число слоёв задаёт всё семейство, отношение скрытой размерности к числу слоёв около 75, число голов внимания равно числу слоёв, размер головы 128, слои SwiGLU с промежуточной размерностью 3,6D. Для всех запусков использовали оптимизатор Muon и расписание скорости обучения WSD. Затем каждую ступень лестницы заменяли 1-ступенчатой байтовой H-Net, сохраняя остов и гиперпараметры. Это дало улучшение по validation loss в 1,3x, на коде в 2x, а вне обучающего распределения, в 2x на оценке и до 5x на коде вне домена.
Для честности сравнения данные брали в двух представлениях, байтах и BPE-токенах с совпадающими границами документов. Состав по байтам: 70% английский, 20% код, 5% математика, 5% многоязычные тексты. Метрика, bits-per-byte, нормированная между разными токенизаторами. Отдельно авторы обучили BPE-токенизатор на собственном корпусе: средняя длина токена выросла с 4,45 (Llama-3) до 4,57 байта, а сам он дал около 1,1x выигрыша по вычислениям. Поэтому, как пишут авторы, против обычного готового токенизатора мультипликатор H-Net был бы ещё больше. Для сравнения они приводят мультипликаторы вычислений 1,16x у Kimi Delta Attention и 1,25x у attention residuals.
Вторая статья серии должна глубже разобрать более широкий набор моделей и объяснить, почему H-Net так эффективны для языкового моделирования.
Ключевые факты
- Cartesia описала улучшенные иерархические сети H-Net: байтовая архитектура без внешнего токенизатора, где разбиение на фрагменты обучается внутри модели; релиз улучшенной версии только планируется.
- 1-ступенчатые H-Net, по заявлению авторов, дают выигрыш в вычислениях до 3-5x над Transformer с BPE; на validation loss улучшение 1,3x, на коде 2x, вне распределения 2x и до 5x на коде вне домена.
- 2-ступенчатая H-Net, по их данным, превосходит сопоставимую модель с открытым кодом при 10x меньших вычислениях и данных.
- Сравнение контролируемое: те же тексты в байтах и BPE-токенах, метрика bits-per-byte, BPE-токенизатор переобучен на собственном корпусе (128k словарь, 4,57 байта на токен), состав данных 70% английский, 20% код, 5% математика, 5% многоязычные.
- Авторы подают результаты как свидетельство, а не доказательство; исследования H-Net в биологии и зрении ещё идут.
Почему это важно
Токенизация остаётся одним из немногих шагов конвейера языковых моделей, который задан вручную, а не выучен. Cartesia утверждает, что обучаемое разбиение на фрагменты внутри модели не только убирает этот шаг, но и заметно экономит вычисления: до 3-5x у 1-ступенчатой H-Net против Transformer с BPE и 10x по вычислениям и данным у 2-ступенчатой против сопоставимой модели с открытым кодом. Если подтвердится, это довод в пользу байтовых моделей, особенно для данных, где токенизировать трудно (авторы называют биологию, зрение и непрерывные данные).
Кому это важно
Исследователям архитектур и предобучения языковых моделей, командам, которые занимаются законами масштабирования и токенизацией, а также тем, кто работает с данными, плохо ложащимися на токены: код, многоязычные тексты, биологические и другие непрерывные сигналы. Для обычных пользователей нейросетей практического эффекта пока нет: речь о результатах исследования.
Как это применить
Напрямую пока нечего применять: улучшенную версию H-Net авторы только планируют выпустить, срок релиза в тексте не назван. Практически полезны методические детали: как строить лестницу масштабирования для Transformer (отношение размерности к числу слоёв около 75, SwiGLU с промежуточной размерностью 3,6D, Muon и WSD), как сравнивать байтовые и токенные модели по bits-per-byte на одинаковых данных и как честно считать FLOPs, учитывая только причинное внимание. Подробности прочитать можно в самой статье и в оригинальной работе по H-Net 2025 года.
Можно ли доверять
Это блог самой Cartesia, то есть результаты получены и поданы авторами, независимой проверки в тексте нет. Сами авторы называют итог свидетельством, а не доказательством. Модель с открытым кодом, с которой сравнивают 2-ступенчатую H-Net, в доступном тексте не названа, а детальные таблицы и аппроксимации масштабирования до нас не дошли. Не уточнено и то, как соотносятся выигрыш «1,3x» по validation loss и «до 3-5x» по вычислениям. Плюс, аккуратная методика: общие данные, выровненные границы, переобученный BPE-токенизатор в качестве более сильной базовой линии.
Риски и подводные камни
Верхняя граница «до 3-5x», лучший случай, а не типичный: на validation loss приведено 1,3x. Все выводы получены на улучшенной версии, которая ещё не выпущена, поэтому воспроизвести их нельзя. Сравнение 1-ступенчатой H-Net ограничено ролью замены токенизатора, а для 2-ступенчатой используется иной, более гибкий вариант, так что эти цифры не стоит смешивать. Результаты по биологии и зрению авторы называют продолжающимися исследованиями, которые лишь показывают перспективность. Байтовые последовательности длиннее токенных, поэтому честный учёт вычислений здесь критичен.
«Если мы не можем даже хорошо выучить язык из символов и байтов, какое право мы имеем двигаться к следующему рубежу?»
— авторы блога Cartesia