BVSR: в статье предложили ограничивать ИИ-учёным информацию о задаче ради оригинальных идей
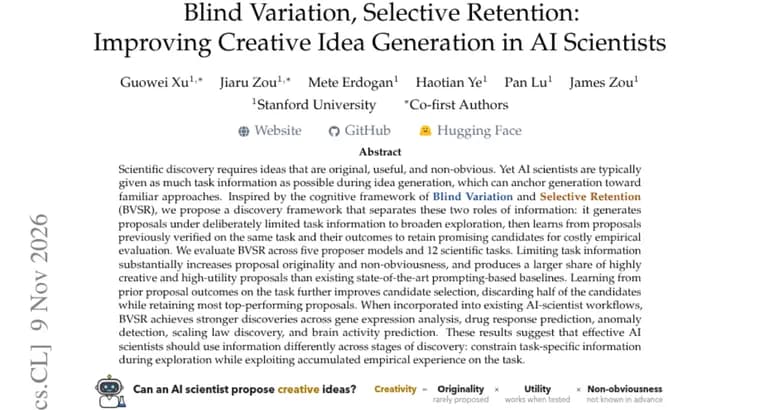
В статье на Hugging Face предложен фреймворк открытий BVSR (Blind Variation and Selective Retention, «слепая вариация и избирательное сохранение»), вдохновлённый одноимённой когнитивной концепцией. Отправная точка авторов: научное открытие требует идей оригинальных, полезных и неочевидных, а ИИ-учёным обычно дают как можно больше информации о задаче. По мнению авторов, это может привязывать генерацию к привычным подходам.
BVSR разделяет две роли информации. На первом этапе предложения генерируются при намеренно ограниченной информации о задаче, чтобы расширить поиск. На втором этапе система учится на предложениях, уже проверенных на этой же задаче, и на их результатах, и по ним отбирает перспективных кандидатов для дорогой эмпирической проверки.
Фреймворк оценили на пяти моделях-генераторах предложений и 12 научных задачах. По результатам авторов, ограничение информации о задаче заметно повышает оригинальность и неочевидность предложений и даёт большую долю высококреативных и высокополезных предложений, чем существующие передовые базовые методы на основе промптов. Обучение на прежних результатах по задаче дополнительно улучшает отбор: отбрасывается половина кандидатов, а большинство лучших предложений сохраняется.
При встраивании в существующие рабочие процессы ИИ-учёных BVSR, как сообщают авторы, даёт более сильные открытия в пяти областях: анализ экспрессии генов, предсказание реакции на лекарства, поиск аномалий, открытие законов масштабирования и предсказание мозговой активности. Общий вывод: эффективным ИИ-учёным стоит использовать информацию по-разному на разных стадиях открытия, ограничивать специфичные для задачи сведения при исследовании и использовать накопленный эмпирический опыт по задаче при отборе.
Ключевые факты
- BVSR разделяет два этапа: генерация идей при намеренно ограниченной информации о задаче и отбор кандидатов по результатам ранее проверенных предложений на той же задаче.
- Оценка охватывает пять моделей-генераторов предложений и 12 научных задач.
- Ограничение информации, по данным авторов, повышает оригинальность и неочевидность идей и увеличивает долю высококреативных и высокополезных предложений относительно базовых методов на основе промптов.
- Обучение на прежних результатах позволяет отбросить половину кандидатов, сохранив большинство лучших предложений.
- В составе существующих рабочих процессов ИИ-учёных BVSR показал более сильные открытия в генетике, фармакологии, поиске аномалий, законах масштабирования и предсказании мозговой активности.
Почему это важно
Идея контринтуитивна: обычно считается, что чем больше сведений о задаче получает ИИ-учёный, тем лучше. Авторы утверждают обратное для стадии поиска идей: избыток информации может привязывать генерацию к знакомым подходам. Они предлагают разводить стадии: на исследовании информацию ограничивать, на отборе, наоборот, использовать накопленный опыт. Кроме того, дорогую эмпирическую проверку предлагается тратить только на перспективных кандидатов: по сообщению авторов, отбрасывается половина кандидатов при сохранении большинства лучших.
Кому это важно
Командам, которые строят системы ИИ-учёных и автоматизированного поиска гипотез, а также исследователям в областях из оценки: анализ экспрессии генов, предсказание реакции на лекарства, поиск аномалий, законы масштабирования, предсказание мозговой активности. Тем, у кого каждая проверка гипотезы стоит дорого, интересна сама идея предварительного отсева кандидатов.
Как это применить
Из аннотации следует общий принцип: на этапе генерации идей давать модели меньше деталей задачи, а затем отбирать кандидатов с учётом результатов уже проверенных на этой задаче предложений. Авторы сообщают, что BVSR встраивается в существующие рабочие процессы ИИ-учёных. Подробности реализации, кода и вычислительных затрат в тексте источника не приведены.
Можно ли доверять
В тексте источника, по которому сделан пересказ, названия авторов и организаций не указаны. Все оценки (рост оригинальности, большая доля креативных предложений, более сильные открытия), это заявления самих авторов. Числовые величины эффекта в аннотации не даны. Модели-генераторы и базовые методы для сравнения не названы, 12 задач не перечислены поимённо: названы лишь пять областей. «Половина кандидатов» указана как доля, а не как измеренный процент, а «большинство лучших предложений» не квантифицировано.
Риски и подводные камни
Без числовых результатов трудно судить, насколько велик выигрыш и устойчив ли он на других моделях и задачах. Не сказано, проверялись ли открытия за пределами собственных задач статьи. Вывод о том, что ограничение информации помогает, сформулирован как предположение авторов («эти результаты говорят о том, что…»), а не как доказанный общий закон. Отбор по результатам прежних проверок требует, чтобы на той же задаче уже были проверенные предложения.
«Эти результаты говорят о том, что эффективные ИИ-учёные должны использовать информацию по-разному на разных стадиях открытия: ограничивать специфичную для задачи информацию при исследовании и использовать накопленный эмпирический опыт по задаче.»
— из аннотации статьи