Бенчмарк IdeaAMBIG: ИИ-модели не находят пробелы в описании методов
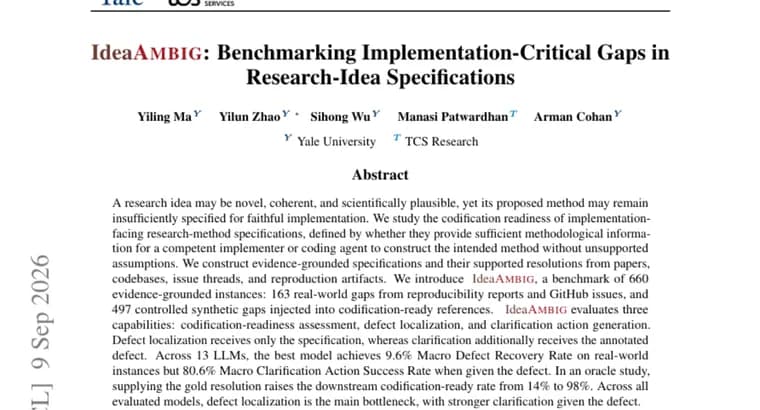
Исследователи представили бенчмарк IdeaAMBIG, который проверяет способность языковых моделей оценивать, достаточно ли детально описан метод исследования для того, чтобы компетентный разработчик или ИИ-агент мог реализовать его в коде без домыслов. Идея может быть новой, логичной и научно правдоподобной, но её метод при этом остаётся недостаточно специфицированным для точной реализации, именно эту проблему авторы называют «готовностью к кодификации».
Бенчмарк построен на 660 случаях, привязанных к конкретным доказательствам: 163, это реальные пробелы, взятые из отчётов о попытках воспроизвести чужие исследования и из обсуждений в issue на GitHub, а 497, контролируемые синтетические пробелы, специально внесённые в изначально готовые к кодификации описания.
Модели проверяют по трём способностям: оценке готовности спецификации к кодификации, поиску (локализации) конкретного дефекта в описании и генерации уточняющего действия, при этом на этапе поиска дефекта модель получает только саму спецификацию, а на этапе генерации уточнения ей дополнительно сообщают, в чём именно аннотированный дефект состоит.
Авторы прогнали через бенчмарк 13 языковых моделей. Лучшая из них справилась с поиском дефектов в реальных случаях лишь на 9,6% (Macro Defect Recovery Rate), но при этом показала 80,6% (Macro Clarification Action Success Rate) в задаче уточнения, если ей заранее указывали, где именно находится пробел. Отдельный оракульный эксперимент показал: если модели сразу дать эталонное («золотое») разрешение пробела, доля спецификаций, готовых к кодификации, вырастает с 14% до 98%. Вывод авторов: у всех проверенных моделей главное узкое место, именно локализация дефекта, а не формулировка уточнения, которая заметно сильнее, когда дефект уже найден.
Ключевые факты
- Бенчмарк IdeaAMBIG включает 660 случаев: 163 реальных пробела из отчётов о воспроизведении исследований и обсуждений на GitHub, и 497 синтетических пробелов, внесённых намеренно
- Модели проверяются по трём задачам: оценка готовности к кодификации, локализация дефекта и генерация уточнения
- На бенчмарке протестировали 13 языковых моделей
- Лучшая модель нашла лишь 9,6% реальных дефектов (Macro Defect Recovery Rate), но справилась с уточнением на 80,6% (Macro Clarification Action Success Rate), когда дефект был уже указан
- В оракульном эксперименте эталонное разрешение пробела поднимает долю готовых к кодификации спецификаций с 14% до 98%
Почему это важно
Бенчмарк обнажает разрыв между двумя разными навыками ИИ: понять, что в описании метода чего-то не хватает для его реализации, и понять, что именно не хватает. Модели неплохо справляются с уточнением, когда им прямо указали дефект, но почти не способны найти его сами, а это ровно тот навык, который нужен для автономной работы ИИ-агента с чужими научными текстами.
Кому это важно
Разработчикам ИИ-агентов, которые должны превращать описания методов из статей в рабочий код, исследователям, изучающим воспроизводимость научных работ, и командам, которые оценивают, насколько ИИ можно доверить самостоятельную реализацию чужих методов без присмотра человека.
Как это применить
Бенчмарк можно использовать как тест перед тем, как поручать модели автономную реализацию метода из статьи: результаты показывают, что этап проверки готовности спецификации и поиска пробелов в ней нужно оставлять человеку или отдельному инструменту, а этап уточнения, там, где модель уже сильна, можно доверять ИИ.
Можно ли доверять
Это препринт на Hugging Face Papers, в тексте аннотации не указаны ни авторская аффилиация, ни институт, ни дата публикации бенчмарка. Методология, 660 привязанных к доказательствам случаев, разделённых на реальные и синтетические, описана в самой аннотации; детали механизма внесения синтетических пробелов в тексте не раскрыты.
Риски и подводные камни
Главный риск, переоценить способность ИИ-агентов самостоятельно замечать недосказанность в описании метода: без внешней подсказки о том, где именно пробел, лучшая из 13 моделей ошибается в подавляющем большинстве реальных случаев, а значит реализация чужого метода вслепую может опираться на непроверенные допущения агента.