Авторы LowRAM предложили сжатие KV-кэша: декодирование до 5 раз быстрее
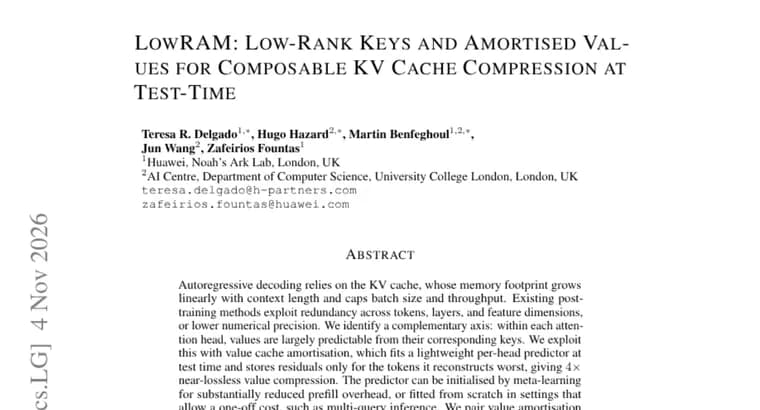
При генерации текста нейросеть опирается на KV-кэш (хранилище ключей и значений внимания). Его объём растёт линейно с длиной контекста и ограничивает размер пакета запросов и пропускную способность. Существующие методы, которые применяют уже после обучения, используют избыточность между токенами, слоями и признаковыми измерениями либо снижают числовую точность.
Авторы статьи предлагают ещё одну ось избыточности: внутри каждой головы внимания значения (values) в основном предсказуемы по соответствующим ключам (keys). На этом построена амортизация кэша значений. Во время работы модели (в момент теста) подбирается лёгкий предсказатель для каждой головы, а остатки (разницу между предсказанием и реальностью) хранятся только для тех токенов, которые предсказатель восстанавливает хуже всего. Это даёт сжатие значений в 4 раза, которое авторы называют почти беспотерьным.
Предсказатель можно инициализировать с помощью метаобучения, чтобы заметно снизить накладные расходы на предварительную обработку промпта (prefill), либо подбирать с нуля там, где допустима разовая затрата, например при многократных запросах к одному контексту (multi-query inference).
Амортизацию значений авторы объединяют со сжатием ключей по низкому рангу между слоями. Получается асимметричный конвейер сжатия LowRAM, который, по заявлению авторов, остаётся близким к беспотерьному на трёх семействах моделей. На каждом шаге декодирования восстанавливается лишь выбранное подмножество пар «ключ, значение», поэтому накладные расходы на декодирование минимальны, а пиковая пропускная способность при декодировании при сжатии в 4 раза вырастает до 5 раз.
LowRAM также сочетается с квантизацией и вытеснением (eviction) токенов из кэша: на длинных контекстах авторы получили сжатие в 26,9 раза при сохранении 94,5% от базовой производительности. Вывод авторов: раздельное отношение к ключам и значениям как к структурно разным объектам позволяет сжимать KV-кэш эффективно, агрессивно и композируемо.
Ключевые факты
- Идея: внутри каждой головы внимания значения в основном предсказуемы по ключам, поэтому для значений подбирается лёгкий предсказатель, а остатки хранятся лишь для хуже всего восстанавливаемых токенов.
- Амортизация кэша значений даёт сжатие в 4 раза, которое авторы называют почти беспотерьным.
- LowRAM сочетает её со сжатием ключей по низкому рангу между слоями; метод остаётся близким к беспотерьному на трёх семействах моделей.
- При сжатии в 4 раза пиковая пропускная способность декодирования вырастает до 5 раз.
- Вместе с квантизацией и вытеснением токенов: сжатие в 26,9 раза при 94,5% от базовой производительности на длинных контекстах.
Почему это важно
KV-кэш растёт линейно с длиной контекста и ограничивает размер пакета запросов и скорость декодирования, поэтому его сжатие остаётся одной из центральных задач при работе с длинными контекстами. Новизна работы, по заявлению авторов, в том, что они используют ещё не задействованную ось избыточности (предсказуемость значений по ключам внутри головы внимания) и обращаются с ключами и значениями асимметрично. Метод, по их словам, сочетается с уже известными приёмами: квантизацией и вытеснением токенов.
Кому это важно
Командам, которые запускают нейросети с длинным контекстом и упираются в память под KV-кэш, а также исследователям эффективного вывода (inference). Отдельно интересен вариант с многократными запросами к одному контексту, где разовые затраты на подбор предсказателя допустимы.
Как это применить
Из текста источника практическое применение не следует: о выпуске кода, моделей или лицензии в нём ничего не сказано. Из описания видно два режима: инициализация предсказателя метаобучением (заметно меньше накладных расходов на prefill) или подбор с нуля там, где допустима разовая затрата, например при многократных запросах. Для оценки пригодности в своей системе нужно дождаться полного текста статьи и воспроизводимых результатов.
Можно ли доверять
Это работа, размещённая на Hugging Face Papers, и все цифры принадлежат самим авторам. В аннотации не названы три семейства моделей, размеры моделей, тесты и метрика, стоящие за словами «производительность» и «длинные контексты». Не указана и база, относительно которой считается ускорение «до 5 раз». Сравнения с конкретными конкурирующими методами сжатия KV-кэша не приводится. Поэтому заявленные результаты стоит считать предварительными до проверки по полному тексту.
Риски и подводные камни
Заявленные цифры (сжатие значений в 4 раза, ускорение до 5 раз, сжатие в 26,9 раза при 94,5% производительности) относятся к разным конфигурациям и не складываются в одно число: 5 раз, это максимум при сжатии в 4 раза, а 26,9 раза достигнуто в комбинации с квантизацией и вытеснением. Формулировки «почти беспотерьно» и «близко к беспотерьному» не подкреплены в аннотации числами потерь качества. Накладные расходы на prefill при подборе предсказателя в аннотации не измерены, а режим без метаобучения требует разовой затраты.