Автор блога поднял успех JEPA-модели LeWM с 22% до 85% без дообучения
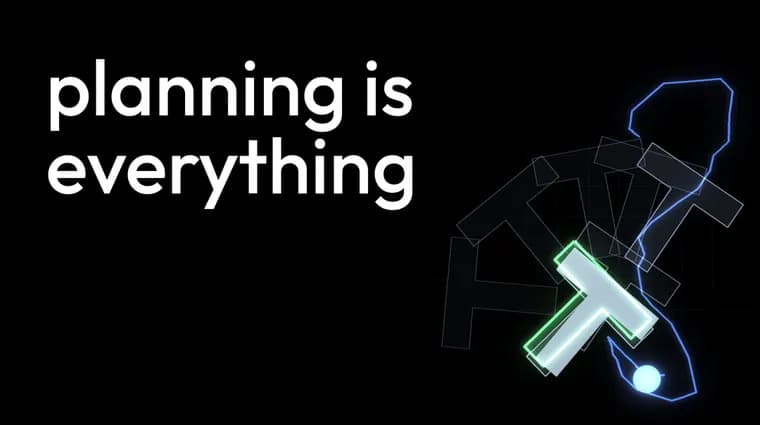
Автор блога haddyalchaer.com (имя в тексте не указано) описывает итоги 600 экспериментов с LeWM. Это JEPA-модель мира, которую в этом году выпустила команда с участием Яна ЛеКуна. Её главный бенчмарк, Push-T: в симуляции робот двигает серый Т-образный блок по столу, пока тот не встанет в зелёную целевую позицию, показанную на картинке-цели.
Контекст. Идёт спор о том, какой должна быть модель мира. Генеративные модели предсказывают будущее, создавая его, обычно в пикселях. Многие учёные, включая ЛеКуна, считают это напрасной тратой сил: большая часть пикселей не нужна для выбора действий, а многое предсказать невозможно. Альтернатива, JEPA (joint-embedding predictive architecture, архитектура совместного предсказания в пространстве представлений) из трёх частей. Энкодер превращает каждый кадр в эмбеддинг, компактный вектор, описывающий сцену. Предиктор по эмбеддингу и действию предсказывает эмбеддинг следующего кадра. Планировщик перебирает сотни последовательностей действий внутри предиктора и выбирает ту, у которой предсказанное конечное состояние ближе всего к эмбеддингу цели.
Первый вопрос автора: насколько LeWM ограничена качеством предсказаний. Он заменил предиктор на идеальную физику симулятора, оставив всё остальное прежним, и дал обеим версиям длинные задачи: цель в 75 шагах, а подцели, кадры экспертной демонстрации через каждые 25 шагов. Обычная LeWM справилась в 78% случаев, версия с точной физикой, в 77%. Вывод автора: на тех траекториях, на которых модель обучалась, её предсказания для планирования уже не хуже точной физики. Значит, дальнейший выигрыш даёт то, как используется обученная архитектура, и на это ушло большинство экспериментов.
Без единого дообучения автор нашёл четыре новых метода планирования. Первые два вместе подняли успех LeWM на длинных задачах с 22% до 85%, что примерно равно планировщику, которому выдали идеальные подцели из экспертной демонстрации. Два других метода расширяют LeWM на более трудные цели; по словам автора, один из них, единственное изменение в оценке цели, добавил 60 пунктов успеха, втрое больше, чем замена на идеальную физику.
Метод 1: планировать по подцелям через 25 шагов. LeWM в опубликованном виде решает 22% длинных задач с целью в 75 шагах. Если цель в 25 шагах, она достигает её в 89,7% случаев, а версия с точной физикой, в 90,5%. Обычное объяснение: мелкие ошибки предсказаний накапливаются на длинном плане, и нужна модель получше. Автор проверил это на тех же 250 длинных задачах: точная физика добавила 20 пунктов, а разбиение на отрезки по 25 шагов, почти 60. Полезный горизонт планирования LeWM, около 25 шагов, поэтому дальше надо цеплять такие отрезки друг за другом. Это иерархическое планирование: верхний уровень выбирает подцели, нижний их достигает. Автор называет его одной из главных открытых проблем для моделей мира; на Push-T оно ценнее точной физики втрое. Дополнительный перебор не заменяет его: четыре запуска планировщика с выбором плана с наименьшей стоимостью потребовали вчетверо больше вычислений и дали меньше одного пункта, потому что запуски почти всегда вместе удавались или вместе проваливались.
Метод 2: граф латентной памяти со стоимостью каждого перехода. Подцели из экспертной демонстрации у реального робота не будут доступны, и второй метод от них избавляет. Энкодер LeWM кодирует каждый кадр обучающих экспертных демонстраций, получается около 460 000 состояний, которые автор связал в граф. Каждое состояние соединено со следующими в своей демонстрации и с близкими по эмбеддингу состояниями из других демонстраций. Чтобы решить длинную задачу, планировщик ищет в графе путь от текущего состояния к цели и берёт состояния на пути как подцели. Это работает, только если расстояние в пространстве эмбеддингов физически осмысленно, и по замеру автора это так: из двух подцелей, достижимой за 25 шагов и недостижимой, расстояние LeWM называет достижимую более близкой в 87% случаев. Первая версия имела изъян: прыжок между близкими состояниями из разных демонстраций стоил как обычный шаг, и поиск сшивал прыжки в пути, которым блок не мог бы последовать (318 из 1015 планов пытались использовать шесть и более прыжков). Исправление, стоимость на каждый прыжок между демонстрациями. Используя только эмбеддинги LeWM по прошлым демонстрациям, автор поднял успех на тех же 250 длинных задачах (цель в 75 шагах) с 62% до 85%, столько же, сколько у планировщика с экспертными подцелями.
Видимый текст обрывается после второго метода: два других метода и заключение в нём не описаны.
Ключевые факты
- Автор блога провёл 600 экспериментов с LeWM, JEPA-моделью мира, выпущенной в этом году командой с участием Яна ЛеКуна; основной бенчмарк, Push-T.
- Замена предиктора на точную физику симулятора почти ничего не дала при подцелях через 25 шагов: 78% у обычной LeWM против 77% у версии с точной физикой.
- Планирование через подцели с шагом 25 шагов: на 250 длинных задачах разбиение добавило почти 60 пунктов успеха против 20 у точной физики.
- Граф из около 460 000 состояний экспертных демонстраций со стоимостью каждого перехода между ними поднял успех с 62% до 85% без экспертных подцелей.
- Первые два метода вместе подняли успех на длинных задачах (цель в 75 шагах) с 22% до 85%, без дообучения модели.
Почему это важно
Автор утверждает, что узкое место JEPA-модели LeWM не в предсказаниях, а в способе планирования: на траекториях, похожих на обучающие, её предиктор не хуже точной физики (78% против 77% при одинаковых подцелях). Если это так, улучшать такие модели можно, не переобучая их, а меняя алгоритм планирования. Иерархическое планирование автор называет одной из главных открытых проблем для моделей мира; здесь оно на Push-T оказалось ценнее идеальной физики втрое. Рост с 22% до 85% получен без дообучения.
Кому это важно
Исследователям моделей мира и JEPA-подобных архитектур, разработчикам планирования для робототехники и читателям, следящим за спором генеративных моделей в пикселях и моделей в пространстве эмбеддингов. Работа сфокусирована на одной симулированной задаче Push-T.
Как это применить
Прямого продукта или кода в видимом тексте нет, это описание идей. Из него следуют приёмы: разбивать цель на отрезки по 25 шагов (примерно полезный горизонт LeWM); строить граф из эмбеддингов экспертных демонстраций и ставить стоимость на каждый переход между разными демонстрациями; не рассчитывать, что повторные запуски планировщика с выбором лучшего плана помогут: четыре запуска дали меньше одного пункта при вчетверо большей стоимости вычислений.
Можно ли доверять
Это собственный разбор автора блога, имя которого в тексте не указано, без даты публикации; рецензирования, кода и ссылок на статьи в видимом тексте нет (есть только сноски [1], [2], [3]). Видимый текст обрывается после второго метода, поэтому два других метода, включая «60 пунктов» за изменение оценки цели, не описаны. Результаты относятся только к Push-T; про другие бенчмарки и реальных роботов ничего не сказано. Сравнение 78% и 77% сделано с экспертными подцелями каждые 25 шагов, а базовые 22%, без подцелей, это разные условия. ЛеКун назван одним из авторов LeWM, но об участии или одобрении им этих экспериментов не сообщается.
Риски и подводные камни
Результат получен в симуляции на одной задаче, и автор сам оговаривает границу: вывод о равенстве предсказаний точной физике относится к траекториям того типа, на которых модель обучалась. Граф строится из экспертных демонстраций той же задачи, так что за их пределами метод может не сработать, в видимом тексте это не проверяется. Первая версия графа выдавала нереалистичные планы из цепочек прыжков (318 из 1015 планов с шестью и более прыжками), и только штраф на прыжок это исправил, значит, метод чувствителен к такому выбору.