Анализ весов нашёл в моделях DeepSeek, Kimi и MiniMax след GPU Blackwell
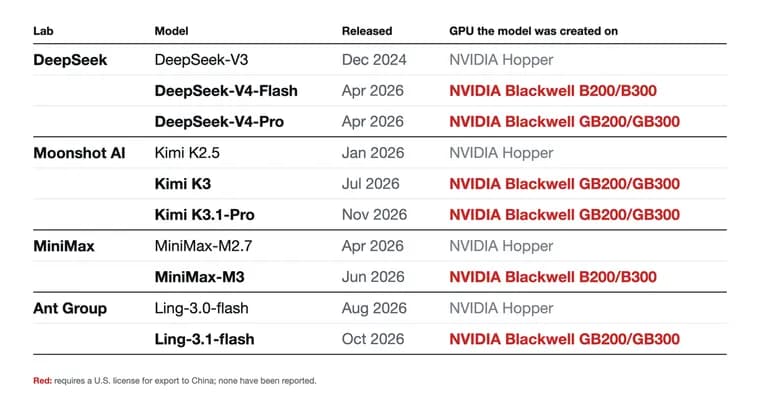
Блог unemploymentlabs.com (текст пересмотрен 12 ноября 2026 года) опубликовал криминалистический анализ открытых весов китайских нейросетей. Его вывод: шесть моделей, выпущенных DeepSeek, Moonshot AI, MiniMax и Ant Group с апреля 2026 года, содержат числовые закономерности, совпадающие с оборудованием NVIDIA Blackwell, а более ранние модели тех же компаний совпадают с прежним поколением Hopper. Авторы напоминают, что американские чиновники и пресса и раньше утверждали, что DeepSeek и Moonshot AI используют Blackwell, но технических доказательств не публиковали.
Метод опирается только на сами веса, без утечек и инсайдерских рассказов. Перед обучением веса получают начальные значения от генератора псевдослучайных чисел Philox. PyTorch через библиотеку cuRAND NVIDIA делит эту работу между параллельными потоками GPU, и на изученных чипах при достаточно большой инициализации на каждый потоковый мультипроцессор (SM) приходится максимум 2 048 потоков. Чем больше SM у чипа, тем иначе числа раскладываются по позициям. Для Hopper H100 SXM, H200 и H800 это 132 SM и 270 336 потоков, для Blackwell B200/B300, 148 SM и 303 104 потока, для GB200/GB300, 152 SM и 311 296 потоков. Часть весов (например, для слов и символов, ни разу не встретившихся при обучении) почти не меняется, так что их можно напрямую сравнить со значениями, которые дают подобранное зерно (seed) и число потоков. Авторы перебрали примерно 6 триллионов комбинаций зерна и раскладки. Если подставить неверное число потоков, совпадёт лишь малая часть значений (в упрощённом учебном примере с 5 и 6 SM, 6%).
По результатам, DeepSeek-V4-Flash и MiniMax-M3 совпадают с B200 или B300 (148 SM); DeepSeek-V4-Pro, Kimi K3, Kimi K3.1-Pro и Ling-3.1-flash, с GB200 или GB300 (152 SM). Kimi K3.1-Pro стартует с того же зерна, что и K3, и может быть его контрольной точкой с дополнительным дообучением. Для DeepSeek-V4-Flash и Kimi K3 совпадение проверили и на физических чипах Blackwell. По времени картина такая: DeepSeek читается как Hopper до DeepSeek-V3 (декабрь 2024) и как Blackwell с DeepSeek V4 (апрель 2026); Moonshot, Hopper до Kimi K2.5 (январь 2026) и Blackwell с K3 (июль 2026), а Kimi K2.7-Code, вышедшая за шесть недель до K3, построена на весах эпохи Hopper, но содержит небольшую часть, совпадающую с B200 или B300; MiniMax, Hopper до M2.7 (апрель 2026) и Blackwell с M3 (июнь 2026); у Ant Group Ling-3.0-flash (август 2026) читается как Hopper, а Ling-3.1-flash (октябрь 2026) как Blackwell. Не все лаборатории перешли: новейшие читаемые модели Alibaba (Qwen), Zhipu (GLM), Tencent, Xiaomi и StepFun читаются как обученные на Hopper, а Meituan заявляет, что LongCat-2.0 обучена целиком на «AI ASIC superpods», и NVIDIA-отпечатка в её опубликованных весах авторы не нашли.
О надёжности метода авторы пишут, что для 24 моделей, у которых разработчик публично назвал оборудование, результат метода во всех случаях совпал с заявлением. Собственная Nemotron-3 Ultra от NVIDIA, в техотчёте которой для одной фазы обучения назван GB200, читается как 152 SM, как и Kimi K3. Против случайности: при поиске по примерно 6 триллионам комбинаций самое сильное случайное совпадение ожидалось бы около 8 сигма, а лучшие свидетельства по каждой из шести моделей лежат в диапазоне от 49 до 1 385 сигма; даже самый слабый из приведённых тестов даёт 20 сигма.
Отдельно авторы грубо оценивают масштаб обучения. Две крупнейшие модели, Kimi K3 и DeepSeek-V4-Pro, обучались на кластерах Blackwell мощностью около 11 500 и 7 500 H100, то есть примерно 4 500 и 3 000 GPU Blackwell (один Blackwell делает работу около двух с половиной H100). Пять запусков вместе, около 30 000 эквивалентов H100, или 12 000 GPU Blackwell. При цене около $70 000 за GPU (оценка, выведенная из отчёта Wall Street Journal: около 36 000 чипов Blackwell, устанавливаемых в Малайзии для ByteDance, стоили бы свыше $2,5 млрд) крупнейший кластер обошёлся бы примерно в $300 млн, а пять вместе, примерно в $850 млн. Это только финальные запуски; общие траты лабораторий на GPU под экспортным контролем, по оценке авторов, вероятно, исчисляются миллиардами долларов.
Главная оговорка: отпечаток показывает, как были созданы веса, и лишь поддерживает, не доказывая, что и обучение шло на Blackwell. Единственная найденная альтернатива, специально настроенное оборудование AMD, тоже ограниченное в экспорте в Китай; для DeepSeek-V4-Flash его исключили, для остальных пяти моделей считают очень маловероятным. Где стояли чипы, как был получен доступ и нарушались ли экспортные ограничения, анализ не устанавливает.
Ключевые факты
- Шесть моделей DeepSeek, Moonshot AI, MiniMax и Ant Group, выпущенных с апреля 2026 года, по весам совпадают с GPU Blackwell (148 или 152 SM), тогда как ранние модели тех же лабораторий читаются как Hopper (132 SM).
- Метод находит начальные значения весов от генератора Philox и подбирает зерно и число потоков; для 24 моделей с публично известным оборудованием он во всех случаях совпал с заявлением разработчика.
- Статистика: самое сильное случайное совпадение ожидалось бы около 8 сигма, а лучшие свидетельства по шести моделям, от 49 до 1 385 сигма.
- Грубая оценка масштаба: Kimi K3 и DeepSeek-V4-Pro, примерно 4 500 и 3 000 GPU Blackwell, пять запусков вместе, около 12 000 GPU и около $850 млн (только финальные запуски).
- Авторы подчёркивают: вывод об обучении на Blackwell поддержан, но не доказан; местоположение чипов, способ доступа и нарушение экспортных ограничений анализом не установлены.
Почему это важно
Американские чиновники и пресса и раньше говорили, что DeepSeek и Moonshot AI используют Blackwell, но технических доказательств не приводили. Здесь предложен проверяемый по открытым весам метод, который к тому же показывает момент перехода: с апреля 2026 года у DeepSeek, с июня у MiniMax, с июля у Moonshot, с октября у Ant Group. Это касается вопроса о том, насколько экспортные ограничения на передовые чипы работают на практике. Заодно видно, что не все лаборатории перешли на Blackwell: Qwen, GLM, Tencent, Xiaomi и StepFun по новейшим читаемым моделям остаются на Hopper.
Кому это важно
Тем, кто следит за экспортным контролем на чипы и рынком ускорителей. Исследователям и инженерам, которым интересна криминалистика весов: способ опирается на то, как PyTorch и cuRAND раскладывают случайные числа по потокам. Компаниям, которые оценивают конкурентов и цепочки поставок вычислительных мощностей.
Как это применить
Напрямую применять нечего: это разбор, а не инструмент. Идею можно взять как приём проверки: если у открытой модели сохранились почти нетронутые веса (например, для не встречавшихся в обучении символов), их сравнивают со значениями, которые дают кандидатные зерно и число потоков. При этом разные чипы одного поколения (H800, H100 SXM, H200) методом не различаются, а названия H800 в таблице взяты из заявлений лабораторий, а не из метода.
Можно ли доверять
Источник, сторонний блог unemploymentlabs.com; в доступном тексте авторы и организация не названы, а ответов DeepSeek, Moonshot AI, MiniMax, Ant Group, NVIDIA или правительства США не видно. Сильные стороны: совпадение с известными ответами для 24 моделей, физическая проверка на чипах Blackwell для DeepSeek-V4-Flash и Kimi K3, очень высокая статистическая значимость. Оговорки самих авторов: оценки масштаба и стоимости они называют ненадёжными («we are not confident in these estimates»); они зависят от допущений об эффективности использования GPU (около 20%, для DeepSeek 25%), числе токенов (у DeepSeek взято из её данных, у остальных, собственные оценки авторов по ещё не опубликованному методу) и длительности запусков (от полутора до трёх месяцев; она выведена из сроков релизов, лаборатории её не раскрывали). 12 ноября таблицу пересмотрели: прежние 2 000-3 000 GPU Blackwell для крупнейших запусков были занижены. Источник доступен не полностью: приложения и содержимое таблиц не видны.
Риски и подводные камни
Авторы сами говорят, что отпечаток доказывает происхождение весов, а не обучение: вывод о Blackwell остаётся умозаключением, а единственной альтернативой названо специально настроенное оборудование AMD (для пяти моделей считается очень маловероятным). Анализ не устанавливает, где находились чипы, как получен доступ и нарушены ли ограничения; в сноске к таблице сказано лишь, что для экспорта в Китай нужна лицензия и о таких лицензиях не сообщалось. Оценка масштаба сильно зависит от длительности запуска: если уменьшить её вдвое, число GPU удвоится. Для сравнения: Mistral заявляет об обучении Mistral Large 4 на 3 800 Grace Blackwell GPU, а Microsoft, об обучении MAI-Base-2 на 16 000 за 38 дней; при темпе Microsoft для двух крупнейших китайских моделей потребовалось бы около 7 000-8 500 GPU Blackwell. Расчёты охватывают только финальные запуски, без экспериментов, прежних запусков и обслуживания моделей.
«Отпечаток показывает, как были созданы веса, и поддерживает, не доказывая, вывод о том, что обучение тоже выполнялось на Blackwell.»
— Авторы анализа, unemploymentlabs.com