A-RSI: нейросеть сама решает, когда обновлять обучающие задачи
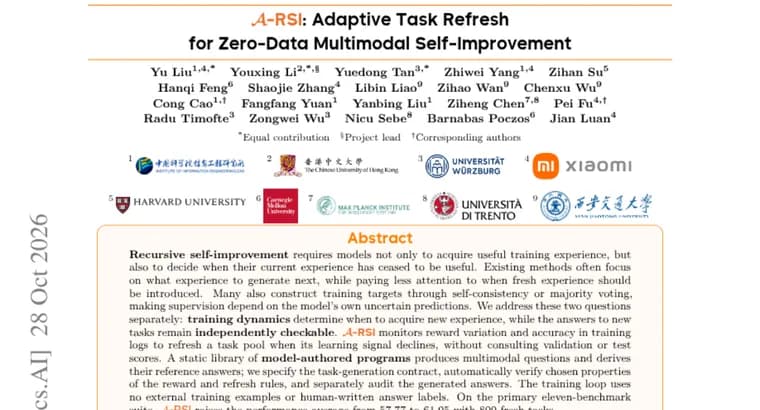
На Hugging Face Papers опубликован препринт A-RSI, метод мультимодального самоулучшения без внешних данных (zero-data). Авторы исходят из того, что рекурсивное самоулучшение требует от модели не только получать полезный обучающий опыт, но и определять, когда текущий опыт перестал быть полезным. По их утверждению, существующие методы обычно сосредоточены на том, какой опыт генерировать дальше, и меньше внимания уделяют тому, когда нужно вводить свежий опыт. Кроме того, многие методы строят обучающие цели через самосогласованность (self-consistency) или мажоритарное голосование, из-за чего обучение зависит от неуверенных предсказаний самой модели.
A-RSI разделяет эти два вопроса. Динамика обучения определяет, когда получать новый опыт, а ответы на новые задачи остаются независимо проверяемыми. Для первого метод отслеживает в логах обучения разброс награды (reward variation) и точность и обновляет пул задач, когда обучающий сигнал ослабевает. Валидационные и тестовые оценки при этом не используются.
Для второго статичная библиотека программ, написанных самой моделью, порождает мультимодальные вопросы и вычисляет для них эталонные ответы. Авторы задают контракт генерации задач, автоматически проверяют выбранные свойства правил награды и обновления, а сгенерированные ответы отдельно аудируют. В цикле обучения нет внешних обучающих примеров и ответов, размеченных людьми.
Главный результат: на основном наборе из одиннадцати бенчмарков A-RSI поднимает среднее значение показателя (performance average) с 57,77 до 61,05 при использовании 800 свежих задач.
Ключевые факты
- A-RSI, метод мультимодального самоулучшения без внешних обучающих примеров и размеченных людьми ответов.
- Метод следит за разбросом награды и точностью в логах обучения и обновляет пул задач, когда обучающий сигнал падает; валидационные и тестовые оценки не используются.
- Вопросы и эталонные ответы порождает статичная библиотека программ, написанных самой моделью; ответы отдельно аудируются, а свойства правил награды и обновления проверяются автоматически.
- На основном наборе из одиннадцати бенчмарков среднее значение выросло с 57,77 до 61,05 при 800 свежих задачах.
Почему это важно
Самоулучшение моделей без человеческой разметки упирается в два вопроса: какие задачи создавать и когда их менять. Авторы отмечают, что обычно внимание уделяют первому, а A-RSI делает акцент на втором и привязывает момент обновления к сигналам самого обучения. Заодно метод пытается уйти от целей, зависящих от собственных неуверенных предсказаний модели (мажоритарное голосование, самосогласованность).
Кому это важно
Исследователям, которые занимаются самообучением мультимодальных моделей и синтетическими данными для обучения с подкреплением. Тем, кого интересует, как без разметки получать проверяемые ответы и как выбирать момент обновления набора задач.
Как это применить
Из предоставленного описания не видно ни кода, ни ссылки на выпуск, поэтому практическое применение пока ограничено идеей: следить за разбросом награды и точностью в логах и обновлять пул задач, когда сигнал слабеет, а ответы на новые задачи вычислять программно и отдельно проверять.
Можно ли доверять
Это препринт на Hugging Face Papers, и все утверждения принадлежат его авторам. Цифры (57,77 → 61,05 на одиннадцати бенчмарках с 800 свежими задачами) приведены без уточнения, среднее это или медиана, и без сведений о том, с чем именно сравнивается базовый показатель. Названия бенчмарков, базовая модель, объём вычислений, сравнения с другими методами и результаты аудита ответов в тексте не указаны, поэтому оценить масштаб прироста по одной аннотации трудно.
Риски и подводные камни
Прирост в 3,28 пункта среднего показателя нужно читать с оговорками: неизвестны состав бенчмарков и базовая модель. Качество зависит от программ, которые пишет сама модель, поэтому ошибки в них могут давать неверные эталонные ответы; авторы закладывают отдельный аудит, но его результаты в описании не приведены. Метод опирается на логи обучения, и его поведение вне заявленного набора бенчмарков неизвестно.