World-in-Context: модель с 5 млрд параметров сравнялась в навигации с 22-миллиардной EchoWM
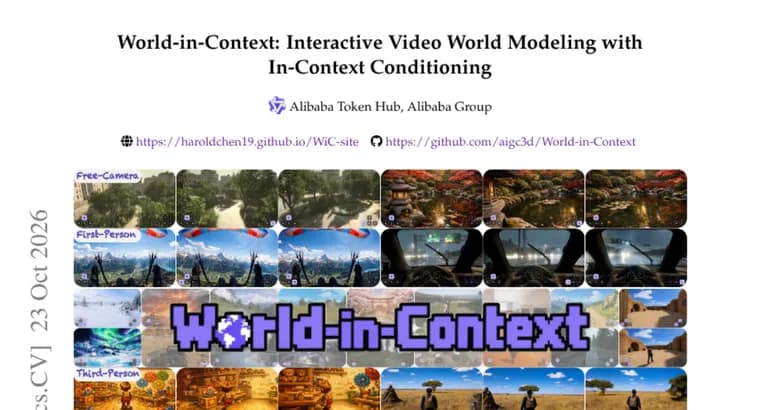
Интерактивным видеомоделям мира нужно согласованно управлять тремя вещами: ракурсом обзора, действиями персонажа и движением камеры. Авторы препринта World-in-Context утверждают, что существующие методы обычно оставляют режимы обзора неявными в текстовых описаниях, смешивают действие с движением камеры и подают управляющие сигналы через разрозненные архитектурные каналы, которые учитывают взаимосвязи лишь косвенно.
В ответ авторы представляют World-in-Context, фреймворк интерактивного моделирования мира на основе In-Context Conditioning (ICC, условия через контекст). Вместо специальных каналов условий он превращает управление ракурсом, действием и камерой в явные токены, которые обрабатываются прямо в общем пространстве self-attention (самовнимания).
По словам авторов, такая постановка показывает две вещи. Во-первых, явные токены ракурса разделяют конфликтующие динамики и позволяют переключать ракурс, хотя обучение шло на данных с одним ракурсом. Во-вторых, действие и камера играют взаимодополняющие роли: действие отвечает за локальную отзывчивость, камера, за глобальную устойчивость.
Чтобы сохранить временную непрерывность между интервалами исполнения, авторы добавили Interaction-Transport RoPE (IT-RoPE). Он параметризует временное внимание накопленными переходами управляющих сигналов.
На бенчмарке WBench модель World-in-Context-5B показывает в навигации результат на уровне 22-миллиардной EchoWM: 81,5 против 81,6. Успешность переключения перспективы у неё составляет 93,8%, тогда как у существующих базовых моделей на 5 млрд параметров, 18,8%. Кроме того, контролируемые анализы, по утверждению авторов, показывают растущее преимущество подхода при более богатых смесях условий, выгодную эффективность по данным и естественную применимость к причинным (causal) прокруткам генерации.
Ключевые факты
- World-in-Context сводит управление ракурсом, действием и камерой к явным токенам в общем пространстве self-attention вместо отдельных каналов условий (подход In-Context Conditioning).
- На WBench модель на 5 млрд параметров набрала в навигации 81,5 против 81,6 у 22-миллиардной EchoWM.
- Успешность переключения перспективы, 93,8% против 18,8% у существующих базовых моделей на 5 млрд параметров.
- Явные токены ракурса, по словам авторов, позволяют переключать ракурс, обучаясь на данных с одним ракурсом; действие отвечает за локальную отзывчивость, камера, за глобальную устойчивость.
- Interaction-Transport RoPE (IT-RoPE) поддерживает временную непрерывность за счёт накопленных переходов управляющих сигналов.
Почему это важно
Интерактивные видеомодели мира должны одновременно слушаться ракурса, действий и камеры. По утверждению авторов, нынешние подходы смешивают эти сигналы и подают их через разрозненные пути. Работа предлагает единый механизм и заявляет, что модель в 5 млрд параметров по навигации почти не уступает модели в 22 млрд на одном бенчмарке.
Кому это важно
Исследователям видеогенерации и моделей мира, а также тем, кто строит управляемые интерактивные сцены. Для них интересны идея явных токенов управления и заявленная эффективность по данным.
Как это применить
Прямого применения в источнике не описано: это препринт с описанием метода. Выпуск кода, весов или данных в тексте не упомянут. Практически полезно взять как идею: подавать ракурс, действие и камеру как отдельные токены в общий контекст внимания.
Можно ли доверять
Все цифры, результаты самих авторов на бенчмарке WBench, независимой проверки в тексте нет. Источник, только аннотация; авторы и организации в ней не названы. Единица измерения навигационной оценки не указана. Цифра 18,8% относится к существующим 5-миллиардным базовым моделям в целом, отдельные модели не названы.
Риски и подводные камни
Навигационный результат 81,5 чуть ниже 81,6 у EchoWM: речь о паритете, а не о превосходстве. Результат EchoWM в переключении перспективы не приведён, поэтому сравнение по этой метрике возможно только с 5-миллиардными базовыми моделями. Объём обучающих данных, вычисления и скорость вывода в источнике не указаны, а утверждения о способности переключать ракурс по данным с одним ракурсом и о причинных прокрутках даны без количественных деталей.