Wagtail провалила месяц на GLM 5.3 Flash: на модель ушла половина токенов
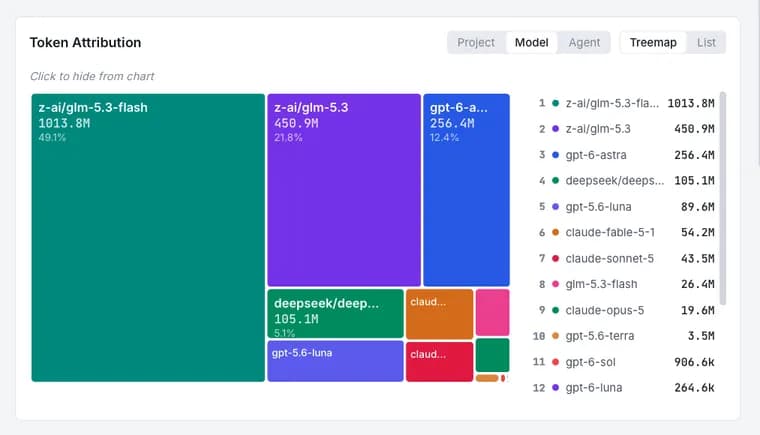
Команда Wagtail поставила себе челлендж: потратить весь сентябрь на одну эффективную открытую модель, GLM 5.3 Flash. По итогам, пишут авторы блога, затея не удалась. Всего за месяц ушло около 2 млрд токенов, и только 1 млрд из них (50%) пришёлся на целевую модель. Распределение токенов команда смотрела через AgentsView, один из инструментов, которые она рекомендует для контроля использования ИИ.
Первая половина месяца прошла по плану: всё тратилось только на GLM 5.3 Flash. Расход на эту модель уложился в бюджет: $68, около 4 кВт·ч энергии и 365 граммов выбросов углерода. Вторая половина оказалась хуже: 1 млрд токенов ушёл на другие модели. Авторы называют три причины.
Первая, «цена вайб-кодинга». Экспериментальный сервер Wagtail MCP, по словам команды, заведомо прототип, написанный в стиле vibe coding. Для прототипа это уместно, но последствия были: автор выбрал для него «неправильную» модель (какую именно, в тексте не сказано), и почти за одну ночь ушло 450 млн токенов, $150 и 5 кВт·ч энергии. Сервер при этом работает хорошо, и теперь есть наглядная демонстрация возможностей, так что траты были не зря. Но, по оценке авторов, похожий результат можно было получить «скорее всего» в 5 раз дешевле и без особых дополнительных усилий. Вывод: нужно закладывать такие траты в бюджет и аккуратнее выбирать модель и агентные схемы.
Вторая причина, проблемы с инфраструктурой. Провайдеры инференса, которых выбрала команда, обычно работают нормально, но очень популярны и не обладают такой ёмкостью, как крупные лаборатории, «копящие все GPU». Команда заметила деградацию именно у GLM 5.3 Flash, «скорее всего» потому, что эта модель находится высоко на парето-фронте среди релевантных для их работы моделей. Пришлось переключаться на похожие DeepSeek V4.1 Flash и Qwen 3.8 Flash; сделать это просто, но неожиданно.
Третья причина, эксперименты и исследования. Помимо повседневной разработки на одной модели команде было важно пробовать широкий круг моделей и следить за новыми релизами. Это особенно нужно потому, что Wagtail начинает замерять качество моделей на своих задачах, а для этого нужны данные по многим моделям. Авторы показали «краткий взгляд» на бенчмарк (в тексте только картинка) и говорят, что с такими данными проще направлять людей к более экономным вариантам, а сами варианты можно сделать ещё удобнее с помощью навыков для агентов и нового прототипа CLI, рассчитанного на работу с агентами.
Итог: технически челлендж провален, на целевую модель пришлось 50% использования (1 млрд из 2 млрд токенов), а энергии ушло около 35 кВт·ч вместо запланированных 10. Но команда считает, что многому научилась. Для октября она назвала четыре условия успеха: постоянное локальное измерение не только токенов, но и энергии и затрат, а в идеале ещё и пользы результата; отдельный бюджет на эксперименты и более осознанный выбор того, какие прототипы стоит строить; лучший подбор промптов и мультиагентные приёмы (оркестратор, разведчик, исполнитель, ревьюер, ограниченные цели); и дальнейшее движение к более эффективным техникам и моделям. Диффузионные модели решений в стиле Jev авторы называют очень многообещающими, если они действительно так эффективны, а последние флагманские модели, по их мнению, тоже шаг в нужную сторону.
Главный практический тезис: для повседневной работы разработчика вполне реально сосредоточиться на одной-двух дешёвых моделях уровня flash. Реалистичная цель, по мнению авторов, «вероятно», в том, чтобы большая часть ИИ-инференса выполнялась такими эффективными моделями, причём измерять её нужно в деньгах или энергии, а не в «бессмысленных токенах». Это и есть цель на октябрь. О результатах команда обещает рассказать на Wagtail Space 2026 в ноябре.
Ключевые факты
- Челлендж Wagtail на сентябрь: работать только на GLM 5.3 Flash. Итог: из около 2 млрд токенов на неё пришёлся 1 млрд (50%), авторы называют результат технической неудачей.
- Расход на GLM 5.3 Flash уложился в бюджет: $68, около 4 кВт·ч и 365 г выбросов углерода; общее потребление энергии составило около 35 кВт·ч вместо запланированных 10.
- Прототип сервера Wagtail MCP на «неправильной» модели съел 450 млн токенов, $150 и 5 кВт·ч почти за одну ночь; авторы считают, что «скорее всего» можно было обойтись в 5 раз дешевле.
- Из-за нехватки ёмкости у провайдеров и деградации GLM 5.3 Flash команда переключалась на DeepSeek V4.1 Flash и Qwen 3.8 Flash.
- Вывод и цель на октябрь: для повседневной разработки достаточно одной-двух дешёвых flash-моделей, а основную часть инференса измерять в деньгах и энергии, а не в токенах.
Почему это важно
Это редкий открытый отчёт команды разработчиков о том, как на практике выглядит попытка сидеть на одной недорогой открытой модели. Конкретные цифры по токенам, деньгам и энергии показывают, где именно уходит бюджет: не на основную модель, а на неудачный выбор для прототипа, перебои у провайдеров и эксперименты. Авторы предлагают мерить использование ИИ в стоимости и энергии, а не в токенах.
Кому это важно
Командам, которые строят разработку на ИИ-агентах и считают расходы на токены и инференс, а также тем, кто выбирает между недорогими открытыми моделями и флагманами. Полезно и тем, кто планирует прототипы с агентами вроде MCP-серверов: пример показывает, как быстро растут траты.
Как это применить
Из текста следуют конкретные шаги, которые сама команда планирует на октябрь: постоянно измерять локально токены, энергию и затраты, а в идеале и результат; закладывать в бюджет отдельную статью на эксперименты; решать заранее, какие прототипы стоит строить и как; подбирать промпты и разделять роли агентов (оркестратор, разведчик, исполнитель, ревьюер) с ограниченными целями. Для учёта токенов авторы упоминают AgentsView. Сами они считают, что для повседневных задач вполне реально остановиться на одной-двух дешёвых flash-моделях.
Можно ли доверять
Это блог самой команды Wagtail, написанный от первого лица; отдельного автора в тексте не названо. Цифры приведены самими авторами и источником вне текста не проверяются; текст опирается на их собственные замеры через AgentsView. Ряд причин подан с оговоркой «скорее всего» (оценка экономии в 5 раз, причина деградации GLM 5.3 Flash). Названий провайдеров и модели для прототипа MCP в тексте нет, по бенчмарку цифр нет, только картинка.
Риски и подводные камни
Выводы основаны на опыте одной команды за один месяц и на её конкретных задачах, поэтому переносить их на другие проекты стоит осторожно. Деградация GLM 5.3 Flash объяснена лишь предположением, а нехватка мощностей у провайдеров может повториться у любой популярной модели. Самый заметный риск из самого текста: неудачный выбор модели и агентной схемы для прототипа за одну ночь съел 450 млн токенов и $150, поэтому без учёта расходов и бюджета на эксперименты бюджет легко выйдет из-под контроля.
«Так что технически этот челлендж был провалом.»
— команда Wagtail, блог wagtail.org