Vision-RL2 обучает MLLM искать нужную область на снимке и сокращает токены в 4 раза
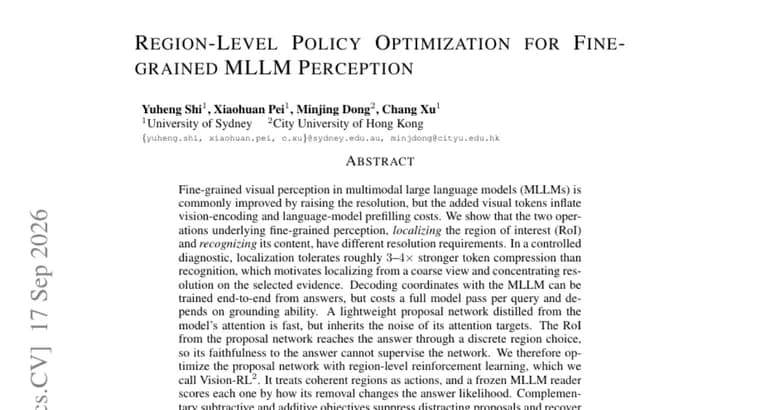
Исследователи предложили метод Vision-RL2, способ обучения мультимодальных языковых моделей (MLLM) точнее распознавать мелкие детали на изображении при меньшем числе визуальных токенов.
Проблема в том, что для распознавания мелких деталей обычно повышают разрешение картинки, но это раздувает число визуальных токенов и удорожает как кодирование изображения, так и предсказание текста (prefilling) языковой моделью.
Авторы показали в контролируемом эксперименте, что задача разбивается на две разные операции: сначала нужно найти нужный участок изображения (регион интереса, RoI), а затем распознать, что на нём. Эти операции по-разному переносят сжатие токенов: локализация выдерживает примерно в 3, 4 раза более сильное сжатие токенов, чем распознавание. Отсюда идея, искать нужный участок по грубому, малодетальному изображению, а высокое разрешение тратить только на уже найденный участок.
Раньше координаты региона либо обучали сквозно по ответам модели (end-to-end), но это требует полного прохода модели на каждый запрос и зависит от способности модели привязывать текст к изображению (grounding); либо использовали лёгкую сеть-предсказатель, дистиллированную из карт внимания самой модели, она быстрая, но наследует шум этого внимания. Сложность в том, что выбор региона дискретный: сеть выбирает одну область из множества, и то, насколько этот выбор повлиял на итоговый ответ, нельзя напрямую использовать как сигнал для обучения самой сети.
Поэтому авторы предложили обучать сеть-предсказатель регионов через обучение с подкреплением на уровне регионов, метод назвали Vision-RL2. В нём связные области изображения рассматриваются как действия, а замороженная (необучаемая) MLLM-модель оценивает каждую область по тому, как её удаление меняет вероятность правильного ответа. Обучение сочетает две дополняющие друг друга цели: одна подавляет области, отвлекающие модель от сути, другая, восстанавливает недостающие, но нужные для ответа области. Обучается только сама сеть-предсказатель, без ручной разметки регионов, без сэмплирования ответов и без построения цепочек рассуждений. Найденный таким способом регион затем позволяет применить разреженное кодирование: детально кодируется только сама область с нужными деталями, а фоновые токены отбрасываются.
На шести тестовых бенчмарках для мелкой детализации и на четырёх разных базовых MLLM-моделях Vision-RL2 повышает точность по сравнению с базовой моделью при любом бюджете токенов, а при примерно в 4 раза меньшем числе визуальных токенов превосходит точность базовой модели даже на её максимальном бюджете токенов. Код метода опубликован в открытом доступе на GitHub (репозиторий YuHengsss/VisionRL2).
Ключевые факты
- Локализация нужного участка изображения и распознавание того, что на нём, разные операции: локализация выдерживает примерно в 3, 4 раза более сильное сжатие визуальных токенов, чем распознавание.
- Vision-RL2 обучает лёгкую сеть-предсказатель регионов через обучение с подкреплением на уровне регионов, без ручной разметки, сэмплирования ответов и цепочек рассуждений.
- Замороженная MLLM-модель оценивает каждую область по тому, как её удаление меняет вероятность правильного ответа; одна цель обучения подавляет отвлекающие области, другая, восстанавливает недостающие.
- На шести бенчмарках мелкой детализации и четырёх базовых MLLM-моделях метод повышает точность при любом бюджете токенов и превосходит базовую модель при примерно 4-кратном сокращении визуальных токенов.
- Код метода выложен в открытый доступ на GitHub.
Почему это важно
Рост разрешения картинки, стандартный способ научить модель различать мелкие детали, но он напрямую раздувает число визуальных токенов, а значит и стоимость кодирования изображения, и стоимость предсказания текста моделью. Vision-RL2 показывает, что часть этой цены, от того, что localization (поиск области) и recognition (распознавание содержимого) на самом деле требуют разного разрешения, и их можно развести: смотреть на всю картину грубо, а детально, только на найденный участок. Это даёт прежнюю или более высокую точность при заметно меньшем бюджете токенов.
Кому это важно
Разработчикам и исследователям, которые строят или дообучают MLLM (мультимодальные модели, работающие с изображением и текстом) для задач, где важны мелкие детали: визуальные вопрос-ответ по частям изображения, чтение мелкого текста и документов, разбор диаграмм и схем. Также инженерам, которые упираются в бюджет визуальных токенов при инференсе и ищут способ снизить его без потери качества.
Как это применить
Метод оформлен как отдельно обучаемая лёгкая сеть-предсказатель региона интереса, которую можно встроить перед основной MLLM: сеть выбирает нужный участок изображения, после чего модель кодирует его с высоким разрешением, а остальной кадр, разреженно, экономя токены. Авторы опубликовали код на GitHub (репозиторий YuHengsss/VisionRL2), что позволяет воспроизвести обучение и попробовать метод на своих моделях и бенчмарках.
Можно ли доверять
Материал, препринт с полным описанием метода и постановки эксперимента (не пресс-релиз и не пересказ третьих лиц). Заявленные результаты, на шести бенчмарках и четырёх разных базовых MLLM-моделях, что говорит о попытке проверить метод не на одной конфигурации. При этом в самом тексте источника нет ни имён и принадлежности авторов, ни точных цифр точности в процентных пунктах, только сравнение по бюджету токенов, и нет данных об объёме обучающих данных или вычислений. Это заявления самих авторов препринта, независимой проверки результатов на момент публикации нет.
Риски и подводные камни
Качество работы всей схемы зависит от двух звеньев: самой сети-предсказателя региона и того, насколько адекватно замороженная MLLM-«судья» оценивает влияние региона на ответ, ошибка в любом из них может увести локализацию не туда. Результаты получены на конкретных тестовых бенчмарках; как метод поведёт себя на реальных, более разнородных изображениях и задачах, из текста не следует. Точные числовые показатели прироста точности (в процентных пунктах) источник не приводит, только относительное сравнение по числу токенов, так что судить о масштабе улучшения в абсолютных цифрах преждевременно.