Video-Point Model (VPM): мировая модель предсказывает видео и 3D-траектории точек
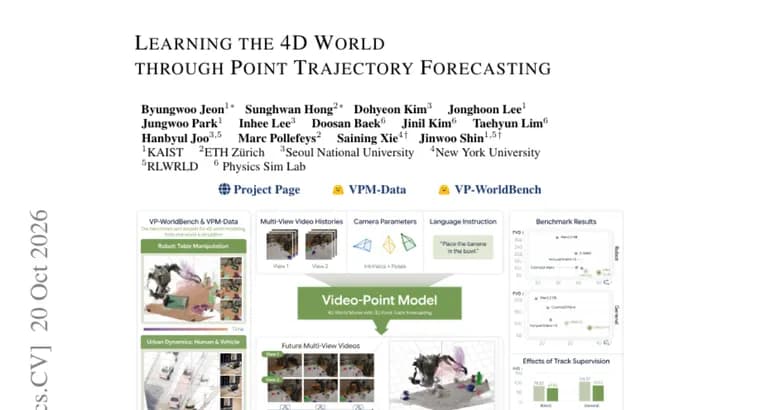
В работе, опубликованной на Hugging Face, представлена Video-Point Model (VPM), мировая модель (world model), которая принимает историю видео с нескольких камер и языковую инструкцию. На выходе она совместно прогнозирует будущие видео с произвольных ракурсов и трёхмерные траектории устойчивых точек сцены.
Исходная проблема: надёжный многоракурсный прогноз требует, чтобы видео с разных камер описывали одну и ту же развивающуюся 3D-сцену. Для этого предобученную мировую модель дополнили обработкой нескольких ракурсов с учётом положения камер, которая объединяет взаимодополняющие наблюдения разных камер, и добавили «траекторную голову», выходной блок, предсказывающий, как физические точки движутся во времени. Каждая траектория отслеживает одну точку сразу во всех ракурсах, поэтому обучение на траекториях вместе с генерацией видео привязывает изменения внешнего вида в каждой камере к общему описанию трёхмерного движения.
Для обучения и проверки созданы два ресурса: VPM-Data, симуляционный корпус, в котором синхронные видео с нескольких камер сопоставлены с устойчивыми траекториями точек, и VP-WorldBench, бенчмарк для прогнозирования, охватывающий симулируемые и реальные среды.
Кроме того, VPM расширили до управления роботом: действия робота добавлены в генератор как ещё одна модальность токенов. Токены действий используют общую основу (backbone), обученную с учётом точек, и очищаются от шума (denoising) вместе с будущими видео, так что политика управления опирается на то же 3D-осведомлённое представление.
Результаты: на VP-WorldBench и существующих бенчмарках 4D-генерации обучение с учётом точек улучшает и качество видео, и точность 3D-движения по сравнению с аналогом, обучаемым только на видео. В экспериментах в симуляции и с реальными роботами оно также повышает долю успешных манипуляций у модели с действиями.
Ключевые факты
- VPM по истории многоракурсного видео и языковой инструкции совместно прогнозирует будущие видео с произвольных ракурсов и 3D-траектории устойчивых точек сцены.
- Предобученную мировую модель расширили обработкой нескольких камер и траекторной головой; одна траектория отслеживает одну точку во всех ракурсах и связывает картинки разных камер общим описанием 3D-движения.
- Созданы симуляционный корпус VPM-Data (синхронные видео с траекториями точек) и бенчмарк VP-WorldBench (симулируемые и реальные среды).
- Для управления роботом в генератор добавлены токены действий, которые обрабатываются вместе с будущими видео на общей основе, обученной с учётом точек.
- Обучение с учётом точек улучшает качество видео и точность 3D-движения относительно варианта только на видео и повышает успешность манипуляций в симуляции и на реальных роботах.
Почему это важно
Мировые модели, прогнозирующие видео, плохо справляются с согласованностью: разные камеры должны показывать одну и ту же трёхмерную сцену. Идея работы, добавить явную опору на траектории физических точек, общие для всех ракурсов. По заявлению авторов, это улучшает и визуальное качество, и точность трёхмерного движения, а затем помогает при управлении роботом.
Кому это важно
Исследователям мировых моделей и 4D-генерации видео, а также специалистам по обучению роботов манипуляциям, которым нужны представления с пониманием 3D. Корпус VPM-Data и бенчмарк VP-WorldBench могут пригодиться тем, кто сравнивает многоракурсные прогнозы.
Как это применить
Практический вывод в виде идеи: к генерации видео можно добавить вспомогательную задачу предсказания траекторий точек, а для роботов, подмешать токены действий в ту же модель. Сведений о выпуске кода, весов или данных в описании работы нет, поэтому повторить подход на готовых материалах пока не получится.
Можно ли доверять
Все выводы взяты из аннотации работы, то есть это заявления самих авторов. В аннотации не приведены числовые результаты, не названы базовая предобученная мировая модель, конкретные бенчмарки 4D-генерации и роботизированные платформы; единственный указанный аналог для сравнения, вариант той же модели только на видео. Оценить величину улучшения по тексту нельзя.
Риски и подводные камни
Корпус VPM-Data симуляционный, поэтому перенос на реальные сцены зависит от того, насколько хорошо модель обобщается; реальные среды в оценке присутствуют (бенчмарк и эксперименты с реальными роботами), но подробностей нет. Без чисел и сравнения с другими опубликованными моделями нельзя понять, насколько заметен выигрыш от точечной разметки.
«Каждая траектория отслеживает одну точку во всех ракурсах, поэтому обучение на этих траекториях вместе с генерацией видео привязывает изменения внешнего вида в каждой камере к общему описанию трёхмерного движения.»
— Из аннотации работы о Video-Point Model