VibeVideoBench: бенчмарк проверил ИИ-агентов, которые делают видео кодом
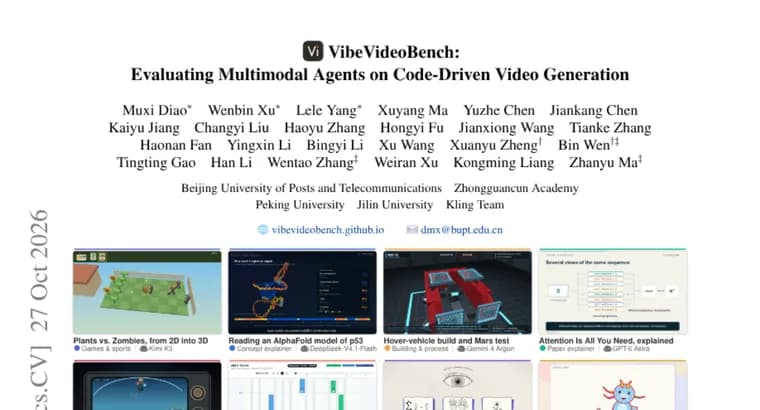
Авторы статьи отталкиваются от ограничения диффузионных видеомоделей: они выдают эффектные клипы, но не умеют надёжно рисовать точную формулу, правильную диаграмму, игру с соблюдением правил или озвучку, синхронизированную с событиями на экране. Альтернативой они называют мультимодальных агентов, которые пишут код, отрисовывающий каждый кадр и синтезирующий каждый звук. Для оценки таких агентов и создан бенчмарк VibeVideoBench.
В нём 239 самодостаточных задач на английском и китайском языках, разбитых на 12 категорий: от «историй на данных» и музыкальных роликов до школьных уроков и разборов научных статей. Агент работает в собственной штатной обвязке (native harness) внутри песочницы, где нет ни одной модели генерации изображений или видео, и за один час должен выдать готовый MP4-файл со звуком.
Оценка многоуровневая и опирается на доказательства. Сначала программные проверки соответствия требованиям к сдаче. Затем около 13 тысяч проверок по критериям, составленным под конкретные задачи и привязанным к требованиям, которые они контролируют. Наконец, пять измерений качества, заданных для каждой задачи и оцениваемых тремя панелями судей на базе визуально-языковых моделей (VLM).
Тестировали девять передовых агентных систем, всего 2151 оценённый прогон. Первое и второе места заняли GPT-6 Astra и Claude Opus 5.5, и по оценке судей, и по оценке живых аннотаторов. Сильнейшая система выполняет все ключевые требования в 76,3% задач.
Отдельная ось, доставка результата. Если считать отсутствующие видео нулями, рейтинг меняется. Три четверти потерянных роликов, это финальные рендеры, которые начались слишком поздно, шли слишком медленно или так и не запустились; авторы называют это провалом в планировании агентами своего часа. Агенты сами строят конвейеры рендеринга и просматривают собственные кадры, но то, насколько много они смотрят, качество не предсказывает. Рейтинг систем по судьям близко совпадает со слепыми предпочтениями людей.
Ключевые факты
- VibeVideoBench: 239 задач на английском и китайском, 12 категорий (от историй на данных и музыкальных роликов до уроков и разборов статей); задача, за час выдать готовый MP4 со звуком.
- Агенты работают в песочнице без моделей генерации изображений и видео: каждый кадр и звук должны получаться из кода.
- Оценка: программные проверки, около 13 тысяч проверок под конкретные задачи и пять измерений качества, которые оценивают три панели VLM-судей.
- Из девяти систем и 2151 прогона первое и второе места заняли GPT-6 Astra и Claude Opus 5.5; сильнейшая система выполняет все ключевые требования в 76,3% задач.
- Если считать отсутствующие видео нулями, рейтинг меняется; три четверти потерь, финальные рендеры, начатые слишком поздно, медленные или незапущенные.
Почему это важно
Диффузионные видеомодели дают красивые клипы, но не справляются с задачами, где нужна точность: формулы, диаграммы, игры с правилами, озвучка в такт происходящему. Код-ориентированный путь, агент пишет программу, которая рисует и озвучивает ролик, по замыслу авторов решает именно такие задачи. VibeVideoBench даёт для этого направления общий способ измерения: 239 задач, многоуровневые проверки и сопоставление с оценками людей.
Кому это важно
Разработчикам и исследователям агентных систем, которые хотят сравнивать модели на длинных задачах с реальным конечным артефактом. Также тем, кто делает образовательные ролики, визуализации данных и объясняющие видео и присматривается к автоматизации этой работы через код.
Как это применить
Главный практический вывод касается планирования времени. Основная причина потерь, не плохое качество, а то, что финальный рендер начался слишком поздно, шёл слишком медленно или не запустился вовсе, поэтому при построении агентов для длинных задач стоит заранее закладывать запас времени на сборку результата. Кроме того, частота просмотра собственных кадров, по данным статьи, не предсказывает качество. Дата выхода, ссылка на код и доступность набора данных в тексте аннотации не указаны.
Можно ли доверять
Это описание бенчмарка из аннотации статьи на Hugging Face, поэтому все заявления, слова самих авторов. Авторы и их организации в тексте не названы, остальные семь из девяти систем и три VLM-судьи не перечислены, баллы по системам не приведены. Цифра 76,3% относится только к сильнейшей системе, и в тексте не сказано, какая это система. Утверждение о близком совпадении рейтинга судей со слепыми предпочтениями людей даёт уверенность в методике, но подробности в тексте не раскрыты.
Риски и подводные камни
Бенчмарк задаёт жёсткие условия: один час, песочница без моделей генерации изображений и видео, штатная обвязка каждой системы, результат отражает связку «модель плюс обвязка», а не модель саму по себе. Автоматические судьи, это VLM, и хотя их рейтинг близок к человеческому, на уровне отдельных роликов оценки могут расходиться. Размер изменения рейтинга при учёте отсутствующих видео как нулей в тексте не указан, поэтому оценить его влияние нельзя.