Velox ускорила видео-модели мира: внимание быстрее в 4,36 раза без дообучения
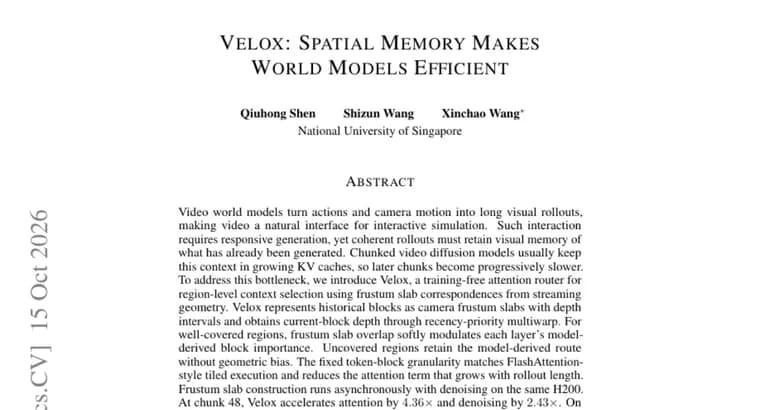
Видео-модели мира превращают действия и движения камеры в длинные визуальные последовательности, то есть видео становится интерфейсом для интерактивной симуляции. Такой режим требует быстрой генерации, но при этом модель должна помнить уже созданное. Модели покадровой (по фрагментам) видео-диффузии обычно хранят этот контекст в растущем KV-кэше, поэтому каждый следующий фрагмент генерируется всё медленнее.
Авторы предлагают Velox, маршрутизатор внимания, не требующий дообучения. Он выбирает контекст на уровне областей кадра, опираясь на соответствия «срезов усечённой пирамиды обзора камеры» (frustum slabs), полученные из потоковой геометрии. Прошлые блоки представлены как такие срезы с интервалами глубины, а глубину текущего блока получают методом multiwarp с приоритетом свежих данных.
Для хорошо покрытых областей пересечение срезов мягко корректирует важность блоков, которую модель вычисляет на каждом слое сама. Непокрытые области сохраняют маршрут, выбранный моделью, без геометрической поправки. Фиксированный размер блоков токенов согласуется с плиточным исполнением в духе FlashAttention и сокращает ту часть вычислений внимания, которая растёт с длиной генерации. Построение срезов идёт асинхронно с шумоподавлением на том же H200.
Результаты: на 48-м фрагменте Velox ускоряет внимание в 4,36 раза, а шумоподавление, в 2,43 раза. На полном навигационном наборе WBench из 158 случаев метод остаётся в пределах 0,15 среднего балла (без обращения к API) от плотного базового варианта LingBot-Fast-Cam. Подробности авторы вынесли на страницу проекта.
Ключевые факты
- Velox, маршрутизатор внимания для видео-моделей мира, не требующий дообучения: выбирает контекст по областям кадра вместо обращения ко всему растущему KV-кэшу.
- На 48-м фрагменте внимание ускоряется в 4,36 раза, шумоподавление, в 2,43 раза.
- На полном навигационном наборе WBench (158 случаев) результат в пределах 0,15 среднего балла без API от плотного LingBot-Fast-Cam.
- Геометрическая поправка применяется только к хорошо покрытым областям; остальные идут по маршруту, выбранному самой моделью.
- Построение геометрических срезов идёт асинхронно с шумоподавлением на одном H200.
Почему это важно
Интерактивные видео-модели мира упираются в простую проблему: чем длиннее генерация, тем больше кэш контекста и тем медленнее каждый новый фрагмент. Velox атакует это узкое место, заменяя «смотреть на всё» выбором релевантных областей по геометрии сцены. Ускорение внимания в 4,36 раза и шумоподавления в 2,43 раза на 48-м фрагменте показывает, что память о пространстве можно использовать как способ экономии вычислений.
Кому это важно
Исследователям и инженерам, которые работают с видео-диффузией и моделями мира для интерактивной симуляции, а также тем, кто оптимизирует вывод таких моделей и внимание в длинных последовательностях.
Как это применить
Метод не требует дообучения, то есть теоретически накладывается на уже обученную модель; в статье он проверен на сравнении с плотным LingBot-Fast-Cam. Детали реализации авторы отсылают на страницу проекта (velox-world.com/velox). Блочная гранулярность рассчитана на плиточное исполнение в стиле FlashAttention.
Можно ли доверять
Это аннотация научной работы: цифры заявлены самими авторами, независимой проверки в тексте нет. Результаты скорости приведены только для 48-го фрагмента, а качество, по одному навигационному набору WBench из 158 случаев. Абсолютные баллы базового варианта в аннотации не названы, указано лишь, что разрыв не больше 0,15 среднего балла.
Риски и подводные камни
Ускорение показано в одной точке (фрагмент 48) и на одном H200; как оно меняется при других длинах генерации и на другом оборудовании, по аннотации неясно. Метод зависит от потоковой геометрии и оценки глубины, а в непокрытых областях геометрической поправки нет. Качество проверено на одном наборе, так что перенос на другие сценарии нужно проверять отдельно.