Vela превращает записи поведения 100 000 пользователей в обучение LLM
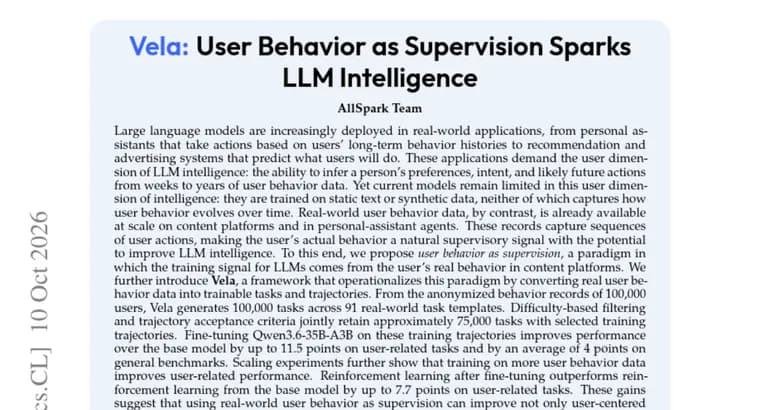
В препринте предложена идея «поведение пользователей как обучающий сигнал» и представлена система Vela. Это фреймворк, который превращает реальные записи о действиях пользователей в обучаемые задачи и траектории (последовательности шагов для обучения).
Исходная мысль авторов такая: языковые модели всё чаще работают с долгой историей поведения человека, в персональных ассистентах, рекомендательных и рекламных системах. Для этого нужна «пользовательская» сторона интеллекта: по данным за недели и годы выводить предпочтения, намерения и вероятные будущие действия человека. Но современные модели учат на статичном тексте или синтетических данных, а те не отражают, как поведение пользователя меняется со временем. Записи реального поведения, которые уже есть в большом объёме на контентных платформах и в агентах-ассистентах, авторы считают естественным обучающим сигналом.
Как это устроено в цифрах. Vela берёт анонимизированные записи поведения 100 000 пользователей и генерирует из них 100 000 задач по 91 шаблону реальных задач. Затем отбор по сложности и критерии приёмки траекторий оставляют примерно 75 000 задач с отобранными обучающими траекториями.
Результаты. Дообучение модели Qwen3.6-35B-A3B на этих траекториях улучшает её показатели относительно базовой версии до 11,5 пункта на пользовательских задачах и в среднем на 4 пункта на общих бенчмарках. Чем больше поведенческих данных в обучении, тем выше результат на пользовательских задачах. Обучение с подкреплением после дообучения обходит обучение с подкреплением, запущенное с базовой модели, до 7,7 пункта.
Вывод авторов: эти приросты говорят о том, что реальное поведение пользователей, масштабируемый источник обучающего сигнала как для пользовательских способностей, так и для общего интеллекта моделей.
Ключевые факты
- Vela превращает анонимизированные записи поведения 100 000 пользователей в 100 000 задач по 91 шаблону; после фильтрации остаётся примерно 75 000 задач с отобранными траекториями.
- Дообучение Qwen3.6-35B-A3B на этих траекториях даёт прирост до 11,5 пункта на пользовательских задачах и в среднем 4 пункта на общих бенчмарках.
- Больше поведенческих данных в обучении, выше результат на пользовательских задачах.
- Обучение с подкреплением после дообучения превосходит обучение с подкреплением от базовой модели до 7,7 пункта.
- Авторы делают осторожный вывод: поведение пользователей, по их мнению, масштабируемый источник обучающего сигнала.
Почему это важно
Модели всё чаще работают с долгой историей действий человека, в ассистентах, рекомендациях и рекламе, а обучают их на статичном тексте и синтетике. Работа предлагает другой источник сигнала: реальное поведение, которое уже накоплено на платформах. Если идея подтвердится, это новый масштабируемый путь улучшать модели как в пользовательских задачах, так и в общих.
Кому это важно
Исследователям, которые занимаются обучением языковых моделей и персонализацией, и командам, строящим ассистентов и рекомендательные системы на долгой истории пользователя. Также тем, кто следит за поиском новых источников обучающих данных помимо текста из интернета и синтетики.
Как это применить
Напрямую применять пока нечего: в аннотации не упомянут выпуск кода, данных или весов. Практический вывод, идея конвертировать поведенческие логи в задачи с шаблонами, фильтровать их по сложности и отбирать траектории по критериям приёмки, а затем дообучать модель и при желании продолжать обучением с подкреплением.
Можно ли доверять
Это препринт: приведены собственные результаты авторов, которые не проверены независимо. В аннотации не названы ни сами пользовательские задачи, ни общие бенчмарки, ни метрика, в которой измерены «пункты». Цифры 11,5 и 7,7, максимумы («до»), а не средние; средним заявлен только прирост в 4 пункта на общих бенчмарках. Сами авторы формулируют вывод осторожно: приросты «позволяют предположить», а не доказывают тезис.
Риски и подводные камни
Из аннотации неизвестно, какие платформы и ассистенты поставили записи поведения 100 000 пользователей, и как именно устроена защита данных помимо слова «анонимизированные». Использование поведения реальных людей для обучения моделей вообще требует аккуратности с приватностью. Кроме того, максимальные приросты могут не отражать типичный результат, а перенос подхода на другие модели и данные в аннотации не показан.