Векторы управления переносятся между текстом и изображениями в мультимодальных нейросетях
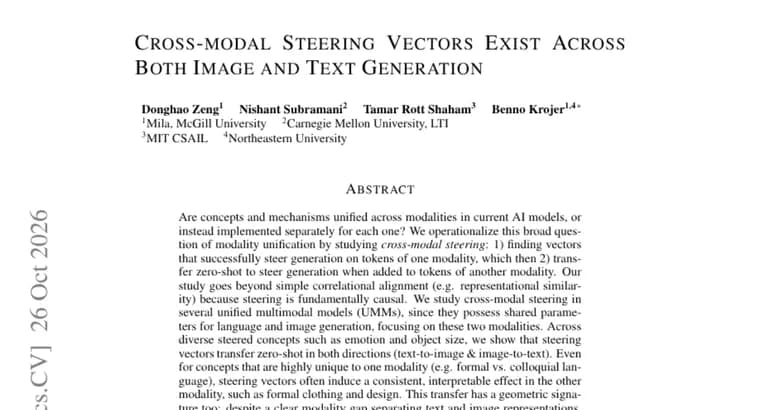
Авторы препринта задаются вопросом: общие ли у современных ИИ-моделей понятия и механизмы для разных модальностей или для каждой модальности они реализованы отдельно. Чтобы проверить это на практике, они изучают кросс-модальное управление (cross-modal steering). Сначала находят векторы, которые успешно управляют генерацией на токенах одной модальности. Затем эти векторы добавляют к токенам другой модальности и смотрят, будут ли они управлять генерацией и там, без какой-либо дополнительной настройки (zero-shot).
Исследование проведено на нескольких единых мультимодальных моделях (UMM). Их выбрали потому, что у них общие параметры для генерации языка и изображений. Внимание сосредоточено на этих двух модальностях. Авторы подчёркивают, что их подход выходит за рамки простого корреляционного сопоставления, например сравнения сходства представлений, потому что управление по своей природе причинно: вектор не просто похож, он реально меняет результат.
Главный результат: для разных управляемых понятий, таких как эмоция и размер объекта, векторы переносятся без дообучения в обе стороны, из текста в изображение и из изображения в текст. Даже для понятий, свойственных преимущественно одной модальности (например, формальный и разговорный язык), векторы часто (но не всегда) вызывают в другой модальности согласованный и интерпретируемый эффект. Так, «формальность» из текста проявляется в изображениях как формальная одежда и дизайн.
У переноса есть и геометрический признак. Хотя представления текста и изображений заметно разделены (так называемый разрыв модальностей), векторы с сильной кросс-модальной переносимостью, как правило, направлены в схожие стороны для одного и того же понятия. По мнению авторов, это проясняет, как зрение и язык взаимодействуют внутри единых мультимодальных моделей, и указывает на более общие, не зависящие от модальности подходы к управлению их поведением.
Ключевые факты
- Векторы, найденные на токенах одной модальности (текст или изображение), при добавлении к токенам другой управляют генерацией без дообучения (zero-shot).
- Перенос работает в обе стороны: из текста в изображение и из изображения в текст; проверено на понятиях вроде эмоции и размера объекта.
- Даже для понятий, специфичных для одной модальности (формальный и разговорный язык), эффект часто, но не всегда, согласованный: например, формальная одежда и дизайн на изображениях.
- Векторы с сильной переносимостью, как правило, направлены схожим образом для одного понятия, несмотря на явный разрыв между представлениями текста и изображений.
- Авторы считают метод причинным свидетельством единства модальностей, в отличие от корреляционных сравнений представлений.
Почему это важно
Вопрос, общие ли у мультимодальной нейросети понятия для текста и картинок или это отдельные механизмы, остаётся центральным для понимания таких моделей. Авторы предлагают причинную проверку: если вектор из одной модальности предсказуемо меняет результат в другой, значит, понятие в модели представлено хотя бы отчасти общим образом. Это сильнее, чем простое сходство представлений.
Кому это важно
Исследователям интерпретируемости и мультимодальных моделей, а также разработчикам, которые ищут способы управлять поведением единых моделей, генерирующих и текст, и изображения. По мнению авторов, результаты указывают на подходы к управлению, не привязанные к конкретной модальности.
Как это применить
Практический вывод, который называют авторы: управляющий вектор, найденный в одной модальности, можно попробовать применить в другой без дополнительной настройки. Например, вектор формальности, найденный на тексте, может сдвигать изображения в сторону формальной одежды и дизайна. Сведений о публикации кода, данных или моделей в доступном описании нет, поэтому воспроизведение потребует собственной реализации.
Можно ли доверять
Это препринт, представленный на Hugging Face Papers; в доступном описании нет рецензирования, количественных показателей (доли успешного переноса, размеров эффекта, базовых сравнений), перечня проверенных моделей и их числа (сказано лишь «несколько»). Утверждения о переносе осторожны: векторы «часто» дают согласованный эффект, а «сильно переносимые» векторы «как правило» схожи по направлению. Пересказ опирается только на краткое описание работы, а не на полный текст.
Риски и подводные камни
Перенос работает не для всех понятий и, судя по формулировкам, не во всех случаях: авторы говорят, что эффект проявляется «часто», но не всегда. Без цифр сложно оценить, насколько надёжен метод на практике. Результаты получены на единых мультимодальных моделях с общими параметрами для языка и изображений, поэтому переносить выводы на модели с раздельными компонентами нельзя без дополнительной проверки.
«Наши выводы проясняют, как зрение и язык взаимодействуют внутри единых мультимодальных моделей, и указывают на более общие, не зависящие от модальности подходы к управлению их поведением.»
— Авторы препринта