UMM-Reflection учит модель BAGEL исправлять свои картинки через RL
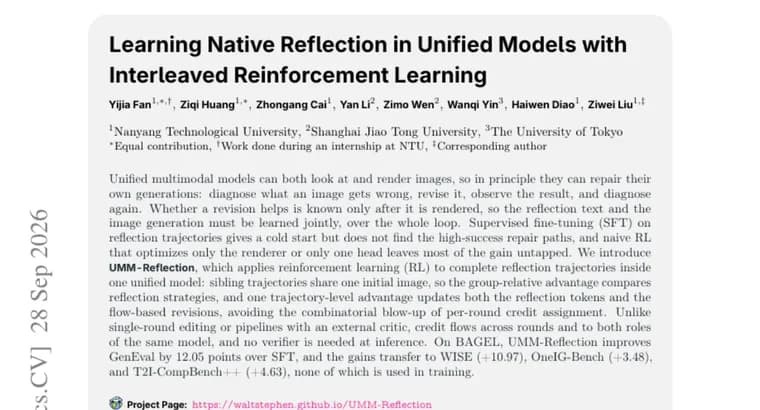
Единые мультимодальные модели умеют и разглядывать изображения, и создавать их, поэтому в принципе способны исправлять собственные генерации: определить, что на картинке не так, переделать её, посмотреть на результат и снова оценить. Авторы статьи отмечают, что польза правки становится известна только после того, как картинка нарисована, а значит текст рефлексии и генерацию изображения нужно учить совместно, на всём цикле целиком.\n\nОбычное дообучение с учителем (SFT) на траекториях рефлексии даёт лишь «холодный старт» и не находит пути исправления с высокой долей успеха. Наивное обучение с подкреплением (RL), которое оптимизирует только «рисующую» часть или только одну «голову» модели, по словам авторов, оставляет большую часть выигрыша нетронутой.\n\nПредложенный метод UMM-Reflection применяет RL к полным траекториям рефлексии внутри одной модели. Родственные траектории стартуют с одного и того же первого изображения, поэтому групповое относительное преимущество (group-relative advantage) сравнивает именно стратегии рефлексии. Одно преимущество на уровне всей траектории обновляет и токены рефлексии, и правки на основе потоковой генерации (flow-based), что позволяет избежать комбинаторного взрыва при распределении заслуг по раундам. В отличие от однораундового редактирования и конвейеров с внешним критиком, «заслуга» передаётся через раунды и обеим ролям одной и той же модели, а на этапе вывода верификатор не нужен.\n\nРезультаты приведены для BAGEL: UMM-Reflection повышает GenEval на 12,05 пункта относительно SFT. Улучшения переносятся на бенчмарки WISE (+10,97), OneIG-Bench (+3,48) и T2I-CompBench++ (+4,63), которые в обучении не использовались.
Ключевые факты
- UMM-Reflection применяет обучение с подкреплением к полным траекториям рефлексии (диагноз, правка, наблюдение, повторный диагноз) внутри одной единой мультимодальной модели.
- Одно преимущество на уровне траектории обновляет и токены рефлексии, и потоковые правки изображения; родственные траектории стартуют с общего первого изображения.
- На BAGEL GenEval вырос на 12,05 пункта относительно SFT.
- Прирост переносится на WISE (+10,97), OneIG-Bench (+3,48) и T2I-CompBench++ (+4,63), хотя эти бенчмарки в обучении не использовались.
- На этапе вывода верификатор не нужен.
Почему это важно
Идея, что модель, которая умеет и видеть, и рисовать, может сама заметить ошибки в своей картинке и исправить их, выглядит естественно, но требует совместного обучения текста рефлексии и генерации, потому что польза правки видна только после отрисовки. Работа предлагает способ учить весь цикл целиком, а не по частям. Заявленный результат: +12,05 пункта GenEval относительно SFT на BAGEL и перенос на три бенчмарка, не участвовавших в обучении.
Кому это важно
Исследователям единых мультимодальных моделей и генерации изображений, а также тем, кто занимается обучением с подкреплением для длинных многошаговых траекторий и распределением заслуг между раундами.
Как это применить
Из источника не следует готовых инструментов для практического применения: выпуск кода или моделей в тексте не упомянут. Полезная идея для разработчиков собственных систем: обновлять и текст рефлексии, и генерацию одним преимуществом на уровне траектории, а не оптимизировать только рисующую часть или только одну «голову».
Можно ли доверять
Все утверждения в тексте принадлежат авторам метода и не подтверждены независимой проверкой. Приведены только приросты, без абсолютных значений метрик. Для WISE, OneIG-Bench и T2I-CompBench++ не указаны единицы и база сравнения (только для GenEval сказано «относительно SFT»). Результаты даны лишь для BAGEL.
Риски и подводные камни
Число раундов рефлексии, размер модели, затраты на обучение и набор данных в описании не названы, поэтому оценить стоимость метода нельзя. Сравнение с конвейерами на основе внешнего критика в цифрах не приведено, а перенос на другие базовые модели не показан.