ThinkWorld: роботов учат действовать через «цепочку динамики» и воображение будущего
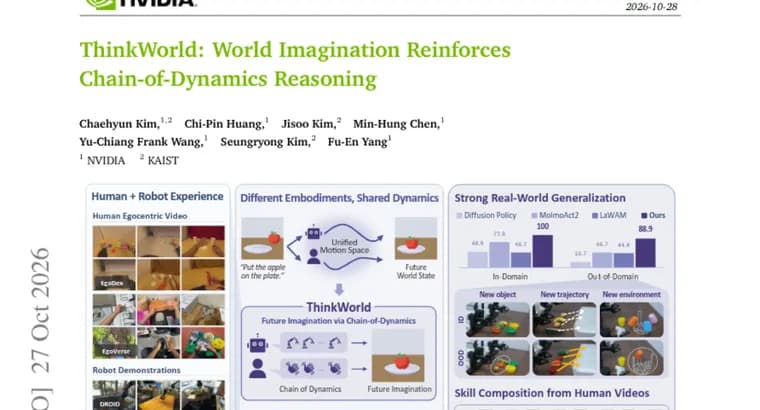
Авторы препринта исходят из проблемы: модели «зрение, язык, действие» (VLA) заметно продвинулись в роботизированных манипуляциях, но их способность обобщать ограничена разнообразием и охватом размеченных по действиям демонстраций роботов. Видео с людьми дают куда более широкий опыт поведения и окружающей среды, однако обучение на них упирается в фундаментальный компромисс между масштабируемыми данными и явной привязкой к действиям.
В ответ авторы предлагают ThinkWorld, фреймворк обучения VLA, который опирает рассуждение о действиях на динамику мира и усиливает его обучением с подкреплением с «воображением мира» (world imagination). Каждая «мысль о действии» представляется как Chain-of-Dynamics (CoD, «цепочка динамики»): последовательность дискретных токенов движения, которая отражает промежуточную динамику между текущим состоянием мира и будущим состоянием. По замыслу авторов, CoD служит общим представлением действий для разных воплощений (роботов и людей).
Обучение идёт в два этапа. Сначала CoD инициализируют на демонстрациях с размеченными действиями. Затем для каждой CoD предсказывают порождаемое ею будущее и усиливают те цепочки, чьи предсказания лучше совпадают с наблюдаемым результатом. Благодаря этому видео без разметки действий даёт прямой обучающий сигнал из наблюдаемых переходов между состояниями, и опыт людей и роботов уточняет одно и то же пространство рассуждений.
Итог, заявленный в аннотации: эксперименты в симуляции и на реальных роботах показывают эффективный перенос от человека к роботу и сильное обобщение на незнакомые задачи и среды. Численных результатов, названий бенчмарков и конкретных роботов в тексте нет.
Ключевые факты
- ThinkWorld, фреймворк обучения VLA-моделей, опирающий рассуждение о действиях на динамику мира.
- Действие представлено как Chain-of-Dynamics (CoD): последовательность дискретных токенов движения между текущим и будущим состоянием мира, общая для разных воплощений.
- Сначала CoD инициализируют на размеченных демонстрациях, затем усиливают цепочки, чьё предсказанное будущее лучше совпадает с наблюдаемым исходом.
- Видео без разметки действий становится прямым источником обучающего сигнала, а опыт людей и роботов уточняет общее пространство рассуждений.
- Авторы заявляют эффективный перенос от человека к роботу и сильное обобщение в симуляции и на реальных роботах.
Почему это важно
Нехватка разнообразных размеченных демонстраций роботов, одно из заявленных ограничений VLA-моделей. Подход ThinkWorld пытается обойти его: использовать видео без разметки действий, сверяя предсказанное будущее с реально наблюдаемым. Если заявленное подтвердится, это даст путь к масштабированию обучения роботов на человеческих видео.
Кому это важно
Исследователям робототехники и VLA-моделей, а также командам, которые обучают роботов манипуляциям и ищут способы использовать видеоданные людей без дорогой разметки действий.
Как это применить
Из аннотации практических инструкций не видно: о коде, весах, размере модели и вычислительных затратах в тексте ничего не сказано. Пока это идея для изучения полной статьи и воспроизведения, а не готовый инструмент.
Можно ли доверять
Источник, аннотация препринта на Hugging Face Papers, все утверждения принадлежат самим авторам. Конкретных чисел, названий бенчмарков и базовых методов для сравнения в тексте нет, поэтому оценить силу заявленного «сильного обобщения» по нему нельзя. Нужна проверка по полному тексту статьи.
Риски и подводные камни
Заявления об эффективном переносе от человека к роботу и обобщении даны без количественных подтверждений. Неизвестно, какие роботы и симуляторы использовались и какой алгоритм обучения с подкреплением применён, поэтому воспроизводимость и применимость за пределами описанных экспериментов остаются под вопросом.