Terminal-RSI: метод самоулучшения терминальных ИИ-агентов на Qwen3.8-27B
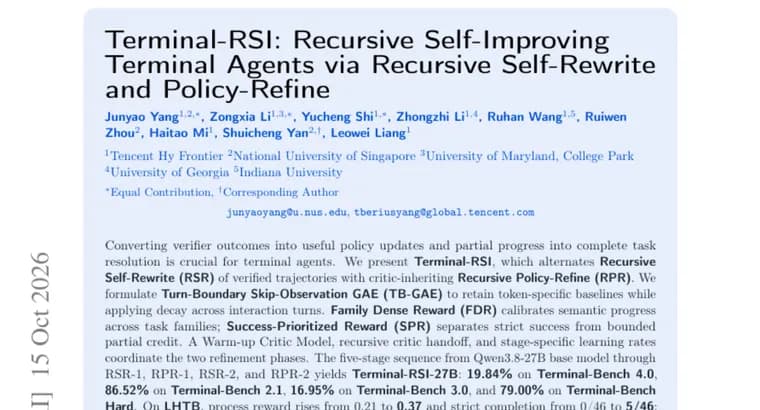
В статье на Hugging Face Papers (2610.22192) описан Terminal-RSI, метод обучения терминальных агентов, то есть ИИ-агентов, которые решают задачи в командной строке. Исходная посылка авторов: для таких агентов важно превращать исход проверки (верификатора) в полезные обновления политики, а частичный прогресс, в полностью решённую задачу.
Метод чередует два шага. Первый, Recursive Self-Rewrite (RSR, «рекурсивное самопереписывание») проверенных траекторий. Второй, Recursive Policy-Refine (RPR, «рекурсивное уточнение политики») с наследованием критика от предыдущей стадии. Обучение идёт пятью стадиями: от базовой модели Qwen3.8-27B через RSR-1, RPR-1, RSR-2 и RPR-2 получается Terminal-RSI-27B.
Среди технических элементов авторы называют: Turn-Boundary Skip-Observation GAE (TB-GAE), который сохраняет базовые уровни (baselines) для отдельных токенов и при этом применяет затухание между ходами взаимодействия; Family Dense Reward (FDR), калибрующую семантический прогресс по семействам задач; Success-Prioritized Reward (SPR), которая отделяет строгий успех от ограниченного частичного зачёта. Обе фазы уточнения согласуют Warm-up Critic Model (прогревочный критик), рекурсивная передача критика между стадиями и отдельные скорости обучения для каждой стадии.
Заявленные результаты Terminal-RSI-27B: 19,84% на Terminal-Bench 4.0, 86,52% на Terminal-Bench 2.1, 16,95% на Terminal-Bench 3.0 и 79,00% на Terminal-Bench Hard. На LHTB процессная награда выросла с 0,21 до 0,37, а число строго выполненных задач, с 0/46 до 5/46. Успех на SWR100 удвоился, с 3,00% до 6,00%.
Авторы заключают, что, рекурсивно связывая переписывание проверенных траекторий с уточнением политики, каждая сохранённая стадия закрепляет найденное поведение и постепенно продвигает агента от частичных локальных исправлений к строгой терминальной проверке. Это их собственная характеристика метода.
Ключевые факты
- Terminal-RSI чередует Recursive Self-Rewrite (переписывание проверенных траекторий) и критик-наследующее Recursive Policy-Refine (уточнение политики).
- Пять стадий, от базовой Qwen3.8-27B через RSR-1, RPR-1, RSR-2 и RPR-2, дают модель Terminal-RSI-27B.
- Результаты по аннотации: 19,84% на Terminal-Bench 4.0, 86,52% на 2.1, 16,95% на 3.0 и 79,00% на Terminal-Bench Hard.
- На LHTB процессная награда выросла с 0,21 до 0,37, строгое выполнение, с 0/46 до 5/46; на SWR100 успех вырос с 3,00% до 6,00%.
- Среди элементов метода: TB-GAE, награды FDR и SPR, прогревочный критик и свои скорости обучения для каждой стадии.
Почему это важно
Терминальные агенты упираются в то, что верификатор говорит лишь «выполнено или нет», а большая часть работы, частичный прогресс. Terminal-RSI пытается превратить такие сигналы в устойчивые обновления политики и довести частичные исправления до строгой проверки. Если заявленное подтвердится, это пример того, как агента можно улучшать за несколько стадий на собственных проверенных траекториях.
Кому это важно
Исследователям и инженерам, которые обучают агентов с подкреплением на задачах командной строки, а также тем, кто следит за бенчмарками семейства Terminal-Bench. Отдельный интерес, приёмы работы с наградой (FDR, SPR) и критиком (передача между стадиями, прогревочный критик).
Как это применить
Практически применить результат пока нельзя: в аннотации не упомянут выпуск кода, весов или данных. Полезны идеи: разделять строгий успех и ограниченный частичный зачёт в награде, передавать критика от стадии к стадии и задавать отдельную скорость обучения каждой стадии. Детали реализации нужно искать в полном тексте статьи.
Можно ли доверять
Это препринт, и пересказ опирается только на его аннотацию. В ней не названы метрики, которые стоят за процентами на Terminal-Bench 4.0, 2.1, 3.0 и Hard, и не приведены исходные значения для этих бенчмарков, поэтому оценить прирост нельзя. Не расшифрованы LHTB и SWR100, не сказано, какая модель даёт значения «до» (0,21; 0/46; 3,00%). Сравнения с другими агентами нет. Вывод о том, что каждая стадия закрепляет найденное поведение, собственная характеристика авторов.
Риски и подводные камни
Абсолютные цифры без базовых значений и без описания метрик легко прочитать неверно: 86,52% на одном варианте и 16,95% на другом несопоставимы без знания, что они измеряют. Рост на LHTB скромный по числу задач (5 из 46), а удвоение на SWR100, это переход с 3,00% до 6,00%. Данных о вычислительных затратах, длительности обучения и размере датасета в аннотации нет, поэтому воспроизводимость и цена метода неизвестны.
«Рекурсивно связывая переписывание проверенных траекторий с уточнением политики, наследующим критика, каждая сохранённая стадия закрепляет найденное поведение и постепенно продвигает агента от частичных локальных исправлений к строгой терминальной проверке.»
— из аннотации статьи Terminal-RSI