StreamVibe: видеоагент, который сам реагирует на неявные намерения пользователя
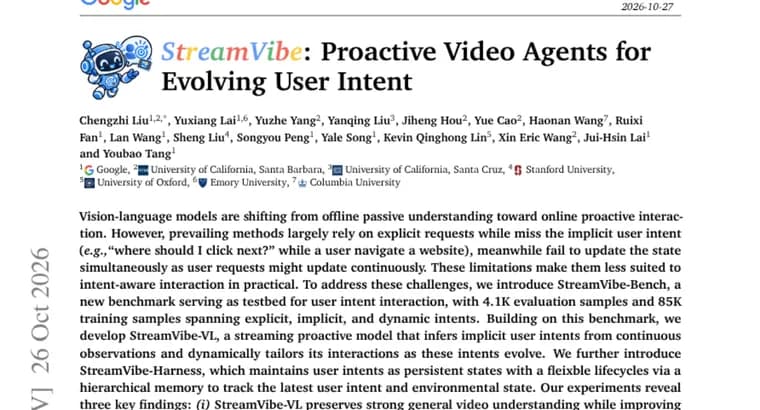
Авторы исходят из того, что модели, работающие с видео и текстом (vision-language models), переходят от пассивного разбора записанного видео к активному взаимодействию в реальном времени. Но существующие методы, по их словам, в основном опираются на явные запросы, упускают неявные намерения пользователя и не успевают обновлять своё состояние, когда запросы непрерывно меняются. Пример неявного намерения из текста: человек перемещается по сайту и, по сути, спрашивает «куда мне нажать дальше?».
Чтобы закрыть этот разрыв, предложены три компонента. Первый, StreamVibe-Bench, новый бенчмарк как испытательный стенд для взаимодействия по намерениям пользователя: 4,1 тыс. оценочных и 85 тыс. обучающих примеров, охватывающих явные, неявные и динамические намерения. Второй, StreamVibe-VL, потоковая проактивная модель: она выводит неявные намерения из непрерывных наблюдений и подстраивает взаимодействие по мере того, как намерения меняются. Третий, StreamVibe-Harness: он хранит намерения пользователя как устойчивые состояния с гибким жизненным циклом в иерархической памяти, чтобы отслеживать последнее намерение и состояние окружения.
Эксперименты, по заявлению авторов, дали три вывода. Первый: StreamVibe-VL сохраняет сильное общее понимание видео и при этом улучшает момент ответа и качество ответов на 10,7% относительно других базовых решений. Второй: существующие проактивные модели по-прежнему плохо понимают намерения пользователя и плохо решают, когда отвечать, особенно при неявных и динамических намерениях. Третий: StreamVibe-Harness дополнительно повышает согласованность ответов и адаптацию при длительном взаимодействии, давая прирост проактивного взаимодействия на 12,3%.
Все результаты, самоотчёт авторов в аннотации статьи. В тексте не уточняется, в процентах или процентных пунктах даны 10,7% и 12,3%, по каким метрикам и с какими базовыми решениями проведено сравнение.
Ключевые факты
- StreamVibe, набор из бенчмарка StreamVibe-Bench, потоковой проактивной модели StreamVibe-VL и памяти StreamVibe-Harness для видеоагентов, работающих с неявными и меняющимися намерениями пользователя.
- StreamVibe-Bench содержит 4,1 тыс. оценочных и 85 тыс. обучающих примеров с явными, неявными и динамическими намерениями.
- По заявлению авторов, StreamVibe-VL сохраняет сильное общее понимание видео и улучшает момент ответа и качество ответов на 10,7% относительно других базовых решений.
- StreamVibe-Harness хранит намерения как устойчивые состояния в иерархической памяти и, по данным авторов, даёт прирост проактивного взаимодействия на 12,3%.
- Авторы отмечают, что существующие проактивные модели ограниченно понимают намерения и плохо выбирают момент для ответа, особенно при неявных и динамических намерениях.
Почему это важно
Видеоассистенты всё чаще должны работать «вживую», а не разбирать готовую запись. Обычно они отвечают только на прямой вопрос, а в реальной ситуации человек часто не формулирует цель явно, и она к тому же меняется. StreamVibe ставит именно эту задачу: угадывать неявное намерение по непрерывному потоку видео и решать, когда вмешаться. Отдельный бенчмарк с явными, неявными и динамическими намерениями даёт способ измерять такое поведение.
Кому это важно
Исследователям мультимодальных моделей и потокового видеопонимания, которым нужны данные и стенд для проверки проактивного поведения. Разработчикам ассистентов, которые следят за происходящим на экране или в видеопотоке и должны сами выбирать момент для подсказки.
Как это применить
Из аннотации практических шагов не следует: в источнике нет сведений о выпуске кода, данных или моделей. Идею можно взять как схему: отдельно хранить намерения пользователя как состояния с жизненным циклом в иерархической памяти, а момент ответа оценивать как самостоятельную задачу. Для проверки этого на своих данных нужно дождаться полного текста статьи.
Можно ли доверять
Источник, аннотация статьи в разделе Hugging Face Papers. Результаты 10,7% и 12,3%, самоотчёт авторов; не указано, в процентах или процентных пунктах они выражены, по каким метрикам и с какими базовыми решениями проводилось сравнение. Бенчмарк предложен теми же авторами, что и модель. Независимой проверки в источнике нет.
Риски и подводные камни
Заявленные приросты нельзя интерпретировать без деталей оценки: неясно, на чём измерялись улучшения. Единственный пример неявного намерения, вопрос «куда нажать дальше?» при просмотре сайта, других сценариев в тексте нет. Данных о задержках, вычислительной стоимости и работе в реальных условиях источник не приводит, поэтому пригодность для практических продуктов остаётся открытым вопросом.