Среда Station: ИИ-агенты переоткрыли 62,7% критериев из трёх статей ICLR
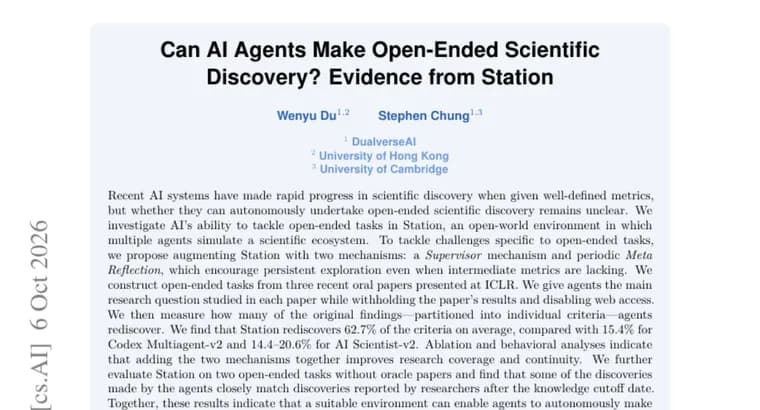
Современные ИИ-системы быстро продвинулись в научных открытиях там, где заданы чёткие метрики, но остаётся неясным, могут ли они автономно вести открытые исследования. Авторы статьи проверяют это в Station, открытой среде (open-world environment), в которой несколько агентов имитируют научную экосистему.
Для задач без промежуточных метрик Station дополнили двумя механизмами: Supervisor (супервизор) и периодической Meta Reflection (метарефлексией). По замыслу авторов, они поддерживают настойчивое исследование, даже когда промежуточных метрик нет.
Эксперимент устроен так. Из трёх недавних статей, представленных на ICLR в формате oral (устного доклада), построили открытые задачи. Агентам дали главный исследовательский вопрос каждой статьи, скрыв результаты работы и отключив доступ в интернет. Затем считали, сколько исходных находок, разбитых на отдельные критерии, агенты переоткрыли.
Station в среднем переоткрыла 62,7% критериев. Для сравнения: у Codex Multiagent-v2 этот показатель 15,4%, у AI Scientist-v2, 14,4-20,6%. Абляционный анализ и анализ поведения показывают, что добавление двух механизмов вместе улучшает охват исследования и его непрерывность.
Ещё Station оценили на двух открытых задачах без эталонных статей. Авторы сообщают, что часть открытий агентов близко совпала с открытиями, о которых исследователи сообщили уже после даты отсечки знаний. Общий вывод авторов: подходящая среда позволяет агентам автономно добиваться значимого прогресса в открытых научных исследованиях.
Ключевые факты
- Station, открытая среда, где несколько агентов имитируют научную экосистему; её дополнили механизмом Supervisor и периодической Meta Reflection.
- Задачи построены по трём недавним oral-статьям ICLR: агентам дали главный вопрос, скрыв результаты и отключив веб-доступ.
- Station переоткрыла в среднем 62,7% критериев против 15,4% у Codex Multiagent-v2 и 14,4, 20,6% у AI Scientist-v2.
- Оба механизма вместе, по абляциям и анализу поведения, повышают охват и непрерывность исследования.
- На двух задачах без эталонных статей часть открытий агентов близко совпала с результатами, опубликованными исследователями после даты отсечки знаний.
Почему это важно
До сих пор ИИ-системы хорошо справлялись с научными задачами, где есть понятная метрика. Работа проверяет более трудный случай, открытые исследования, где промежуточных метрик нет, и показывает заметный отрыв Station от базовых систем: 62,7% переоткрытых критериев против 15,4% и 14,4-20,6%.
Кому это важно
Тем, кто разрабатывает многоагентные системы для научной работы и исследовательской автоматизации, а также тем, кто оценивает, насколько ИИ способен вести исследования без жёстко заданной метрики.
Как это применить
Из статьи можно взять два приёма: надзирающий механизм (Supervisor) и периодическую рефлексию агентов, чтобы они продолжали исследование без промежуточных метрик. Схема оценки тоже переносима: берут опубликованную работу, скрывают её результаты, отключают веб-доступ и считают, сколько отдельных критериев агенты нашли сами.
Можно ли доверять
Это препринт, и перед нами пересказ его аннотации: все выводы принадлежат самим авторам. Цифры сравнения с Codex Multiagent-v2 и AI Scientist-v2 получены в их же постановке задач. Совпадение открытий агентов с результатами исследователей после даты отсечки знаний описано как частичное и без деталей.
Риски и подводные камни
Тест опирается всего на три статьи ICLR, и в аннотации они не названы, поэтому оценить трудность задач нельзя. Не раскрыто, как посчитано среднее 62,7% (по задачам или по всем критериям), нет разбивки по задачам и цифр абляций. Две задачи без эталонных статей не описаны, а совпали с более поздними открытиями лишь некоторые находки агентов, не все.
«Вместе эти результаты показывают, что подходящая среда может позволить агентам автономно добиваться значимого прогресса в открытых научных исследованиях.»
— из аннотации статьи
Компания Meta Platforms признана экстремистской организацией, её деятельность на территории РФ запрещена.