Сотрудник NVIDIA собрал на моделях Nemotron говорящий дом для Хэллоуина
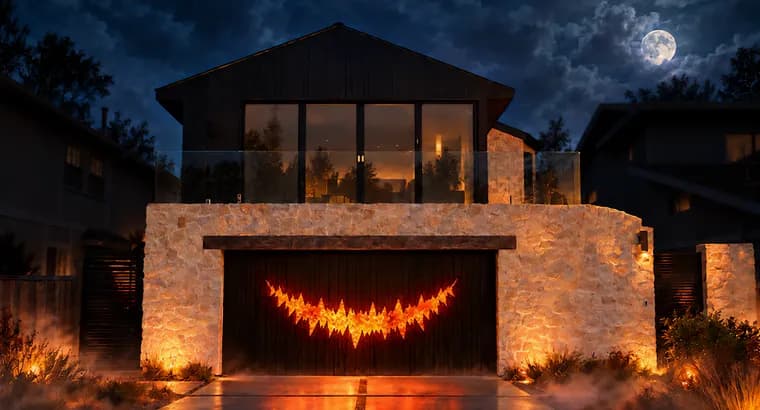
Автор поста, который сам называет себя сотрудником NVIDIA, придумал интерактивную проекцию MonsterHouse для Хэллоуина. Гаражным воротам «пририсован» рот из рваных досок, а за ним мерцает виртуальный огонь. Дом слушает детей, пришедших за конфетами, и отвечает голосом ворчливого старого пирата, а к тем, кто вспомнил о вежливости, постепенно смягчается. «Пожалуйста» может пробить оборону сразу, «спасибо» заслуживает тёплого прощания. У дома есть легенда: он построен из досок затонувшего пиратского корабля.
Основа проекта, NVIDIA Nemotron Voice Agent. Слушает Nemotron ASR (распознавание речи), ответы пишет Nemotron 3.5 Bolt E4B 4GB (открытая малая языковая модель для локальных разговорных агентов и интерактивных персонажей; используется 4-битная квантованная версия, версия BF16 есть для сравнения). Голос синтезирует Magpie TTS Zeroshot по короткому образцу голоса персонажа, а рот в Unreal Engine 5 анимирует Audio2Face-3D. Модель для камеры, Nemotron 3 Nano Omni: она по желанию описывает костюмы, а YOLO и ByteTrack считают и отслеживают людей в кадре. Модель Bolt автор протестировал до её публичного релиза, после проверки более десятка моделей. По словам автора, у неё меньший размер, чем у Qwen3 30B-A3B и Qwen 3.6 35B-A3B. Характер задают промпты, логика приложения и LoRA-адаптер, обученный на датасете из более чем 5000 многоходовых диалогов. Датасет создавали и оценивали локальный агент и очень большая языковая модель; обучение каждого адаптера занимало от около часа до пары часов.
Чтобы дом не заставлял ждать, конвейер отдаёт пригодный для озвучивания текст, не дожидаясь конца ответа. Готовые приветствия и шутки про конфеты хранятся в банке текстов и в кэшированных записях, это экономит работу модели и синтез речи. Замеры: медианная задержка от конца речи до звука с Bolt Q4 и синтезом речи, 1,70 секунды, для кэшированных ответов, 0,72 секунды; детектор конца речи сейчас ждёт 300 мс тишины. У дома семь настроений, от ворчливого и угрожающего до весёлого и восторженного; метку эмоции выдаёт языковая модель по шаблону промпта, а для каждой эмоции нужен свой образец голоса длиной 3-10 секунд. Для этого в интерфейсе добавлен блок записи образца. Audio2Face-3D получает чистую речь, а отдельный аудиопоток с настраиваемыми эффектами уходит в колонки; задержку буферизации Audio2Face-3D компенсирует сдвиг в 100 мс.
Всё работает на одной рабочей станции: языковой и голосовой конвейер, на NVIDIA RTX PRO 6000 Blackwell Max-Q, графика Unreal Engine с Audio2Face-3D, на NVIDIA RTX PRO 4000 Blackwell. По словам автора, упираются не в память, а в вычислительную мощность, поэтому анимацию отделили, чтобы частота кадров не падала. У проекта есть пульт управления: вкладки с диалогами, выбором моделей, записями, промптами, мониторингом и камерами, «звуковая панель», поле для произвольных реплик, правила привязки огня и свечения к голосу. Режим Live запускает персонажа для детей, Demo заставляет дом объяснить себя, а в режиме микрофона автор говорит через дом напрямую, минуя распознавание, генерацию и синтез.
В тесте с синтетическим видео пяти костюмированных овец у двери Nemotron 3 Nano Omni по сохранённому анализу определила костюмы пирата, вампира, ведьмы, тыквы и привидения. Автор подчёркивает, что это не доказательство успешной ночи: нужны проверки на реальных группах, костюмах и ночном освещении. Детекция запускает автоматические приветствия, но распознаванию модных костюмов и остроумным ответам, возможно, потребуется дообучение. Исходная цель, оставить дом одного на Хэллоуин, а самому уйти с семьёй, пока не достигнута, а раздача конфет автоматически, задача на будущее. Код MonsterHouse не опубликован, но все использованные модели NVIDIA доступны.
Ключевые факты
- MonsterHouse, интерактивная проекция на гаражных воротах: дом слушает детей на Хэллоуин и отвечает голосом ворчливого пирата, смягчаясь от слов «пожалуйста» и «спасибо».
- Стек: NVIDIA Nemotron Voice Agent с Nemotron ASR, Nemotron 3.5 Bolt E4B 4GB (4-битная версия), Magpie TTS Zeroshot и Audio2Face-3D; всё на одной станции с двумя GPU (RTX PRO 6000 Blackwell Max-Q и RTX PRO 4000 Blackwell).
- Характер задан LoRA-адаптером, обученным на датасете из более чем 5000 многоходовых диалогов, плюс промптами и логикой приложения.
- Медианная задержка от конца речи до звука, 1,70 секунды с Bolt Q4 и синтезом речи и 0,72 секунды для кэшированных ответов; детектор конца речи ждёт 300 мс тишины.
- Автор признаёт, что проверка на реальных посетителях ещё впереди, а код проекта не опубликован.
Почему это важно
Это не крупный релиз, а наглядная демонстрация того, как из открытых моделей NVIDIA собирается полностью автономный голосовой агент-персонаж, который работает локально, без внешних облачных сервисов. Пост показывает конкретный набор: распознавание речи, малая языковая модель, синтез голоса по короткому образцу, анимация лица и зрение. Показательны и измерения задержки: 1,70 секунды в обычном режиме и 0,72 секунды на кэшированных ответах.
Кому это важно
Разработчикам голосовых агентов и интерактивных персонажей, энтузиастам локального запуска моделей, тем, кто делает инсталляции, игры или аттракционы с живым диалогом. Полезен и тем, кто выбирает малую языковую модель под ограниченный бюджет памяти и вычислений: автор тестировал более десятка моделей и остановился на Bolt E4B.
Как это применить
Автор предлагает такую схему: взять Nemotron Voice Agent как основу для слушания, диалога и речи, подключить небольшую языковую модель и обучить LoRA-адаптер на собственном датасете диалогов (у него, более 5000 многоходовых диалогов, каждый адаптер обучался от около часа до пары часов). Для ускорения советует заранее подготовленные реплики с кэшированными аудиозаписями. Для голоса нужен образец длиной 3-10 секунд на каждую эмоцию. Если задействована анимация лица, графику разумно вынести на отдельный GPU. Сам код MonsterHouse не опубликован, но по словам автора все использованные модели NVIDIA доступны.
Можно ли доверять
Автор прямо сообщает, что работает в NVIDIA и тестировал Bolt E4B до публичного релиза, поэтому пост, витрина собственных моделей компании, а не независимая проверка. Сравнение с Qwen3 30B-A3B и Qwen 3.6 35B-A3B ограничено замечанием о меньшем размере без цифр, бенчмарков с другими моделями нет. Задержки приведены только для варианта Bolt Q4. Автор честно оговаривает, что тест с овцами синтетический, а проверка на реальных посетителях впереди. Текст источника обрывается в последнем разделе, ссылки на загрузку и условия лицензий в видимой части не приведены.
Риски и подводные камни
Проект остаётся прототипом: исходная цель оставить дом без присмотра не достигнута, раздача конфет не автоматизирована, а распознавание костюмов и остроумные ответы, по признанию автора, могут потребовать дообучения. Реальные группы детей, костюмы и ночное освещение ещё не проверены. Конфигурация требует двух мощных профессиональных GPU, и вычислительная мощность, а не память, является узким местом. Код проекта не выложен, так что повторить его придётся самостоятельно.
«Я занят ворчанием, идите донимать соседей!»
— пример реплики-отповеди дома-персонажа, как её приводит автор