Skill2Real учит робота навыкам в симуляции и переносит на реального без дообучения
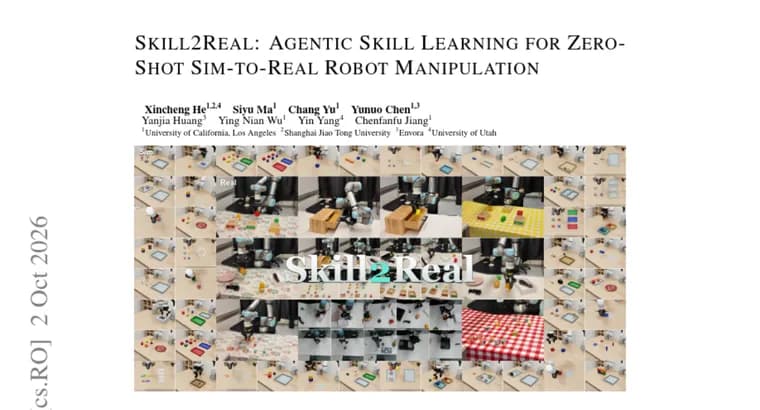
Статья описывает Skill2Real, агентный фреймворк, который учит робота-манипулятора исполняемым навыкам через общий программный интерфейс (API) и переносит их из симуляции на реального робота. Исходная проблема сформулирована так: чтобы перенести навыки из симуляции в реальность, нужны знания о задаче, которые остаются пригодными при различиях в восприятии, динамике и устройстве робота.
Устройство системы. Центральный элемент, цикл Proposer-Verifier-Governor (PVG). Он использует привилегированные данные симуляции, чтобы разбирать исходы попыток и проверять обновления, а сами выученные навыки при этом остаются привязаны к публичным наблюдениям и семантике API. Обучение двухуровневое: сначала Cerebellum (мозжечок) осваивает локальные навыки манипуляции, затем Brain (мозг) учится составлять из них решение задачи целиком, при этом Cerebellum заморожен. Обе «памяти» переносятся на реального робота без дообучения политики под задачу и без обновления памяти навыков.
Результаты. Пока GPT-5.6 Sol учит навыки на наборе LIBERO-90, оценка каждого замороженного чекпойнта с GPT-6 Astra поднимает успех на LIBERO-Pro Long с 2,0% до 56,3%, без обучения на Pro Long. Независимое обучение в Robosuite даёт средний успех 85,1% с Sol и 89,4% с Opus 5 по семи задачам. Замороженные навыки, выученные Sol на LIBERO-90, дают 78,75% среднего выполнения на четырёх реальных задачах манипуляции с Astra.
Абляция. Если убрать из обучения на LIBERO-90 Verifier или Governor, итоговый успех на Pro Long падает на 17,3 и 13,3 процентного пункта соответственно. Вывод авторов осторожный: результаты поддерживают идею изучения и переноса иерархии исполняемых навыков через общий интерфейс робота.
Ключевые факты
- Skill2Real учит навыкам через общий API; обучение идёт в симуляции, перенос на реального робота, без дообучения политики и без обновления памяти навыков.
- Цикл Proposer-Verifier-Governor (PVG) использует привилегированные данные симуляции для диагностики и проверки обновлений; иерархия, Cerebellum (локальные навыки) и Brain (композиция задач при замороженном Cerebellum).
- LIBERO-Pro Long: успех вырос с 2,0% до 56,3% без обучения на Pro Long (GPT-5.6 Sol учит навыки на LIBERO-90, чекпойнты оцениваются с GPT-6 Astra).
- Robosuite, семь задач: средний успех 85,1% с Sol и 89,4% с Opus 5; на четырёх реальных задачах, 78,75% среднего выполнения.
- Без Verifier или Governor итоговый успех на Pro Long ниже на 17,3 и 13,3 процентного пункта соответственно.
Почему это важно
Разрыв между симуляцией и реальностью остаётся одной из главных трудностей робототехники: навыки, выученные в симуляторе, должны выдерживать различия в восприятии, динамике и устройстве робота. Skill2Real предлагает переносить не веса политики, а исполняемые навыки через общий интерфейс. По заявлению авторов, перенос идёт без дообучения под задачу, а на реальных задачах достигнуто 78,75% среднего выполнения.
Кому это важно
Исследователям робототехники и обучения с подкреплением, которые занимаются переносом из симуляции в реальность и манипуляцией. Также интересно тем, кто строит агентные системы поверх языковых моделей: здесь модели выступают не исполнителями на лету, а обучающими навыкам агентами.
Как это применить
Из аннотации не следует готового рецепта внедрения: речь о результатах исследования. Общая идея для практиков, описывать навыки через единый API и разделять обучение на локальные навыки (Cerebellum) и их композицию (Brain) с замороженным нижним уровнем, а обновления навыков проверять отдельным циклом PVG.
Можно ли доверять
Пересказ основан только на аннотации статьи; полный текст, методика оценки и условия экспериментов не рассмотрены. Все цифры, результаты самих авторов. В аннотации не раскрыто, какой именно робот и какие четыре реальные задачи использовались, и нет сравнения для цифры 78,75%. Сами авторы формулируют вывод осторожно: результаты «поддерживают» подход.
Риски и подводные камни
Реальный эксперимент ограничен четырьмя задачами, а 78,75%, среднее выполнение, а не стопроцентная надёжность. Заметный прирост на Pro Long (с 2,0% до 56,3%) получен с конкретными моделями, GPT-5.6 Sol для обучения навыков и GPT-6 Astra для оценки, поэтому перенос на другие модели не гарантирован. Абляция показывает, что без Verifier или Governor качество заметно падает, то есть результат зависит от всей схемы целиком.