Semi-OPD обошла on-policy дистилляцию в 14 из 17 пар моделей
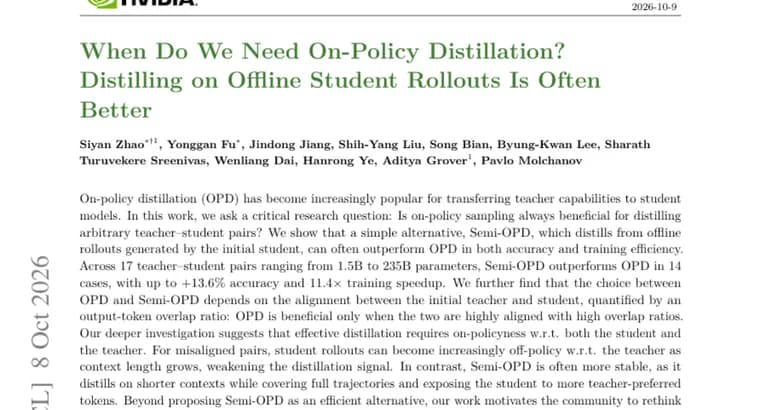
On-policy дистилляция (OPD), популярный способ передать возможности модели-учителя модели-ученику. Авторы статьи задаются вопросом: всегда ли on-policy сэмплирование полезно при дистилляции для произвольных пар «учитель, ученик»?
Они предлагают простую альтернативу, Semi-OPD, которая обучает ученика на офлайн-траекториях (rollouts), сгенерированных исходным учеником. По их результатам, такой подход часто превосходит OPD и по точности, и по эффективности обучения. На 17 парах «учитель, ученик» размером от 1,5 млрд до 235 млрд параметров Semi-OPD оказалась лучше OPD в 14 случаях, с выигрышем до +13,6% точности и ускорением обучения до 11,4 раза.
Выбор между OPD и Semi-OPD, как показали авторы, зависит от согласованности исходных учителя и ученика, которую они измеряют долей перекрытия выходных токенов. OPD полезна только тогда, когда пара сильно согласована и доля перекрытия высока.
Объяснение авторов такое: более глубокий анализ говорит о том, что эффективной дистилляции нужна on-policy-природа траекторий относительно и ученика, и учителя. У плохо согласованных пар траектории ученика по мере роста длины контекста всё сильнее уходят от распределения учителя (становятся off-policy относительно него), и сигнал дистилляции слабеет. Semi-OPD, по их наблюдениям, часто стабильнее: она дистиллирует на более коротких контекстах, при этом покрывает траектории целиком и показывает ученику больше токенов, которые предпочитает учитель.
Помимо самой Semi-OPD как эффективной альтернативы, авторы призывают сообщество пересмотреть, когда стоит применять OPD, и изучать более сильные варианты OPD на осмысленных парах «учитель, ученик».
Ключевые факты
- Semi-OPD обучает ученика на офлайн-траекториях, сгенерированных исходным учеником, а не на траекториях, которые он порождает в ходе обучения.
- На 17 парах «учитель, ученик» (от 1,5 млрд до 235 млрд параметров) Semi-OPD превзошла OPD в 14 случаях.
- Максимальные выигрыши: до +13,6% точности и до 11,4 раза по скорости обучения.
- OPD полезна только при сильной согласованности учителя и ученика, то есть при высокой доле перекрытия выходных токенов.
- У плохо согласованных пар траектории ученика по мере роста контекста уходят от распределения учителя; Semi-OPD стабильнее, потому что работает на более коротких контекстах.
Почему это важно
On-policy дистилляция стала популярным способом переносить возможности большой модели в меньшую. Работа ставит под сомнение саму посылку, что on-policy сэмплирование всегда полезно: на 14 из 17 протестированных пар более простая Semi-OPD дала результат лучше, причём часто и по точности, и по скорости обучения. Авторы предлагают смотреть на согласованность учителя и ученика, прежде чем выбирать схему дистилляции.
Кому это важно
Прежде всего тем, кто занимается дистилляцией моделей и выбирает схему обучения ученика под конкретного учителя: исследователям и командам, которые сжимают большие модели в меньшие. Выводы охватывают широкий диапазон размеров, от 1,5 млрд до 235 млрд параметров.
Как это применить
Практический ориентир из статьи: прежде чем запускать OPD, оценить согласованность исходных учителя и ученика по доле перекрытия выходных токенов. Если пара плохо согласована, авторы советуют рассматривать Semi-OPD, дистилляцию на офлайн-траекториях исходного ученика. Конкретного порога перекрытия в аннотации нет, а о выпуске кода или моделей там не сказано.
Можно ли доверять
Источник, аннотация статьи на Hugging Face Papers; полного текста, авторов и организаций в ней нет, площадки публикации и даты тоже нет. Цифры (14 из 17, до +13,6%, до 11,4 раза), заявления самих авторов; независимой проверки в материале нет. Формулировка про on-policy-природу траекторий дана авторами как предположение, вытекающее из их анализа («suggests»), а не как доказанный факт.
Риски и подводные камни
Названные максимумы, «до»: типичный выигрыш по точности и по скорости в аннотации не указан. Не сказано, на каких бенчмарках и задачах измерена точность, какие именно модели составили пары и на какой из них получены рекордные +13,6% и 11,4 раза; неясно также, это процентные пункты или относительный прирост. В трёх случаях из 17 Semi-OPD не превзошла OPD, и что там происходило, не описано. Порог перекрытия токенов, по которому выбирать схему, не приведён.
«OPD полезна только тогда, когда они хорошо согласованы, с высокими значениями доли перекрытия.»
— Авторы статьи, аннотация на Hugging Face Papers