Routing Policy Optimization: авторы заявили почти 4-кратный выигрыш в обучении диффузионных генераторов
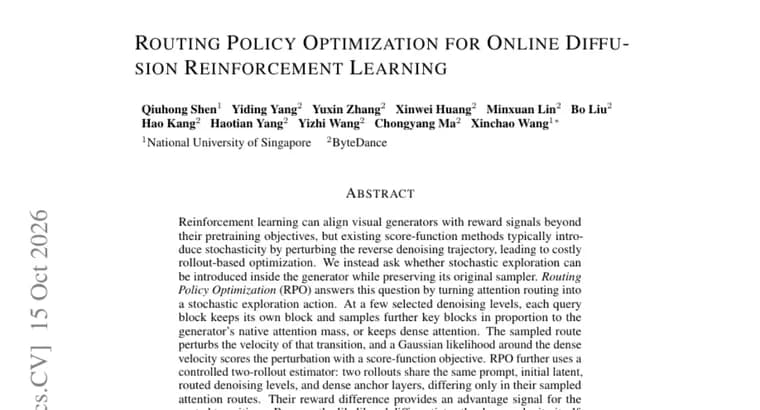
В статье представлен метод Routing Policy Optimization (RPO) для обучения с подкреплением визуальных генераторов (диффузионных и потоковых моделей). Исходная посылка авторов: обучение с подкреплением позволяет подстраивать такие генераторы под сигналы награды, выходящие за рамки целей предобучения, но существующие методы на основе score-function (оценки градиента через функцию правдоподобия) обычно вносят случайность, возмущая обратную траекторию шумоподавления, что приводит к дорогой оптимизации на основе прогонов (rollout).
RPO предлагает другой путь: вносить стохастическое исследование внутри самого генератора, сохраняя его исходный сэмплер. Для этого маршрутизация внимания превращается в случайное действие исследования. На нескольких выбранных уровнях шумоподавления каждый блок запросов сохраняет собственный блок и дополнительно выбирает блоки ключей пропорционально «родной» массе внимания генератора, либо оставляет плотное (полное) внимание. Выбранный маршрут возмущает скорость соответствующего перехода, а гауссово правдоподобие вокруг плотной скорости оценивает это возмущение с помощью целевой функции score-function.
Кроме того, RPO использует контролируемую оценку по двум прогонам: два прогона разделяют один и тот же запрос, начальный латент, маршрутизируемые уровни шумоподавления и плотные опорные слои и отличаются только выбранными маршрутами внимания. Разница их наград даёт сигнал преимущества (advantage) для маршрутизируемых переходов. Поскольку правдоподобие дифференцирует саму плотную скорость, обученные обновления остаются эффективными и после отключения маршрутизации. На этапе вывода RPO возвращает плотное внимание и сохраняет исходный детерминированный сэмплер.
По заявлению авторов, эксперименты по генерации изображений и видео по тексту показывают, что RPO улучшает качество генерации и при этом даёт почти в 4 раза более высокую эффективность обучения, чем методы типа Flow-GRPO. Визуальные результаты опубликованы на странице проекта (velox-world.com/rpo).
Ключевые факты
- RPO вносит случайность не в траекторию шумоподавления, а в маршрутизацию внимания внутри генератора, сохраняя исходный сэмплер.
- Маршрутизация применяется лишь на нескольких выбранных уровнях шумоподавления: блок запросов оставляет свой блок и выбирает дополнительные блоки ключей пропорционально родной массе внимания либо сохраняет плотное внимание.
- Используется оценка по двум прогонам с общим запросом, начальным латентом и плотными опорными слоями; разница наград даёт сигнал преимущества.
- На этапе вывода возвращается плотное внимание и исходный детерминированный сэмплер.
- Заявлено улучшение качества в генерации изображений и видео по тексту и почти 4-кратный выигрыш в эффективности обучения относительно методов типа Flow-GRPO.
Почему это важно
Обучение с подкреплением, способ подстроить визуальные генераторы под награды, которых нет в целях предобучения, но, по словам авторов, существующие методы на основе score-function дороги из-за возмущения траектории шумоподавления и оптимизации через прогоны. RPO предлагает вынести исследование внутрь генератора через маршрутизацию внимания и заявляет почти 4-кратный выигрыш в эффективности обучения относительно методов типа Flow-GRPO.
Кому это важно
Исследователям и инженерам, которые дообучают диффузионные и потоковые модели для генерации изображений и видео с помощью обучения с подкреплением и ищут способы снизить стоимость такого обучения.
Как это применить
Из доступного текста ясно лишь, что визуальные результаты размещены на странице проекта (velox-world.com/rpo). О публикации кода или весов в источнике ничего не сказано, поэтому практическое применение пока можно оценивать только по описанию метода.
Можно ли доверять
Это описание метода из аннотации препринта; все утверждения о качестве и эффективности принадлежат самим авторам. В тексте нет названий бенчмарков, наград и базовых моделей, нет численных оценок улучшения качества, не указано, как измеряется эффективность обучения и с какими именно методами типа Flow-GRPO идёт сравнение. Независимой проверки результатов в источнике нет.
Риски и подводные камни
Заявленный выигрыш «почти в 4 раза», относительная величина без раскрытой методики измерения (время, число прогонов или затраты на GPU неизвестны). В аннотации не описаны ограничения, неудачные случаи и вычислительные затраты метода, так что перенос результата на другие модели и задачи нужно проверять отдельно.