Retrieve-for-Train от Google Research: ИИ-поиск ускорился в 12, 20 раз
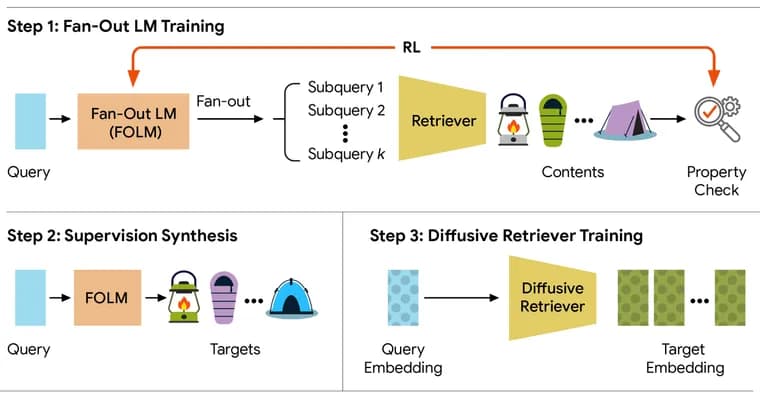
Современные поисковые и рекомендательные системы всё чаще должны выдавать не один лучший результат, а согласованный набор из нескольких. Например, по запросу «снаряжение для похода» пользователю не нужны десять похожих палаток, нужен дополняющий друг друга набор: палатка, спальный мешок, переносная горелка, налобный фонарь. Для этого системы используют технику веерного расширения запроса (query fan-out): один широкий запрос дробится на несколько связанных подзапросов. Проблема в том, что заставлять языковую модель придумывать такое разбиение на лету, с учётом конкретной базы данных, дорого: обычные («zero-shot») языковые модели по своей природе, это авторегрессионные предсказатели текста общего назначения, не заточенные под конкретное геометрическое многообразие целевого корпуса данных, и поэтому вынуждены тратить много вычислений и токенов на рассуждения при каждом запросе.
В статье «Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion», представленной на ICML 2026, исследователи Google Research Пэнчэн Цзян (студент-исследователь) и Джудит Юэ Ли (старший инженер-исследователь) предлагают решение, фреймворк Retrieve-for-Train. Вместо того чтобы заставлять модель «думать» при каждом поиске, метод один раз проводит офлайн-обучение с подкреплением: система сама находит наборы подзапросов, которые лучше всего согласуются с заданной функцией вознаграждения, и превращает это поведение в обучающие примеры. Затем это поведение дистиллируют в лёгкую диффузионную модель, которая уже во время реального поиска выдаёт весь набор подзапросов за один проход, без токенов на пошаговые рассуждения.
Устройство метода такое. Сначала две открытые языковые модели на 4 млрд параметров, Gemma3-4B и Qwen3-4B, дообучают обучением с подкреплением: каждая учится выдавать ровно 10 подзапросов на один поисковый запрос. Обучают их методом GRPO с «мягкой» PPO-регуляризацией, авторы называют этот вариант Soft-GRPO. Награда здесь устроена не как в классическом ранжировании, где каждый результат оценивается по отдельности: разнообразие и взаимодополняемость подзапросов, свойства всего набора целиком, у одного элемента их нет. Поэтому вознаграждение, взвешенный баланс трёх критериев, которые тянут модель в разные стороны: привязка к реальной базе данных (groundedness), соответствие смыслу запроса (alignment) и разнообразие подзапросов, которое авторы измеряют метрикой Vendi Score. Если оптимизировать только привязку к базе, модель начинает обманывать систему вознаграждения: генерирует бессмысленные строки, которые просто математически попадают в нужную точку базы. Если добавить только соответствие запросу, модель схлопывается в повторяющиеся перефразировки одного и того же запроса. Метрика Vendi Score нужна как раз для того, чтобы закрыть оба этих обходных пути: она заставляет модель искать сбалансированную область пространства эмбеддингов, где для высокой награды подзапросы должны быть одновременно валидными, привязанными к базе и по-настоящему разными по смыслу.
Сама дообученная обучением с подкреплением языковая модель уже даёт отличное качество веерного поиска, но остаётся медленной, она наследует обычные ограничения авторегрессионной генерации и высокий вычислительный бюджет на рассуждения. Поэтому её поведение дистиллируют в диффузионную модель Retrieve-for-Train размером всего 53,9 млн параметров: она генерирует все целевые направления подзапросов одновременно, за один параллельный проход в непрерывном пространстве эмбеддингов, а не последовательно, шаг за шагом. Разница в задержке при этом огромная: на больших контекстных батчах авторегрессионный подход растягивается линейно почти до 50 секунд, а диффузионная версия Retrieve-for-Train укладывается в диапазон от долей секунды до нескольких секунд, это ускорение в 12, 20 раз.
Метод проверили на двух задачах поиска по набору результатов, с разными мультимодальными моделями эмбеддингов: поиск изображений по текстовому описанию на крупном датасете модных образов, собранных пользователями (с поисковым модулем на основе CLIP), и поиск музыки по текстовому описанию на закрытом индустриальном датасете плейлистов, составленных экспертами (с моделью MuLan). По качеству обычные zero-shot-модели склонны выдавать почти синонимичные перефразировки, например, «богемный фестивальный стиль» и «богемная фестивальная мода», из-за чего результаты дублируются; Retrieve-for-Train же предлагает по-настоящему разные подзапросы (например, уводит поиск в сторону «сапог» или «кружева»), которые остаются строго привязанными к содержимому базы. На обеих задачах Retrieve-for-Train обошёл обычный поиск по одному запросу, zero-shot-расширение запроса и даже сильно оптимизированный метод Best-of-N, точную величину отрыва авторы не приводят.
Вывод авторов шире конкретного метода: обучение с подкреплением может быть очень эффективным как разовый «преобразователь цели» (objective transducer), инструмент, который один раз, офлайн, превращает сигнал вознаграждения в обучающие данные, а не как постоянно работающий механизм вывода. За счёт того что дорогой этап поиска нужного поведения через вознаграждение отделён от лёгкой конечной модели, авторы избегают задержки и вычислительных затрат, типичных для обучения с подкреплением, запущенного «на лету» в режиме онлайн-инференса. Retrieve-for-Train описан как результат исследования, статья ICML 2026, для специализированных и мультимодальных областей, где размеченных «под свойства набора» обучающих пар мало или они дороги в получении; о том, встроен ли метод в какой-либо продукт Google, в посте не говорится.
Ключевые факты
- Google Research опубликовала на ICML 2026 статью с фреймворком Retrieve-for-Train, который переносит «тяжёлые» рассуждения ИИ-поиска из момента самого запроса в разовое офлайн-обучение.
- Сначала обучением с подкреплением дообучают две открытые языковые модели на 4 млрд параметров, Gemma3-4B и Qwen3-4B, каждая учится выдавать ровно 10 подзапросов на один поисковый запрос.
- Это поведение дистиллируют в лёгкую диффузионную модель на 53,9 млн параметров: она выдаёт весь набор подзапросов за один параллельный проход, без пошаговых рассуждений.
- Результат, ускорение в 12, 20 раз: авторегрессионный подход на больших батчах растягивается почти до 50 секунд, а диффузионная версия укладывается в диапазон от долей секунды до нескольких секунд.
- На поиске модных образов по тексту и поиске музыки по тексту Retrieve-for-Train обошёл обычный поиск по одному запросу, zero-shot-расширение запроса и метод Best-of-N, точную величину отрыва авторы не назвали.
Почему это важно
Современные поисковые и рекомендательные системы всё чаще должны выдавать не один результат, а согласованный набор, вроде снаряжения для похода, где нужны палатка, спальный мешок, горелка и фонарь, а не десять похожих палаток. Обычный способ получить такой набор, веерное расширение запроса языковой моделью прямо во время поиска, и это дорого: модель должна на лету «подстроиться» под конкретную базу данных, а обычные модели для этого не заточены и тратят на рассуждения много вычислений и времени. Retrieve-for-Train показывает способ обойти этот компромисс: вместо того чтобы «думать» при каждом запросе, система один раз, офлайн, обучается с подкреплением находить хорошие наборы подзапросов, а затем это умение сжимается в маленькую диффузионную модель, которая работает почти мгновенно. Это пример более общей идеи: дорогое обучение с подкреплением можно использовать не как постоянно включённый механизм рассуждений, а как разовый инструмент, который один раз «компилирует» нужное поведение в маленькую и быструю модель.
Кому это важно
В первую очередь, командам, которые строят поиск и рекомендации с несколькими результатами сразу: интернет-магазинам и маркетплейсам, каталогам стриминговых сервисов, любым системам, где важен не один точный ответ, а дополняющий друг друга набор. Инженерам, которые уже используют «рассуждающие» языковые модели для расширения запросов в поиске или в RAG-системах и упираются в задержку и стоимость такого подхода на проде. Исследователям в области обучения с подкреплением и диффузионных моделей, как конкретный пример того, как поведение, полученное обучением с подкреплением, дистиллируется в маленькую и быструю модель. Командам, у которых уже есть поиск по эмбеддингам на базе моделей вроде CLIP или MuLan, метод рассчитан именно на такую инфраструктуру.
Как это применить
Retrieve-for-Train, исследовательский результат, а не выпущенный продукт или API: в посте не сказано, встроен ли метод в какой-либо продукт Google. Практический путь для заинтересованной команды, статья ICML 2026 «Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion», которая описывает рецепт целиком: дообучить открытую языковую модель обучением с подкреплением под составную награду (привязка к базе + соответствие запросу + разнообразие по метрике Vendi Score) методом GRPO с мягкой PPO-регуляризацией, а затем дистиллировать получившееся поведение в компактную диффузионную модель для инференса. Применимо это только там, где уже есть фиксированная база данных и мультимодальный (или любой другой) поисковый движок на эмбеддингах, без такой инфраструктуры с нуля метод не встанет.
Можно ли доверять
Источник, официальный блог Google Research, описывающий работу, принятую на ICML 2026, одну из ведущих конференций по машинному обучению с независимым рецензированием, что снижает риск случайных или недобросовестных результатов. При этом все цифры в посте, самоотчёт авторов: пост не называет точную величину отрыва Retrieve-for-Train от базовых методов (сказано только «превзошёл»), не раскрывает объём обучающих данных и вычислительный бюджет, а один из двух датасетов для оценки, закрытый корпус плейлистов, который, кроме авторов, никто проверить не может. Результаты получены на двух конкретных мультимодальных задачах (мода и музыка), независимого воспроизведения на других доменах в посте нет.
Риски и подводные камни
Метод хрупок к дизайну награды: сами авторы описывают, как без отдельного члена за разнообразие (метрика Vendi Score) модель схлопывается либо в бессмысленные строки, либо в повторяющиеся перефразировки запроса, то есть без точной настройки награды результат вырождается. Заявленное превосходство над базовыми методами не подкреплено точными цифрами, только качественными примерами и общим «превзошёл». Подход требует уже готовой инфраструктуры: фиксированной базы данных и мультимодальной модели эмбеддингов вроде CLIP или MuLan, это не инструмент «из коробки» для команды без такой базы. Проверка ограничена двумя доменами, модой и музыкой; перенос на другие типы данных, например на текстовый поиск или поиск по коду, в посте не показан. Наконец, это исследовательская публикация: данных о промышленном использовании, устойчивости к изменению базы данных со временем или поведении при обновлении корпуса без переобучения в посте нет.
«Мы показали, что обучение с подкреплением может быть очень эффективным, если использовать его как разовый «преобразователь цели» (objective transducer), а не как постоянно работающий механизм вывода.»
— Пэнчэн Цзян и Джудит Юэ Ли, Google Research