Редкие и релевантные, но неверные: как память подводит групповые решения нейросетей
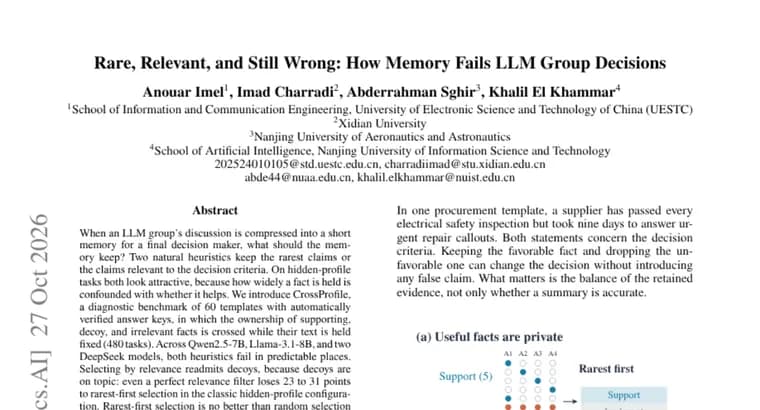
В статье разбирается вопрос: если обсуждение группы LLM-агентов сжимают в короткую память для финального «решающего» агента, что в неё стоит оставлять? Две естественные эвристики, хранить самые редкие утверждения либо утверждения, относящиеся к критериям решения. В задачах со скрытым профилем (hidden-profile) обе выглядят привлекательно, потому что распространённость факта в группе перепутана с его полезностью.
Чтобы развести эти два фактора, авторы вводят диагностический бенчмарк CrossProfile: 60 шаблонов с автоматически проверяемыми ключами ответов, всего 480 задач. В нём принадлежность подтверждающих, отвлекающих (decoy) и нерелевантных фактов скрещивается, а их текст остаётся неизменным. Проверка шла на Qwen2.5-7B, Llama-3.1-8B и двух моделях DeepSeek; на них обе эвристики ломаются в предсказуемых местах.
Отбор по релевантности возвращает в память отвлекающие факты, потому что они тоже «по теме»: даже идеальный фильтр релевантности проигрывает отбору «самое редкое, первым» от 23 до 31 пункта в классической конфигурации hidden-profile. При этом отбор «самое редкое, первым» в среднем не лучше случайного и выигрывает лишь там, где редкие факты случайно оказываются полезными. В обоих случаях точность определяется балансом улик, которые сохранила память, а не правилом, по которому их отобрали.
Третий сбой, на стороне модели, принимающей решение, и авторы называют его формой социального доказательства: она придаёт лишний вес фактам, приписанным многим агентам. Если убрать метки авторства или случайно переприсвоить их, не меняя порядок строк, точность в классической конфигурации растёт на 13-24 пункта. Наконец, в естественных дискуссиях улики теряются ещё до того, как начинает работать память: полная стенограмма даёт меньшую точность, чем отсутствие заметок вовсе.
Ключевые факты
- CrossProfile, диагностический бенчмарк из 60 шаблонов и 480 задач с автоматически проверяемыми ответами; принадлежность подтверждающих, отвлекающих и нерелевантных фактов скрещена при неизменном тексте.
- Проверка на Qwen2.5-7B, Llama-3.1-8B и двух моделях DeepSeek: отбор по редкости и отбор по релевантности ошибаются в предсказуемых местах.
- Даже идеальный фильтр релевантности уступает отбору «самое редкое, первым» на 23-31 пункт в классической конфигурации, а редкость в среднем не лучше случайного выбора.
- Решающая модель переоценивает факты, приписанные многим агентам; удаление или случайная перестановка меток авторства повышает точность на 13-24 пункта.
- В естественных дискуссиях полная стенограмма даёт меньшую точность, чем отсутствие заметок вообще.
Почему это важно
Многоагентные системы часто сжимают обсуждение в короткую сводку для финального решения, и интуитивные правила отбора (оставить редкое или релевантное) кажутся разумными. Работа показывает на контролируемом бенчмарке, что оба правила работают лишь потому, что в обычных задачах распространённость факта смешана с его полезностью. Главный вывод авторов: точность определяется балансом сохранённых улик, а не политикой отбора.
Кому это важно
Тем, кто строит системы из нескольких LLM-агентов, где итог обсуждения пересказывается отдельному агенту-арбитру, и тем, кто изучает коллективные решения моделей и их память. Это также материал для исследователей, которым нужен диагностический набор, разделяющий редкость, релевантность и принадлежность фактов.
Как это применить
Готового рецепта в тексте нет: предложенной политики памяти не названо, кроме наблюдения, что удаление или случайная перестановка меток авторства повышает точность в классической конфигурации. Практически из результатов следует проверить собственную систему на том, не придаёт ли решающая модель вес фактам просто из-за того, что их повторили несколько агентов, и не подтягивает ли фильтр релевантности отвлекающие факты.
Можно ли доверять
Это препринт на странице Hugging Face; в приведённом тексте авторы и организации не названы, дата не указана, сведений об открытом коде и данных нет. Результаты получены на небольших моделях (Qwen2.5-7B, Llama-3.1-8B и две модели DeepSeek) и на синтетическом бенчмарке, абсолютные уровни точности в тексте не приведены, только разницы в пунктах. Без полной статьи оценить методику и размер эффектов сложно.
Риски и подводные камни
Бенчмарк синтетический, а вывод про «потерю улик до работы памяти» в естественных дискуссиях подан без подробностей. Диапазоны 23-31 и 13-24 пункта даны без уточнения, по каким моделям и метрике они считаются. Нет данных о том, сохраняются ли эффекты на более крупных моделях, поэтому переносить выводы на любые системы рано.
«В естественных дискуссиях улики теряются ещё до того, как начинает действовать память: полная стенограмма даёт меньшую точность, чем отсутствие заметок вообще.»
— из аннотации статьи «Rare, Relevant, and Still Wrong: How Memory Fails LLM Group Decisions»