Разработчик создал новый формат packfile для Git на объектном хранилище
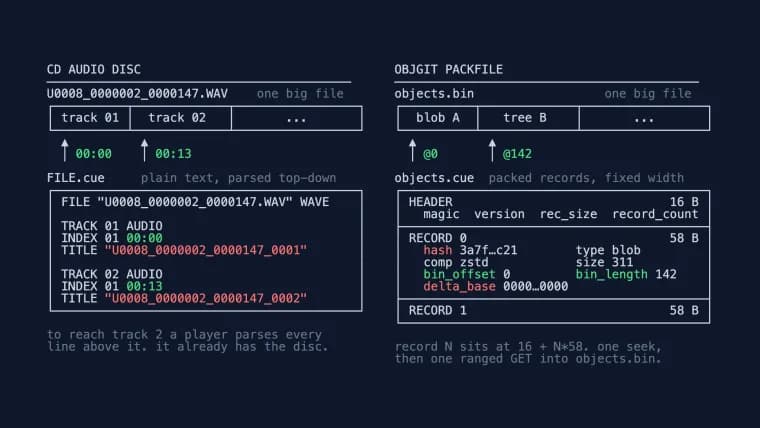
Автор строит открытый Git-сервер поверх объектного хранилища (проект objgit, использующий платформу Tigris). Первая идея была простой: подставить файловую систему как переходный слой поверх объектного хранилища, чтобы Git видел его как обычный диск. Этот подход работал «ну, вроде ничего», но ломался на репозиториях реального размера.
Причина, в устройстве packfile, формата, в котором Git упаковывает объекты (коммиты, деревья, блобы) в один файл вместо тысяч отдельных. Packfile проектировался под mmap и локальный диск: ядро подгружает страницы файла в память при обращении, и чтение с диска занимает порядка 10 наносекунд. Сетевой запрос к объектному хранилищу, не меньше 10 миллисекунд, то есть примерно в миллион раз медленнее. Для копии ядра Linux git count-objects -v показывает 11 827 138 объектов, упакованных в один файл размером 3,4 ГиБ; если бы пришлось запрашивать каждый объект отдельным вызовом по ~10 мс, выборка заняла бы больше часа.
Казалось бы, решение под рукой: у каждого packfile есть индекс со смещениями объектов, значит можно вытащить нужный объект HTTP-запросом Range на конкретный байтовый диапазон. Но индекс хранит только декомпрессированный размер объекта, а не компрессированный, то есть ровно тот размер, который нужен, чтобы правильно задать границы Range-запроса, в индексе просто отсутствует. Это, по словам автора, «половина причины», по которой пришлось делать собственный, специально заточенный под объектное хранилище формат packfile, колоночный (columnar) вместо привычного построчного.
Автор признаёт, что переписывать формат для хранения истории версий чужого кода, рискованный шаг («нарушение забора Честертона»), но указывает на особенность Git: при клонировании репозитория клиент забирает всю историю изменений целиком, что снижает цену ошибки формата на стороне сервера. Новый формат, по его словам, «на удивление хорошо» показал себя на репозиториях промышленного размера, и автор пока останавливается на нём как на текущем решении, не требующем никаких изменений на стороне git-клиента.
Ключевые факты
- Автор строит открытый Git-сервер поверх объектного хранилища (проект objgit на платформе Tigris)
- Первый подход, файловая система как переходный слой поверх объектного хранилища, не выдержал репозиториев реального размера: копия ядра Linux содержит 11 827 138 объектов в одном пакете на 3,4 ГиБ
- Стандартный packfile Git спроектирован под mmap и локальный диск: чтение с диска, около 10 наносекунд, сетевой запрос к объектному хранилищу, не меньше 10 миллисекунд, то есть примерно в миллион раз медленнее
- Индекс обычного packfile хранит декомпрессированный размер объекта, но не компрессированный, поэтому по нему нельзя корректно построить HTTP Range-запрос на нужный объект
- Автор написал собственный колоночный формат packfile, нативный для объектного хранилища; он «на удивление хорошо» показал себя на репозиториях промышленного размера и не требует изменений на стороне git-клиента
Почему это важно
Git изначально проектировался под локальный диск и mmap, а не под сетевые объектные хранилища. Автор поста замечает, что в последнее время сразу несколько компаний пытаются выпустить свой Git-продукт, и на конкретном инженерном случае показывает, почему это технически трудно: обычный формат packfile не даёт достаточно информации, чтобы забрать один объект из объектного хранилища одним запросом, а не гадая на глаз диапазон байт.
Кому это важно
Инженерам, которые строят Git-серверы или Git-совместимые сервисы поверх облачного объектного хранилища, разработчикам инфраструктуры распределённых систем контроля версий, а также командам с очень крупными репозиториями (в тексте, на примере ядра Linux), для которых упаковка объектов и скорость доступа к ним критичны.
Как это применить
Ключевая техническая находка: индекс стандартного packfile хранит декомпрессированный размер объекта, но не компрессированный, а значит по нему нельзя построить корректный HTTP Range-запрос к части файла в объектном хранилище. Автор решил проблему собственным колоночным форматом packfile, «нативным» для объектного хранилища; проект objgit, в рамках которого это сделано, открытый.
Можно ли доверять
Это личный инженерный отчёт автора о своей же системе, опубликованный в блоге Tigris, не независимый обзор и не рецензируемая публикация. Числа по копии ядра Linux и по собственному проекту автор приводит из вывода git count-objects -v на своей машине. Оценку «на удивление хорошо сработало для репозиториев промышленного размера» и итог сравнения скоростей автор не подкрепляет отдельным бенчмарком с методологией, это его собственная характеристика результата.
Риски и подводные камни
Автор сам называет переписывание формата хранения истории версий чужого кода «нарушением забора Честертона», рискованным решением менять то, что работает годами по не всегда очевидным причинам. В тексте не сказано, вышел ли новый формат packfile в стабильный релиз, был ли он влит в основной проект или остаётся экспериментальным, и нет независимого подтверждения выигрыша в производительности.
«Packfiles в Git проектировались под mmap и локальный диск, поэтому вытащить один объект из бакета, значит гадать на глаз диапазон байт.»
— автор поста в блоге Tigris