Qwen-3.8-27B дообучили методом Recursive Self-Rewrite на задачах для терминала
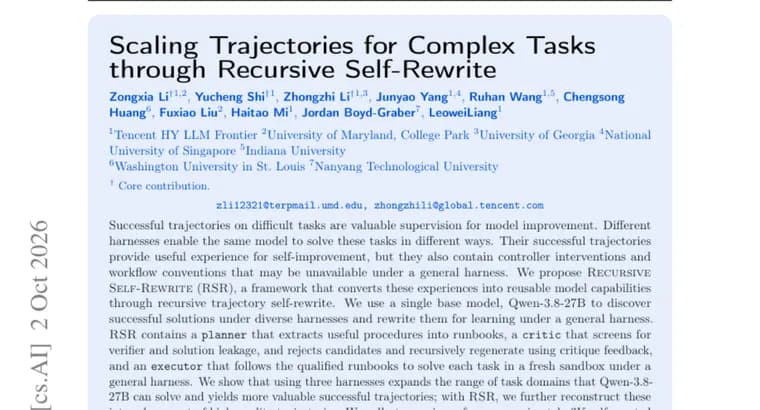
В статье предложен метод Recursive Self-Rewrite (RSR, «рекурсивное самопереписывание»). Исходная проблема, как её описывают авторы: удачные решения трудных задач дают ценный материал для обучения модели, но специализированные обвязки (harness, то есть агентные оболочки вокруг модели) добавляют вмешательства, которых может не быть при реальной работе модели.
В RSR используется одна базовая модель, Qwen-3.8-27B. Она находит успешные решения задач под разными обвязками, а затем восстанавливает их как обучающие траектории уже под одной общей обвязкой. Процесс разбит на три роли: планировщик (planner) выделяет процедуры и оформляет их в пошаговые инструкции (runbooks); критик (critic) проверяет, не просочились ли в них проверочный код или готовое решение, и направляет рекурсивную доработку; исполнитель (executor) выполняет прошедшие отбор инструкции в свежих песочницах.
Масштаб эксперимента: примерно 3 тысячи собранных самими авторами терминальных задач. Три обвязки вместе решают 759 из них, на 34,3% больше, чем сильнейшая отдельная обвязка из зафиксированного набора. RSR превращает 2001 успешную исходную траекторию в 11 094 переписанные траектории, на которых модель дообучают с учителем (supervised finetuning, SFT).
По словам авторов, обучение на таких траекториях превосходит и базовую модель, и прямое SFT на исходных траекториях. По сравнению с базовой моделью pass@3 вырос с 57,0% до 74,2% на Terminal-Bench 2, с 1,5% до 9,1% на Terminal-Bench 4, с 39,0% до 63,0% на собранном авторами Terminal-Bench Hard и с 3,0% до 6,0% на их же Software Terminal-Bench. Оценка процесса (process reward) на Long-Horizon Terminal-Bench поднялась с 0,21 до 0,29. Вывод авторов: разнообразный опыт, полученный с помощью разных обвязок, можно пересобрать в переиспользуемые навыки для модели, работающей под общей обвязкой.
Ключевые факты
- RSR использует одну модель Qwen-3.8-27B: она находит решения терминальных задач под разными обвязками и переписывает их под общую обвязку.
- Три роли в процессе: планировщик пишет пошаговые инструкции, критик отсекает утечки проверки и решения, исполнитель воспроизводит инструкции в свежих песочницах.
- Из 2001 успешной исходной траектории получено 11 094 переписанные для SFT; набор, около 3 тысяч задач, собранных авторами.
- pass@3 относительно базовой модели: Terminal-Bench 2, с 57,0% до 74,2%, Terminal-Bench 4, с 1,5% до 9,1%, Terminal-Bench Hard, с 39,0% до 63,0%, Software Terminal-Bench, с 3,0% до 6,0%.
- Три обвязки вместе решают 759 задач, на 34,3% больше, чем сильнейшая отдельная обвязка; process reward на Long-Horizon Terminal-Bench вырос с 0,21 до 0,29.
Почему это важно
Обучать агентов для работы в терминале на удачных решениях удобно, но решения, полученные со специальными обвязками, опираются на вмешательства, недоступные в реальном использовании. RSR предлагает способ перенести такой опыт под общую обвязку, не привлекая другую модель: всё делает одна Qwen-3.8-27B. Заявленный прирост на нескольких вариантах Terminal-Bench заметен, особенно на Terminal-Bench 2 (с 57,0% до 74,2% по pass@3).
Кому это важно
Исследователям и командам, которые дообучают модели-агенты для задач в терминале и разработки ПО, а также тем, кто собирает обучающие траектории из разных агентных оболочек. Работа интересна и тем, кто занимается самоулучшением моделей на собственных данных.
Как это применить
Напрямую применить пока нельзя: в описании не упомянуты ни код, ни выпуск модели или набора данных. Идею можно взять как схему: собрать успешные решения под разными обвязками, оформить их в пошаговые инструкции, отфильтровать критиком на утечки проверки и решения, воспроизвести в чистых песочницах и использовать результат для SFT.
Можно ли доверять
Все цифры, из аннотации статьи и заявлены самими авторами. Terminal-Bench Hard и Software Terminal-Bench, собранные авторами наборы; о Terminal-Bench 2 и Terminal-Bench 4 в тексте не сказано, внешние они или нет. Результаты сравнения с прямым SFT приведены только словами «превосходит», без чисел. Независимой проверки в источнике нет.
Риски и подводные камни
На Terminal-Bench 4 и Software Terminal-Bench абсолютные значения остаются низкими (9,1% и 6,0%), хотя прирост относительно базовой модели есть. Часть оценок получена на наборах, собранных самими авторами, поэтому сравнимость с другими работами ограничена. Названия трёх обвязок, глубина рекурсии и вычислительные затраты в источнике не указаны, так что оценить стоимость метода нельзя.