Представлена RynnWorld-Latent: видеомодель мира для разных роботов
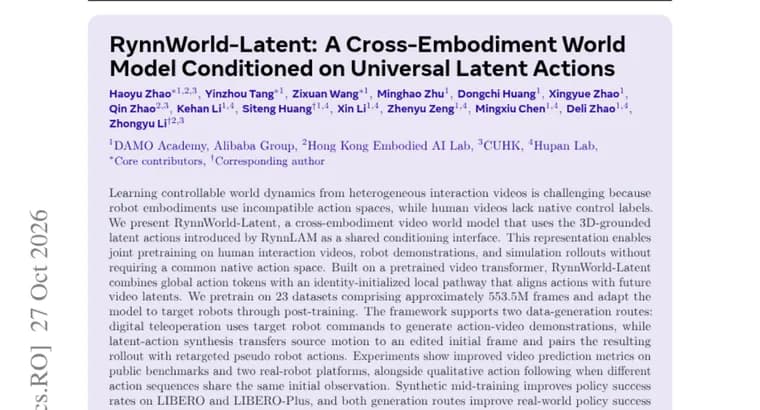
В статье представлена RynnWorld-Latent, кросс-воплощённая (cross-embodiment) видеомодель мира, то есть модель, предсказывающая, как будет меняться видеокартина под действиями разных роботов. Исходная проблема, по описанию авторов: у разных роботов несовместимые пространства действий, а у видео с людьми нет собственных управляющих разметок. Из-за этого трудно учить управляемую динамику мира на разнородных видео взаимодействий.
Решение, использовать как общий интерфейс условия 3D-привязанные скрытые (латентные) действия, введённые в RynnLAM. Такое представление позволяет совместно предобучаться на видео взаимодействий людей, демонстрациях роботов и симуляционных прогонах, не требуя единого родного пространства действий. Модель построена на предобученном видеотрансформере и сочетает глобальные токены действий с локальным путём, инициализированным как тождественное преобразование (identity-initialized), который выравнивает действия с будущими скрытыми представлениями видео.
Предобучение проводилось на 23 наборах данных общим объёмом примерно 553,5 млн кадров; затем модель адаптируют к целевым роботам дообучением (post-training). Фреймворк поддерживает два маршрута генерации данных. Цифровая телеоперация использует команды целевого робота, чтобы получать демонстрации «действие, видео». Синтез на скрытых действиях переносит исходное движение на отредактированный первый кадр и связывает полученный прогон с перенацеленными псевдодействиями робота.
По заявлению авторов, эксперименты показывают улучшение метрик предсказания видео на публичных бенчмарках и на двух реальных роботизированных платформах, а также качественное следование действиям, когда разные последовательности действий начинаются с одного и того же исходного наблюдения. Синтетическое промежуточное дообучение (mid-training) повышает долю успехов политик на LIBERO и LIBERO-Plus, а оба маршрута генерации улучшают успешность политик в реальном мире по сравнению с обучением только на реальных демонстрациях, в рамках проверенных условий. Вывод авторов: результаты поддерживают идею универсальных скрытых действий как масштабируемого интерфейса для обучения управляемой визуальной динамике у разнородных воплощений.
Ключевые факты
- RynnWorld-Latent, видеомодель мира для разных типов роботов; общим интерфейсом условия служат 3D-привязанные скрытые действия из RynnLAM.
- Предобучение, на 23 наборах данных, примерно 553,5 млн кадров: видео людей, демонстрации роботов и симуляция, без единого родного пространства действий.
- Два маршрута генерации данных: цифровая телеоперация и синтез на скрытых действиях с перенацеленными псевдодействиями робота.
- Авторы сообщают об улучшении метрик предсказания видео на публичных бенчмарках и двух реальных платформах и о росте успешности политик на LIBERO и LIBERO-Plus.
- Оба маршрута, по словам авторов, улучшают результаты политик в реальном мире относительно обучения только на реальных демонстрациях, но лишь в проверенных условиях.
Почему это важно
Роботам не хватает данных, а те, что есть, разбросаны по разным устройствам с несовместимыми командами. Работа предлагает общий «язык» скрытых действий, который позволяет использовать вместе видео людей, демонстрации роботов и симуляцию. Если подход масштабируется, как утверждают авторы, это путь к моделям мира, переносимым между разными роботами.
Кому это важно
Исследователям робототехники и моделей мира, командам, которые обучают политики управления роботами на разнородных данных, и тем, кто занимается синтетической генерацией демонстраций для роботов.
Как это применить
Напрямую применить пока нельзя: в описании не упомянуты код, веса или планы релиза. Практическая идея, два маршрута генерации данных (цифровая телеоперация и синтез на скрытых действиях) как способ дополнить реальные демонстрации синтетическими для целевого робота.
Можно ли доверять
Это препринт, а источник, его аннотация: все результаты приведены как заявления авторов. Числовых значений метрик и величины улучшений нет, конкурирующие модели не названы, поэтому оценить размер эффекта по этому тексту нельзя. Авторы и организации в тексте не указаны.
Риски и подводные камни
Улучшения реальных политик заявлены лишь «в проверенных условиях», так что обобщать их на других роботов рано. Формулировка авторов осторожная: результаты «поддерживают» идею универсальных скрытых действий, а не доказывают её. Название базового видеотрансформера и размер модели не раскрыты, воспроизвести результат по этому описанию трудно.