Представлена Queen: шахматная нейросеть на 4 млрд параметров объясняет свои ходы
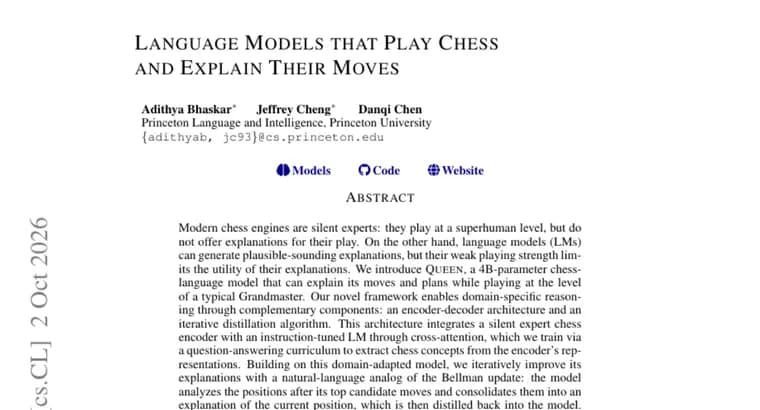
Современные шахматные движки играют на сверхчеловеческом уровне, но молчат: объяснить свою игру они не могут. Языковые модели, наоборот, умеют выдавать правдоподобные объяснения, но играют в шахматы слишком слабо, чтобы эти объяснения были полезны. Авторы статьи пытаются соединить два свойства и представляют Queen, шахматную языковую модель на 4 млрд параметров, которая, по их словам, объясняет свои ходы и планы и при этом играет на уровне типичного гроссмейстера.
Устройство системы состоит из двух частей. Первая, архитектура «кодировщик, декодировщик»: молчаливый экспертный шахматный кодировщик соединён с языковой моделью, дообученной на инструкциях, через перекрёстное внимание (cross-attention). Модель обучают по учебному плану из вопросов и ответов, чтобы она извлекала шахматные понятия из внутренних представлений кодировщика. Вторая часть, алгоритм итеративной дистилляции. Объяснения улучшают с помощью аналога обновления Беллмана, записанного на естественном языке: модель анализирует позиции, возникающие после её лучших ходов-кандидатов, сводит эти разборы в объяснение текущей позиции, и это объяснение затем «вдистиллируется» обратно в модель.
Результаты, которые приводят авторы: за семь итераций рейтинг модели вырос более чем на 900 пунктов Elo, с 1782 до 2697. По их утверждению, Queen существенно превосходит все передовые модели и по силе игры, и по точности решения шахматных задач, хотя параметров у неё на три порядка меньше. Оценка объяснений проводилась с помощью языковых моделей: по её итогам объяснения Queen беглые и по связности приближаются к GPT-5.6-Sol (high).
Наконец, авторы полагают, что общность архитектуры и процедуры обучения даёт рецепт для применения языковых моделей в областях, где есть молчаливые экспертные кодировщики, в играх, робототехнике и работе с компьютером. Это предположение: экспериментов в этих областях в описании не приводится.
Ключевые факты
- Queen, шахматная языковая модель на 4 млрд параметров, которая, по словам авторов, объясняет ходы и планы и играет на уровне типичного гроссмейстера.
- Архитектура: молчаливый экспертный шахматный кодировщик соединён с языковой моделью, дообученной на инструкциях, через перекрёстное внимание (cross-attention); обучение идёт по учебному плану из вопросов и ответов.
- Объяснения улучшаются итеративно с помощью аналога обновления Беллмана на естественном языке: разбор позиций после лучших ходов-кандидатов сводится в объяснение текущей позиции и дистиллируется обратно в модель.
- За семь итераций рейтинг Elo вырос более чем на 900 пунктов, с 1782 до 2697; авторы утверждают, что модель существенно превосходит все передовые модели по силе игры и точности решения задач при параметрах на три порядка меньше.
- По оценкам с помощью языковых моделей, объяснения беглые и по связности приближаются к GPT-5.6-Sol (high).
Почему это важно
Шахматные движки сильны, но не объясняют своих решений, а языковые модели объясняют, но играют слабо. Queen, попытка получить оба свойства в одной системе: по данным авторов, при размере 4 млрд параметров она сочетает игру на уровне типичного гроссмейстера с объяснениями ходов и планов. Если заявленное подтвердится, небольшая модель с экспертным кодировщиком может обходить заметно более крупные универсальные модели в узкой области.
Кому это важно
Исследователям, которые занимаются объяснимостью ИИ и обучением языковых моделей работе с экспертными системами. Также тем, кто следит за шахматным ИИ и за подходами к дистилляции. Авторы указывают на потенциальную применимость подхода к играм, робототехнике и работе с компьютером, но это предположение, а не показанный результат.
Как это применить
Практически применимого продукта в описании нет: выпуск весов, кода или демонстрации там не упоминается. Для исследователей полезна сама схема: соединить молчаливый экспертный кодировщик с языковой моделью через перекрёстное внимание, обучить её извлекать понятия из его представлений по учебному плану вопросов и ответов, а затем итеративно улучшать объяснения дистилляцией.
Можно ли доверять
Все данные взяты из аннотации статьи и являются заявлениями самих авторов. Не указаны ни шкала рейтинга Elo, ни соперники и условия измерения значений 1782 и 2697. Не названы передовые модели, которые Queen якобы превосходит (кроме GPT-5.6-Sol (high) как ориентира для связности), и не приведены числа по точности решения задач и по связности. Качество объяснений оценивалось с помощью языковых моделей: сообщается об их беглости и связности, но не о проверенной правильности.
Риски и подводные камни
Связность объяснения не гарантирует его верности: в описании отмечены только беглость и связность по оценке языковых моделей. Сравнение «превосходит все передовые модели» нельзя оценить, пока неизвестны список моделей и условия измерения. Перенос подхода на робототехнику и работу с компьютером пока лишь предположение авторов без экспериментов.