Представлена PDRVLA: VLA-модель для роботов учитывает физику без генерации видео
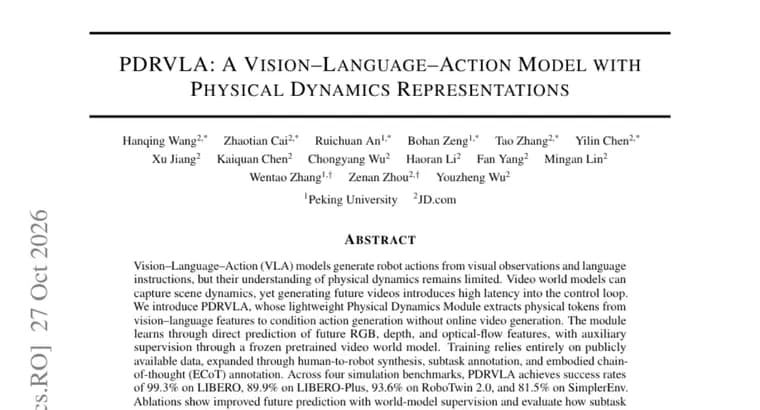
Модели «зрение, язык, действие» (VLA) строят действия робота по наблюдениям с камеры и текстовой инструкции, но, как отмечают авторы статьи, их понимание физической динамики остаётся ограниченным. Видео-модели мира умеют предсказывать, как будет меняться сцена, однако генерация будущих кадров добавляет высокую задержку в контур управления.
Авторы предлагают PDRVLA. В ней лёгкий Physical Dynamics Module (модуль физической динамики) извлекает «физические токены» из признаков, которые модель получает из изображения и текста. Эти токены служат условием при генерации действий, так что онлайн-генерация видео не нужна.
Модуль обучается напрямую предсказывать признаки будущих кадров: RGB, глубины и оптического потока. Дополнительный обучающий сигнал даёт замороженная (то есть не дообучаемая) предобученная видео-модель мира. Обучение целиком опирается на общедоступные данные, которые расширены тремя способами: синтезом данных «от человека к роботу», разметкой подзадач и разметкой воплощённой цепочки рассуждений (ECoT, embodied chain-of-thought).
На четырёх симуляционных бенчмарках PDRVLA показывает долю успешных выполнений 99,3% на LIBERO, 89,9% на LIBERO-Plus, 93,6% на RoboTwin 2.0 и 81,5% на SimplerEnv. Абляции (отключение отдельных компонентов) показывают, что надзор со стороны модели мира улучшает предсказание будущего. Кроме того, в них оценивается, как на успех действий влияют условие по подзадачам, надзор за будущими положениями объектов и обучение с ECoT.
Ключевые факты
- PDRVLA, VLA-модель для роботов с лёгким модулем физической динамики, который извлекает физические токены из признаков зрения и языка и условно направляет генерацию действий.
- Онлайн-генерация видео будущего не нужна: модуль учится предсказывать будущие признаки RGB, глубины и оптического потока, а замороженная видео-модель мира даёт дополнительный надзор.
- Обучение целиком на общедоступных данных, расширенных синтезом «человек, робот», разметкой подзадач и ECoT.
- Доля успеха в симуляции: 99,3% на LIBERO, 89,9% на LIBERO-Plus, 93,6% на RoboTwin 2.0, 81,5% на SimplerEnv.
- Абляции показывают улучшение предсказания будущего благодаря надзору со стороны модели мира.
Почему это важно
Идея в том, чтобы получить выгоду от понимания физики сцены, которое дают видео-модели мира, но не платить за него задержкой при управлении: по словам авторов, генерация будущих видео вносит высокую задержку в контур управления. PDRVLA заменяет её лёгким модулем, который работает с признаками, уже вычисленными моделью. Для управления роботом в реальном времени такой компромисс принципиален.
Кому это важно
Исследователям робототехники и разработчикам VLA-моделей, которые ищут способы добавить в политику управления знания о физической динамике. Также тем, кто собирает обучающие данные для роботов: в работе показано, как расширять общедоступные наборы синтезом «человек, робот», разметкой подзадач и ECoT.
Как это применить
Напрямую пока не применить: в тексте аннотации нет сведений о выпуске кода или весов. Практичнее всего взять идею для собственных экспериментов: добавить к VLA вспомогательную цель предсказания будущих признаков RGB, глубины и оптического потока и использовать замороженную видео-модель мира как дополнительный надзор, не запуская её при выполнении задач.
Можно ли доверять
Это научная статья со страницы Hugging Face Papers, пересказ опирается на её аннотацию. Все приведённые цифры получены на четырёх симуляционных бенчмарках; результатов на реальных роботах не упомянуто. Сравнения с другими моделями в тексте нет, поэтому оценить величину улучшения по этим числам нельзя. Цифры 99,3%, 89,9%, 93,6% и 81,5%, заявление самих авторов.
Риски и подводные камни
Высокие показатели в симуляции не гарантируют такого же качества на реальных роботах. Данных о задержке и скорости вывода нет, так что выигрыш по сравнению с подходами на генерации видео остаётся утверждением авторов. Размер модели, состав авторов и то, опубликован ли код, из аннотации не видно. Также в аннотации не указано, насколько именно абляции улучшают успех действий: заявлено лишь улучшение предсказания будущего.