Представлена OctLLM: нейросеть, которая читает 3D как октодерево
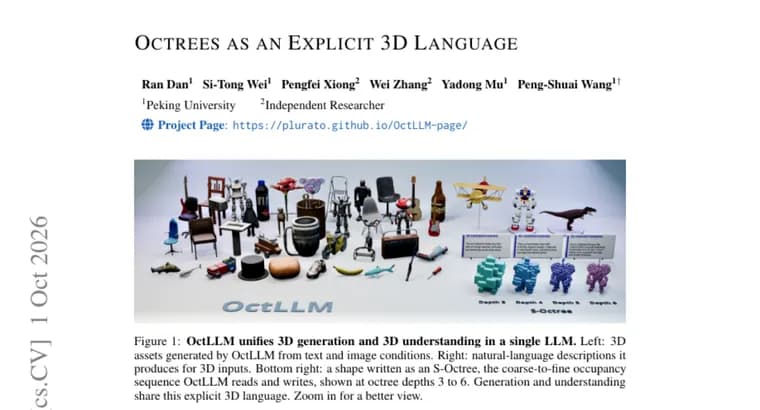
В статье представлена OctLLM, объединённая мультимодальная большая языковая модель, умеющая работать с 3D. Авторы исходят из того, что существующие 3D-модели страдают по двум причинам. Во-первых, они сжимают форму в индексы латентного словаря кодов (codebook) или в текст с координатами, и из-за этого модель не видит пространственную структуру. Во-вторых, 3D-модальность они осваивают дообучением основы модели, что затирает её общие языковые способности.
Первая проблема решается так: геометрия подаётся как явная трёхмерная последовательность токенов занятости октодерева. Полная последовательность октодерева быстро растёт с глубиной, поэтому OctLLM случайным образом опустошает узлы предпоследнего уровня и отбрасывает их потомков, сохраняя форму. Получается более короткое октодерево, привязанное к координатам и глубине, Sparse Octree (S-Octree). Его используют для генерации с маскированием, учитывающей позицию, и для понимания 3D.
Вторая проблема решается архитектурно. Полное дообучение дорого, LoRA ограничивает 3D-ёмкость, и оба способа меняют языковой тракт. OctLLM вместо этого добавляет 3D-способности в параметрах, отдельных от предобученных. Токены сетки (mesh) идут через независимые обучаемые ветви в части блоков, а токены текста и изображений остаются на замороженном тракте «зрение, язык». Два потока взаимодействуют через общее самовнимание.
По утверждению авторов, модель обучает намного меньше параметров, чем полное дообучение, но устанавливает новый рекорд среди объединённых мультимодальных LLM. По сравнению с ShapeLLM-Omni она снижает FID в задаче «изображение в 3D» на 17,4% и повышает результат в описании по рендерам (render-grounded captioning) на 28,7 пункта. При этом на общих языковых тестах OctLLM держится на уровне базовой модели.
Ключевые факты
- OctLLM подаёт 3D-геометрию в модель как явную последовательность токенов занятости октодерева, а не как индексы словаря кодов или координаты в тексте.
- Чтобы последовательность не росла слишком быстро с глубиной, предложено разреженное октодерево S-Octree: случайно опустошаются узлы предпоследнего уровня и отбрасываются их потомки, форма сохраняется.
- 3D-способности добавлены отдельными обучаемыми ветвями в части блоков; предобученный тракт «зрение, язык» заморожен, потоки связаны общим самовниманием.
- Относительно ShapeLLM-Omni: FID в задаче «изображение в 3D» ниже на 17,4%, описание по рендерам выше на 28,7 пункта.
- По утверждению авторов, на общих языковых тестах модель не уступает базовой, а параметров обучает намного меньше, чем при полном дообучении.
Почему это важно
Дообучение языковой модели новой модальностью часто портит то, что она умела раньше. Здесь предлагается способ добавить 3D, не трогая замороженный тракт «зрение, язык»: новые параметры живут в отдельных ветвях. Второе новшество, явное представление формы октодеревом вместо сжатия в индексы или текст с координатами, которое, по мнению авторов, лишает модель пространственной структуры.
Кому это важно
Исследователям мультимодальных моделей и 3D-генерации, а также командам, которые хотят научить готовую языковую модель новой модальности без потери общих навыков. Для широкого читателя это пока научный результат, а не продукт.
Как это применить
Из аннотации понятна идея архитектуры: разреженное октодерево на входе, отдельные обучаемые ветви для токенов сетки в части блоков, общее самовнимание между потоками. Для воспроизведения нужны детали, глубина октодерева, число параметров, данные, а в аннотации их нет. О релизе кода или модели там тоже не сказано.
Можно ли доверять
Это аннотация статьи на Hugging Face; все утверждения, слова самих авторов, независимой проверки в тексте нет. Абсолютные значения FID и шкала оценки описания по рендерам не приведены, поэтому 17,4% по FID лучше читать как относительное снижение относительно ShapeLLM-Omni (у FID меньше, лучше). В аннотации не названы ни авторы, ни базовая модель, ни тесты общего языкового сравнения.
Риски и подводные камни
Заявленный рекорд относится только к классу объединённых мультимодальных LLM и только в сравнении с ShapeLLM-Omni, которое названо в аннотации. Методика сжатия октодерева, случайное опустошение узлов, может по-разному вести себя на сложных формах, но проверить это по тексту нельзя. Утверждение «на уровне базовой модели» на общих языковых тестах тоже без цифр и названий тестов.