Представлен SciSlopBench: меры «научного слопа» находят ИИ-статьи в 85,9% пар
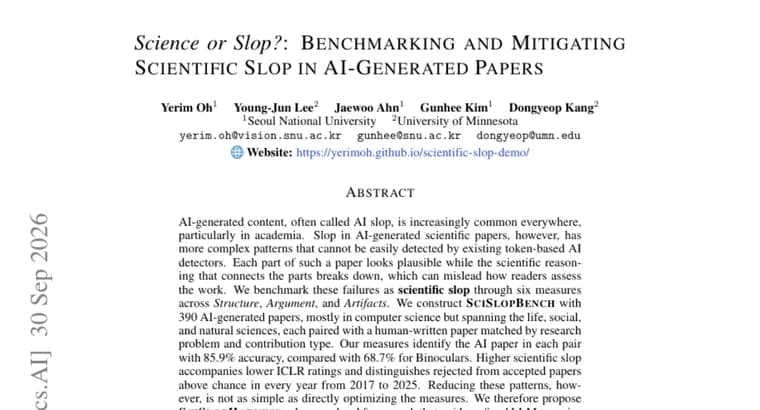
Статья на Hugging Face Papers (2610.00531) посвящена «научному слопу» (scientific slop), низкокачественному контенту в научных статьях, написанных ИИ. Исходная мысль такая: слоп в научных работах устроен сложнее, чем в обычных текстах, и существующие детекторы ИИ, работающие на уровне токенов, его легко не замечают. Каждая часть такой статьи выглядит правдоподобно, но научная логика, которая связывает части между собой, рушится, и это может ввести читателей в заблуждение при оценке работы.
Для измерения этих сбоев предложены шесть мер в трёх группах: структура (Structure), аргументация (Argument) и артефакты (Artifacts). Как именно определена каждая из шести мер, в тексте не раскрыто. Авторы собрали бенчмарк SciSlopBench: 390 статей, написанных ИИ, в основном по информатике, но с охватом наук о жизни, общественных и естественных наук. Каждая ИИ-статья поставлена в пару с человеческой, подобранной по исследовательской проблеме и типу вклада.
По результатам авторов, их меры определяют ИИ-статью в каждой паре с точностью 85,9%, тогда как детектор Binoculars справляется с этой же задачей с точностью 68,7%. Более высокий уровень научного слопа сопровождается более низкими оценками на конференции ICLR и отличает отклонённые статьи от принятых лучше случайного угадывания, в каждый год с 2017 по 2025.
При этом просто оптимизировать эти меры напрямую нельзя: так уменьшить слоп не получается. Поэтому авторы предлагают SciSlopHarness, каркас на уровне «обвязки» (harness), который направляет неизменную языковую модель так, чтобы она правила слоп только там, где изменение подкреплено записями экспериментов. Стандартные правки оставляют остаточный слоп, а прямой запрос с учётом слопа вызывает reward hacking (взлом функции вознаграждения: модель подгоняется под метрику, а не под суть). SciSlopHarness сокращает остаточный разрыв между ИИ и людьми на 63% по сравнению с сильнейшим базовым методом правки и не требует эталонных человеческих образцов.
Итог авторов: статьи, написанные ИИ, оставляют фундаментальные следы в глобальной логике рассуждения, а ответственное смягчение проблемы требует строгой опоры на доказательства, а не простой шлифовки стиля.
Ключевые факты
- SciSlopBench: 390 написанных ИИ статей, в основном по информатике, но также по наукам о жизни, общественным и естественным наукам; каждая в паре с человеческой статьёй с той же проблемой и типом вклада.
- Шесть мер научного слопа в группах «Структура», «Аргументация» и «Артефакты» определяют ИИ-статью в паре с точностью 85,9% против 68,7% у детектора Binoculars.
- Более высокий слоп сопутствует более низким оценкам ICLR и отличает отклонённые статьи от принятых лучше случайного в каждый год с 2017 по 2025.
- Прямая оптимизация мер не работает: стандартные правки оставляют слоп, а запрос с учётом слопа вызывает reward hacking.
- SciSlopHarness правит слоп только там, где изменения подкреплены записями экспериментов, и сокращает остаточный разрыв между ИИ и людьми на 63% относительно сильнейшего базового метода.
Почему это важно
ИИ-тексты всё чаще попадают в науку, а привычные детекторы ищут следы на уровне токенов. Авторы утверждают, что в научных статьях проблема глубже: отдельные части выглядят убедительно, но связывающее их рассуждение разваливается, и читатель может неверно оценить работу. Работа предлагает измерять именно эту «глобальную» слабость, структуру, аргументацию и артефакты, а не стиль. Кроме того, она показывает связь такого слопа с отклонением статей на ICLR.
Кому это важно
Рецензентам и программным комитетам конференций, редакторам журналов, исследователям, которые используют ИИ при написании статей, и разработчикам детекторов ИИ-текста и ИИ-инструментов для науки. Также тем, кто строит системы автоматического написания статей: работа указывает, на что такие системы будут проверять.
Как это применить
Из текста видно две идеи. Первая: сравнивать статью с парной человеческой по структуре, аргументации и артефактам, а не по стилистике. Вторая: если ИИ правит черновик, привязывать каждое изменение к записям экспериментов, а не просить модель просто «убрать слоп». Доступны ли код, данные и бенчмарк, в тексте не сказано, поэтому воспроизвести подход по этому описанию нельзя.
Можно ли доверять
Пересказ основан только на аннотации статьи, а все цифры (85,9%, 68,7%, 63%), результаты самих авторов на их собственном бенчмарке. В тексте не названы модели, которые написали 390 статей, и модель, которую использует SciSlopHarness; не названа и «сильнейшая базовая методика правки», а каждая из шести мер не определена по отдельности. Для результата по ICLR дано лишь «лучше случайного», без размера эффекта. Независимой проверки в тексте нет.
Риски и подводные камни
Бенчмарк в основном состоит из статей по информатике, поэтому перенос на другие науки не гарантирован. 63%, это сокращение остаточного разрыва между ИИ и людьми, а не абсолютная точность. Сами авторы отмечают, что прямая оптимизация мер приводит к reward hacking, то есть метрики легко «обмануть». Связь слопа с низкими оценками ICLR показана как сопутствие, а не как доказанная причина отклонения.
«Каждая часть такой статьи выглядит правдоподобно, тогда как научное рассуждение, которое связывает эти части, разваливается, что может ввести читателей в заблуждение при оценке работы.»
— из аннотации статьи