Представлен OpenVLHarness: инструменты и память добавляют мультимодальным нейросетям 9,7-12,6 пункта
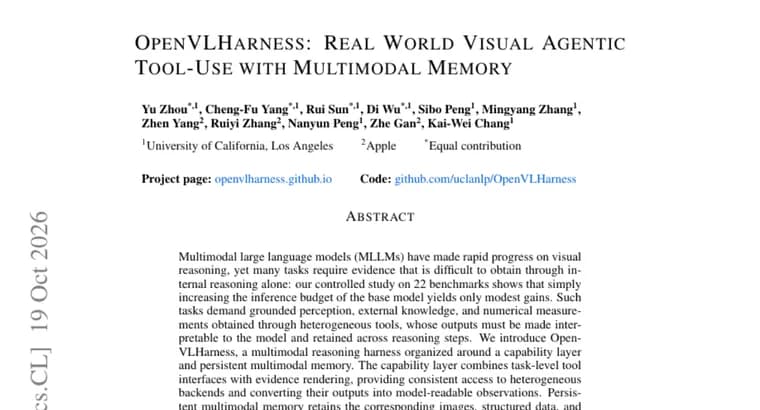
В препринте на Hugging Face представлен OpenVLHarness, мультимодальная «обвязка» для рассуждений (reasoning harness), построенная вокруг слоя возможностей и постоянной мультимодальной памяти. Исходная посылка авторов: мультимодальные большие языковые модели быстро прогрессируют в визуальных рассуждениях, но многим задачам нужны свидетельства, которые трудно получить одними внутренними рассуждениями. По их контролируемому исследованию на 22 бенчмарках, простое увеличение вычислительного бюджета на этапе вывода у базовой модели даёт лишь скромный прирост. Такие задачи требуют привязанного к изображению восприятия, внешних знаний и численных измерений, полученных через разнородные инструменты, причём результаты нужно сделать понятными модели и сохранять между шагами рассуждения.
Устройство системы. Слой возможностей сочетает интерфейсы инструментов на уровне задач с «рендерингом свидетельств»: он обеспечивает единообразный доступ к разнородным бэкендам и превращает их выходные данные в наблюдения, которые модель способна прочитать. Постоянная мультимодальная память хранит изображения, структурированные данные и веб-ссылки как адресуемые артефакты на протяжении всего запроса. Интерфейс программирования исполняет сгенерированные моделью программы над сохранёнными данными, что позволяет делать вычисления, объединяющие результаты нескольких инструментов. Всё вместе, по словам авторов, поддерживает итеративный процесс получения, проверки и компоновки мультимодальных свидетельств.
Результаты. Систему оценили на 22 бенчмарках с восемью открытыми и закрытыми базовыми моделями. OpenVLHarness повышает средние баллы на 9,7-12,6 пункта по сравнению с сопоставимыми базовыми вариантами без инструментов: в частности, +11,2 с Qwen3-VL-8B, +9,7 с Kimi K3 и +9,9 с GPT-6 Astra. Отдельное сравнение: с GPT-6 Luna при среднем уровне усилий на рассуждение OpenVLHarness опережает базовую модель, Codex и Visual Sketchpad, работающих на максимальном уровне усилий, на 7,7-8,5 пункта, при этом тратит не более 37% их затрат на токены модели.
Ключевые факты
- OpenVLHarness, мультимодальная обвязка для рассуждений: слой возможностей (интерфейсы инструментов плюс преобразование их выводов в понятные модели наблюдения) и постоянная мультимодальная память.
- Интерфейс программирования исполняет сгенерированные моделью программы над сохранёнными данными и объединяет результаты нескольких инструментов.
- На 22 бенчмарках с восемью открытыми и закрытыми базовыми моделями средний балл вырос на 9,7-12,6 пункта относительно сопоставимых вариантов без инструментов (+11,2 с Qwen3-VL-8B, +9,7 с Kimi K3, +9,9 с GPT-6 Astra).
- С GPT-6 Luna при среднем уровне усилий система опережает базовую модель, Codex и Visual Sketchpad на максимальном уровне на 7,7-8,5 пункта, расходуя не более 37% их токенов.
- По контролируемому исследованию авторов, простое увеличение бюджета вывода у базовой модели даёт лишь скромный прирост.
Почему это важно
Работа поднимает вопрос, насколько можно улучшить визуальные рассуждения, просто давая модели больше «времени на размышление». Авторы утверждают, что на 22 бенчмарках такой путь даёт лишь скромные результаты, а выигрыш приносит доступ к внешним инструментам и сохранение промежуточных свидетельств. Заявленная экономия, не более 37% токенов относительно сильных конкурирующих вариантов на максимальном уровне усилий, делает подход интересным и с точки зрения стоимости.
Кому это важно
Исследователям мультимодальных моделей и визуальных рассуждений, а также командам, которые строят агентов, работающих с изображениями, таблицами и веб-источниками и вынуждены решать, как хранить промежуточные данные между шагами и как объединять выводы разных инструментов.
Как это применить
Из аннотации можно взять архитектурную идею: единый слой доступа к разнородным инструментам, преобразование их вывода в читаемые моделью наблюдения, хранение изображений, структурированных данных и ссылок как адресуемых артефактов и исполнение сгенерированного кода над этими данными. Сведений о том, как получить или запустить систему, в тексте аннотации нет, поэтому практическое внедрение потребует знакомства с полной статьёй.
Можно ли доверять
Это препринт, а все цифры, собственные заявления авторов из аннотации. Абсолютные баллы базовых и итоговых вариантов не приведены, только прирост в пунктах; неизвестно также, какие именно 22 бенчмарка и восемь моделей участвовали (названы лишь Qwen3-VL-8B, Kimi K3, GPT-6 Astra и GPT-6 Luna). Диапазон 9,7-12,6 пункта относится к сравнению с вариантами без инструментов, а 7,7-8,5 пункта, к отдельному сравнению только для GPT-6 Luna. Оценка 37% токенов, верхняя граница и тоже только для этого случая. Независимой проверки в источнике нет.
Риски и подводные камни
Преимущество над базовой моделью, Codex и Visual Sketchpad показано в одном конкретном режиме (GPT-6 Luna, средний уровень усилий против максимального), и переносить его на другие модели без проверки нельзя. Размер «скромного прироста» от увеличения бюджета вывода в аннотации не указан, поэтому сила главного аргумента авторов оценивается только по полной статье. Для воспроизведения нужны инструменты и бэкенды, состав которых в аннотации не раскрыт.